❌

Normale Ansicht

Qwen 3.8 Flash Next auf Strix-Halo-Rechnern ausführen

09. Oktober 2026 um 12:02

Im Rahmen meiner Arbeit für unser Claude-Code-Buch habe ich wieder einmal durchgetestet, wie weit man mit lokalen Modellen und Open-Source-Tools kommt. Als Coding-Agent habe ich das Programm Pi verwendet, das ich demnächst hier näher vorstellen will. Pi habe ich zusammen mit diversen lokalen Modellen ausprobiert, unter anderem Gemma 4, Qwen-3.6-35b-a3b, Qwen-3.8-27b sowie Qwen-3.8-Flash-Next. Der Testrechner ist mit 128 GB RAM und einer Strix-Halo-CPU ausgestattet.

Um es kurz zu machen: Gemma 4 und Qwen-3.6-35b-a3b sind für agentisches Programmieren einfach zu schwach. Qwen-3.8-27b ist spürbar besser, aber als »dichtes« Modell (dense, immer alle Parameter im Einsatz) mit meiner Hardware definitiv zu langsam. Richtig spannend ist dagegen Qwen-3.8-Flash-Next! Es ist mit 125 Milliarden Parametern das größte und neueste Modell in meinem Testparcours. Dank MoE (Mixture of Experts) sind aber stets »nur« 6 Milliarden Parameter aktiv. Das Modell enthält außerdem eine Look-up-Tabelle für Token-Kombinationen mit weiteren 51 Milliarden Parametern (N-gram Embedding Layer). Die Gesamtmodellgröße wird daher oft mit 180 Milliarden Parametern angegeben. Der Platzbedarf beträgt bei 4-Bit-Quantisierung ca. 110 GB auf der SSD sowie ca. 90 GB im RAM (weniger, weil nur Teile der Look-up-Tabelle tatsächlich im RAM landen). Bei meinen Tests liefert das Modell bessere Ergebnisse als Qwen-3.8-27b und ist gleichzeitig schneller. Eine sehr angenehme Kombination.

Der Rest dieses Artikels beschäftigt sich mit der Frage, welche Möglichkeiten es gibt, Qwen-3.8-Flash-Next auf Strix-Halo-Rechnern auszuführen. Um es vorwegzunehmen: Mein für Testzwecke beliebtes LM Studio ist ungeeignet. Dafür gibt es zwei Projekte, die speziell für die AMD-CPU optimierte Engines anbieten und einen Output von über 40 Token/s erreichen.

LM Studio

LM Studio ist prinzipiell meine erste Wahl, um ein neues Sprachmodell erstmalig auszuprobieren. Tatsächlich gelingt damit die Ausführung von Qwen3.8-Flash-Next-GGUF mit ca. 24 Token/s. Das ist OK, aber weit weg vom theoretischen Maximum. Der Hauptgrund besteht darin, dass es mir (mit meiner Hardware) nicht gelungen ist, MTP zum Laufen zu bringen. Es gibt zwar auf Hugging Face mehrere Qwen-3.8-Flash-Next-Varianten mit inkludierten MTP-Daten, aber die eine Variante läuft gar nicht, bei der nächsten funktioniert MTP nicht und die Token-Rate sinkt auf 12 Token/s etc.

Die Ursache: Diverse Qwen-3.8-Flash-Next-Varianten setzen speziell gepatchte llama.cpp-Versionen voraus. Das Experimentieren damit ist eine Frickelei, die mich an die ersten Linux-Jahre zurückdenken lässt.

Erfreulicherweise gibt es einige Projekte, die sich darauf spezialisiert haben, moderne Sprachmodelle auf Strix-Halo-Hardware bestmöglich auszuführen. Einen guten Überblick gibt dieses YouTube-Video von Donato Capitella. Ich konzentriere mich hier auf Gufo und Halogen.

Gufo

Das Open-Source-Projekt Gufo will einen einfachen Weg anbieten, speziell für die Strix-Halo-CPU optimierte Engines und Sprachmodelle so zu kombinieren, dass diese mit minimalem Aufwand installiert und so effizient wie möglich ausgeführt werden können.

Die Projektseite enthält Anleitungen, wie Gufo als Podman-Container ausgeführt oder mit nix lokal installiert und kompiliert werden kann. Ich habe mich für die Podman-Variante entschieden und setze dieses Container-System im Folgenden voraus. (Unter Fedora ist Podman per Default installiert.)

Die folgenden Kommandos kombinieren Infos aus dem Gufo-Quickstart und dem Qwen-3.8-Flash-Next-Readme mit ein paar Detailkorrekturen. Der Kontext ist auf die Maximalgröße eingestellt. --sessions 2 ermöglicht zwei parallele Sessions. Das kostet zusätzlichen Arbeitsspeicher; außerdem sind zwei parallele Sessions natürlich langsamer. Wenn Sie nur eine Session brauchen, ist --sessions 1 sicherer.

# hf-Kommando installieren
sudo dnf install python3-huggingface-hub

# aktuellen Benutzer zu den Gruppen render
# und video hinzufügen; wird erst in einer
# neuen Shell wirksam
sudo usermod -aG render,video "$USER"

# Arbeitsverzeichnis erstellen
mkdir ~/gufo
cd ~/gufo

# Qwen-3.8-Flash-Next herunterladen (ca. 110 GB); die Dateien
# landen in ~/gufo/models/qwen3.8-flash-next
hf download unsloth/Qwen3.8-Flash-Next-GGUF \
  --revision 38bb39ee97821de2c9009abb7e93950eec396e66 \
  --include "UD-Q4_K_XL/*" \
  --include "MTP/mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf" \
  --include "mmproj-BF16.gguf" \
  --local-dir models/qwen3.8-flash-next

# Pfade zu den Modellen in Variablen speichern
export MODEL="$PWD/models/qwen3.8-flash-next/UD-Q4_K_XL/Qwen3.8-Flash-Next-UD-Q4_K_XL-00001-of-00004.gguf"
export MTP="$PWD/models/qwen3.8-flash-next/MTP/mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf"

# Gufo-Runtime-Image herunterladen (ca. 5,5 GB)
podman pull ghcr.io/gufo-org/toolboxes/gufo-runtime:latest

# LLM ausführen und auf Port 8080 anbieten
podman run --rm \
  --userns=keep-id:uid=1000,gid=1000 \
  --security-opt label=disable \
  --device /dev/kfd \
  --device /dev/dri \
  --group-add keep-groups \
  --ulimit memlock=-1 \
  -p 127.0.0.1:8080:8080 \
  -v "$(dirname "$(dirname "$MODEL")")":/models:ro \
  ghcr.io/gufo-org/toolboxes/gufo-runtime:latest \
  gufo serve --host 0.0.0.0 --port 8080 llm \
  --model "/models/UD-Q4_K_XL/$(basename "$MODEL")" \
  --speculative mtp \
  --mtp-model "/models/MTP/$(basename "$MTP")" \
  --sessions 2 \
  --context 262144

Mit curl können Sie ausprobieren, ob das Sprachmodell funktioniert:

curl -s http://127.0.0.1:8080/v1/chat/completions \
     -H "Content-Type: application/json" \
     -d '{
           "model": "Qwen3.8 Flash Next",
           "messages": [{"role": "user",
                         "content": "Write a Python function that checks if a string is a palindrome."}],
           "max_tokens": 1000,
           "reasoning_effort": "low"
         }' | jq -r '.choices[0].message.content'

  (Antwort gekürzt ...)
  # Palindrome Checker in Python
  def is_palindrome(s: str) -> bool:
      # Remove non-alphanumeric characters and convert to lowercase
      cleaned = ''.join(ch.lower() for ch in s if ch.isalnum())

      # Compare the string with its reverse
      return cleaned == cleaned[::-1]

Damit der Coding-Agent Pi das Sprachmodell verwendet, tragen Sie den Server in ~/.pi/agent/models.json ein:

{
  "providers": {
    "qwen-38-flash-next-gufo": {
      "baseUrl": "http://localhost:8080/v1",
      "api":     "openai-completions",
      "apiKey":  "not necessary",
      "models": [
        { "id": "Qwen3.8 Flash Next",
          "contextWindow": 262144 }
      ]
    }
  }
}

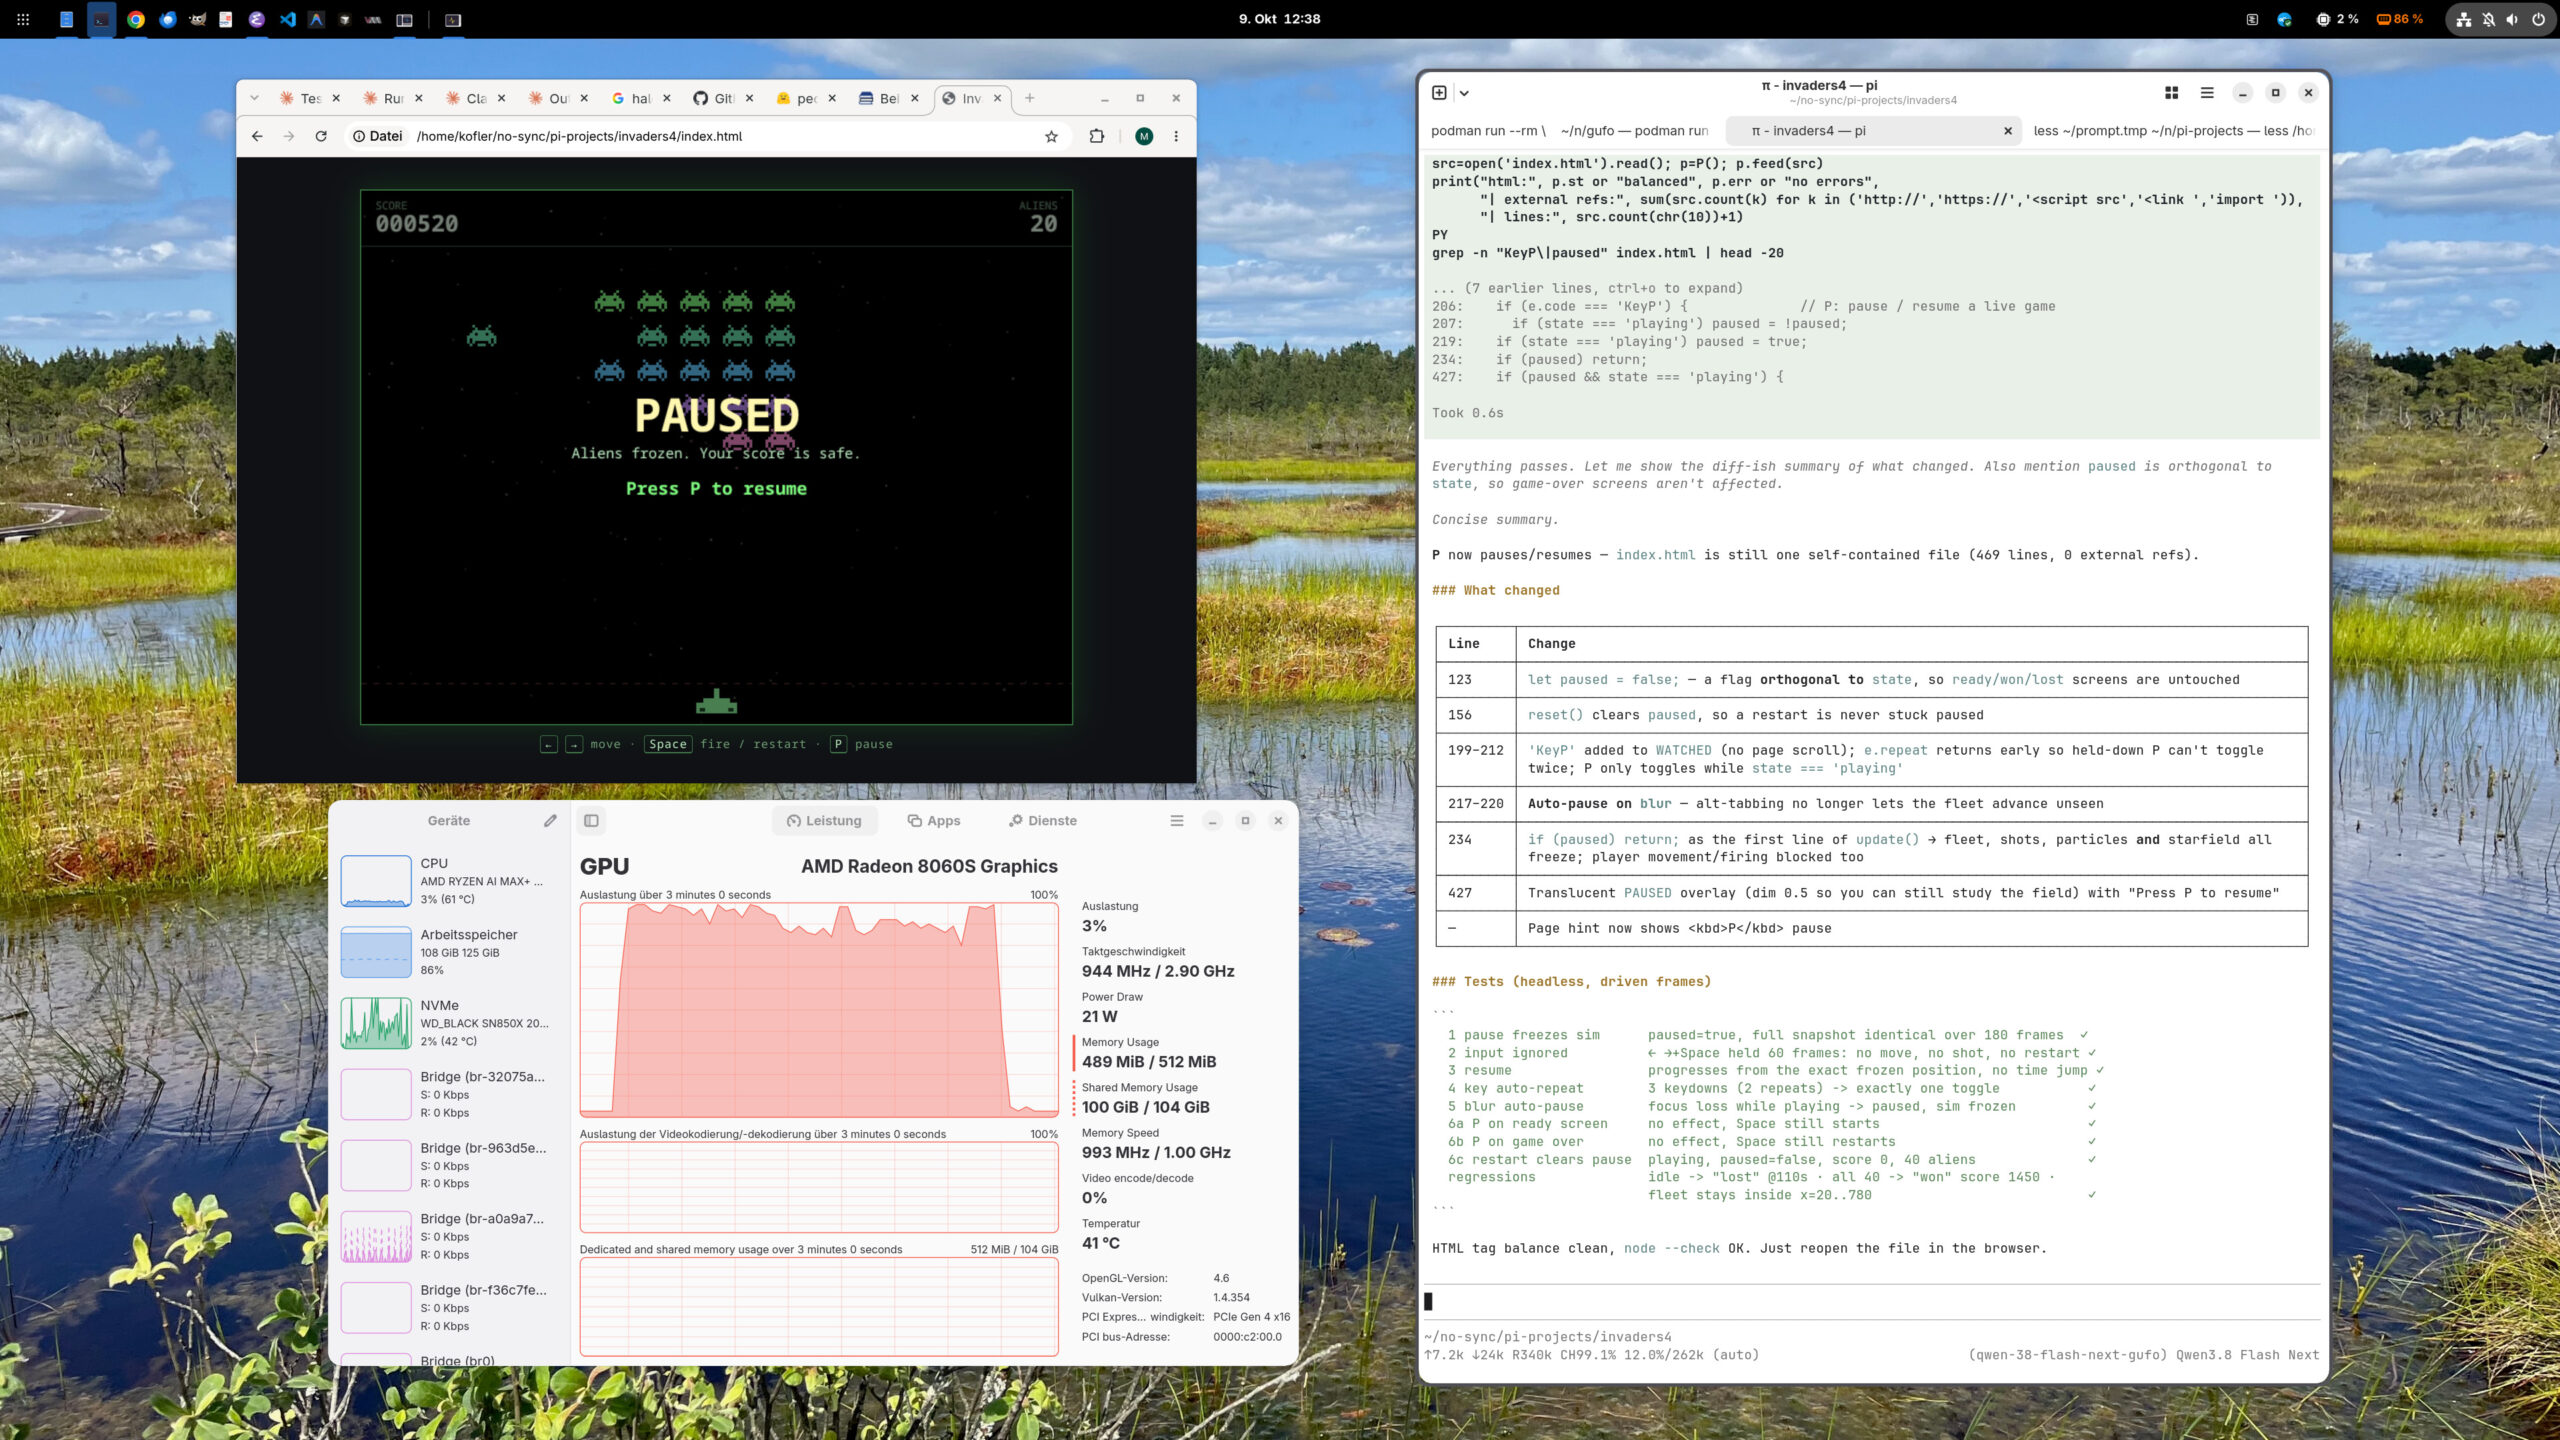
Als Test habe ich Pi aufgefordert, zuerst einen Space-Invaders-Klon zu programmieren und danach eine Pause-Funktion zu implementieren. Dazu waren diese beiden Prompts und ca. 10 Minuten Geduld erforderlich. Der Terminal-Tab mit dem Podman-Container protokollierte Output-Token-Raten zwischen 35 und 50 Token/s, meistens ca. 40 Token/s.

Create a browser game called Invaders in a single file index.html. Plain HTML, CSS and JavaScript, no frameworks, no build step, no dependencies. Use a canvas size of 800×600. The player controls a ship at the bottom edge with the left and right arrow keys and fires with the space bar. Five rows of eight aliens move sideways as a block, step down one row when they reach an edge, and disappear when a shot hits them. The game ends when all aliens are destroyed or an alien reaches the bottom row. Show the score in the top left corner. Do not start a web server.

Implement a pause key (P).

Der Screenshot zeigt links oben den Space-Invaders-Klon im Browser, der gerade mit dem Hinweis „PAUSED“ angehalten ist. Darunter ist die Systemüberwachung zu sehen, deren Diagramm für die GPU (AMD Radeon 8060S Graphics) während der Code-Generierung eine Auslastung von fast 100 % zeigt. Rechts fasst der Coding-Agent Pi im Terminal die Implementierung der Pause-Funktion zusammen und listet die Ergebnisse seiner Tests auf. Die Statuszeile nennt das verwendete Modell „Qwen3.8 Flash Next“.
Zwei Prompts und ca. 10 Minuten Geduld reichen aus, um einen spielfähigen Space-Invaders-Klon zu programmieren

Halogen

Der Halogen-Flash-Server ist in seiner Zielrichtung noch fokussierter. Als einziges Modell wird Qwen-3.8-Flash-Next unterstützt. Die Projektseite verspricht die höchste Token-Rate für dieses Modell auf Strix-Halo-CPUs. Der Nachteil: Teile der Software sind nicht Open Source und damit eine Black Box.

Die Installation bzw. Inbetriebnahme ist einfacher als bei Gufo. Auch Halogen setzt auf Podman. Ein einziges Kommando reicht aus, um das Halogen-Image und das Modell herunterzuladen. Weil Halogen eine anders optimierte Variante von Qwen-3.8-Flash-Next verwendet, ist neuerlich ein Download von über 110 GB notwendig (natürlich nur beim ersten Start). Das Modell wird in ~/halogen-models gespeichert. Die API verwendet standardmäßig den Port 8731. Halogen verwendet automatisch die maximale Kontextgröße (262.144 Token) und erlaubt vier parallele Sessions (einstellbar mit der Umgebungsvariablen HALOGEN_KV_SLOTS).

podman run --rm -p 127.0.0.1:8731:8731 \
  --device /dev/kfd --device /dev/dri --group-add keep-groups \
  --ipc=host --ulimit memlock=-1:-1 \
  -e HALOGEN_DOWNLOAD=peonist-ai/halogen-qwen3.8-flash-next \
  -v ~/halogen-models:/models \
  ghcr.io/peonist-ai/halogen-flash-server:0.17.3

Wiederum sollten Sie zuerst mit curl testen, ob alles funktioniert:

curl -s http://127.0.0.1:8731/v1/chat/completions \
     -H "Content-Type: application/json" \
     -d '{
           "model": "halogen-qwen3.8-flash-next",
           "messages": [{"role": "user",
                         "content": "Write a Python function that checks if a string is a palindrome."}],
           "max_completion_tokens": 4096,
           "reasoning_effort": "low"
         }' | jq -r '.choices[0].message.content'

Die Konfigurationszeilen für Pi sehen so aus:

{
  "providers": {
    "halogen": {
      "baseUrl": "http://127.0.0.1:8731/v1",
      "api":     "openai-completions",
      "apiKey":  "halogen",
      "models": [
        { "id": "halogen-qwen3.8-flash-next",
          "contextWindow": 262144 }
      ]
    }
  }
}

Bei meinen Tests habe ich mit Halogen tatsächlich eine spürbar höhere Geschwindigkeit erreicht (Output zwischen 50 und 60 Token/s). Ich habe einen sehr simplen Benchmarktest durchgeführt und dazu die ersten 40 Aufgaben von HumanEval+ aus EvalPlus 0.3.1 mit Greedy-Decoding und reasoning_effort: low ausgeführt. Halogen brauchte 356 s (61,6 Tokens/s), Gufo 407 s (52,2 Tokens/s), also rund 12 % weniger Zeit bzw. 18 % mehr Durchsatz. Bei der Qualität lagen beide gleichauf: 39 von 40 Aufgaben mit den Original-Tests, mit den erweiterten Tests 37 (Halogen) bzw. 38 (Gufo). Der Test ist zu wenig spezifisch, um echte Qualitätsunterschiede für agentisches Coding festzustellen. Mir fehlt die Zeit, um weitere Tests laufen zu lassen. Immerhin lässt sich sagen: Beide Modelle tun, was sie sollen, und Halogen macht es ein wenig schneller.

Wenn Ihnen der Closed-Source-Black-Box-Charakter von Halogen egal ist, ist Halogen also eine gute Wahl und aktuell vermutlich der schnellste Weg, um Qwen-3.8-Flash-Next auf Strix-Halo-Geräten auszuführen. Gegen das Projekt spricht neben dem fehlenden Quellcode der Umstand, dass keine anderen Sprachmodelle unterstützt werden.

Fazit

Es ist immer wieder überraschend, wie viel Bastelarbeit erforderlich ist, um moderne Sprachmodelle mit offenen Gewichten tatsächlich auszuführen. (Um es noch einmal zu betonen: »Freie« Sprachmodelle sind nicht mit Open-Source-Software zu vergleichen. Zwar ist bei vielen derartigen Modellen immerhin dokumentiert, wie die Gewichte zustande kommen; die Basis des Modells, insbesondere die Trainingsdaten und die genauen Trainingsbedingungen, ist aber nicht zugänglich.)

Um die positiven Aspekte zu nennen: Die real erzielbaren Ergebnisse lokaler Modelle werden von Monat zu Monat besser. Das in diesem Beitrag vorgestellte Modell ist ein gutes Beispiel dafür. Qwen-3.8-Flash-Next schlägt sich in Benchmark-Tests ausgezeichnet. In Kombination mit einer dafür optimierten Engine sind die erzielbaren Token-Raten so hoch, dass ein produktives Arbeiten auf Consumer-Hardware möglich ist.

Die Qualität, Geschwindigkeit und Kontextgröße lokaler Modelle auf Consumer-Hardware kommen natürlich bei weitem nicht an die kommerziellen Modelle auf Cloud-Servern von OpenAI oder Anthropic heran; aber je nach Aufgabenstellung sind freie Modelle mittlerweile gut genug für praktische Arbeiten, z.B. zur Software-Entwicklung mit dem CLI Pi. Das sind gute Nachrichten für alle, die sich Unabhängigkeit und Datenschutz wünschen.

Ehrlicherweise muss ich sagen: Ein Claude-Pro-Abo kostet auch über Jahre gerechnet viel weniger als die für diese Tests erforderliche Hardware. (Mein Testrechner hat Ende 2025 knapp 2500 € gekostet. Mittlerweile ist der Rechner leider fast doppelt so teuer.) Gleichzeitig bieten Claude Code, Codex, Vibe CLI oder andere kommerzielle Angebote mehr Komfort, eine viel höhere Coding-Geschwindigkeit und natürlich, und das ist am wichtigsten, eine deutlich höhere Coding-Qualität. Wenn ich es mir aussuchen darf, werde ich für professionelle Software-Entwicklung also weiter bei den kommerziellen Anbietern bleiben.

Quellen/Links

Gufo

Halogen

Microsoft gibt WSLC frei: Linux-Container erhalten neue Basis unter Windows

Von: MK
09. Oktober 2026 um 06:00

Microsoft hat WSLC offiziell freigegeben. Die neue Funktion ermöglicht den Betrieb von Linux-Containern unter Windows und soll dabei stärker voneinander getrennte Umgebungen schaffen. Nach der öffentlichen Vorschau steht WSLC nun allgemein zur Verfügung. Im Mittelpunkt steht das neue Kommando wslc.exe. Damit lassen sich Linux-Container direkt unter Windows verwalten. Microsoft verfolgt dabei einen anderen Ansatz als […]

Der Beitrag Microsoft gibt WSLC frei: Linux-Container erhalten neue Basis unter Windows erschien zuerst auf fosstopia.

Gentoo sucht dringend neue Sponsoren für seine Infrastruktur

Von: MK
09. Oktober 2026 um 05:30

Gentoo ist bei seiner technischen Infrastruktur auf Unterstützung von außen angewiesen. Mehrere langjährige Sponsoren haben ihre Unterstützung eingestellt, weshalb die unabhängige Linux-Distribution nun nach neuen Partnern sucht, die Server, Rechenzentrumskapazitäten, virtuelle Maschinen oder finanzielle Mittel bereitstellen. Die source-basierte Distribution nutzt den Paketmanager Portage und betreibt verschiedene wichtige Dienste auf eigener Infrastruktur. Da Gentoo nur eine […]

Der Beitrag Gentoo sucht dringend neue Sponsoren für seine Infrastruktur erschien zuerst auf fosstopia.

KDE Linux könnte sich von Arch Linux lösen

Von: MK
09. Oktober 2026 um 05:00

KDE Linux könnte künftig auf eine eigene Basis statt auf Arch Linux setzen. Die noch im Alpha-Stadium befindliche Distribution erprobt dafür Apache BuildStream, mit dem sich das Basissystem direkt aus dem Quellcode erzeugen lässt. KDE könnte dadurch die Kontrolle über die verwendeten Komponenten verbessern und wäre weniger von den Entwicklungszyklen einer anderen Distribution abhängig. Obwohl […]

Der Beitrag KDE Linux könnte sich von Arch Linux lösen erschien zuerst auf fosstopia.

Mit Claude Code eine Linux-Prüfung korrigieren

08. Oktober 2026 um 13:06

Coding mit KI-Unterstützung ist mittlerweile für die meisten Entwickler gelebte Praxis. Weniger bekannt ist, dass CLIs wie Claude Code auch abseits der Programmierung ein großartiges Werkzeug sind: Mit CLIs können Sie per SSH Linux-Installationen administrieren, Backups überprüfen, Docker-Setups einrichten oder Mail-Server-Konfigurationen analysieren.

Darüber hinaus setze ich Claude Code seit einigen Monaten für die Korrektur meiner Linux-Prüfungen ein. In diesem Beitrag erkläre ich, wie das funktioniert und warum das für mich eines der überzeugendsten Beispiele für »agentische KI« abseits des Codings ist.

Ich konzentriere mich in diesem Artikel auf Claude Code und habe das Setup auch nur mit dieser CLI getestet. Aber prinzipiell sollte das Setup ebenso gut mit Codex, Vibe CLI, Pi oder jedem anderen KI-Tool funktionieren, das im Terminal läuft und mit einem ausreichend leistungsstarken Sprachmodell verbunden ist.

Linux-Administration mit Claude Code

Die größte Hürde bei der Systemadministration besteht darin, wie Claude Code root-Rechte erlangt. Der naheliegende Weg, die interaktive Eingabe des Passworts für sudo während einer Session, ist leider nicht vorgesehen. Es gibt mehrere Wege, diese Hürde zu umgehen:

  • SSH-Key: Sie führen Claude Code auf Ihrem Arbeitsrechner oder Notebook aus. Über einen SSH-Key kann sich Claude Code beim zu administrierenden System ohne Passwort als root anmelden und dort arbeiten. Für die Prüfungskorrektur habe ich mich für diese Variante entschieden.
  • sudo ohne Passwort: Sie installieren Claude Code auf dem Zielsystem und führen das Programm in einem gewöhnlichen Account aus. Dank einer Regel in /etc/sudoers.d/ kann Claude Code ohne interaktive Passwortangabe root-Rechte erlangen (z.B. ALL=(ALL:ALL) NOPASSWD: ALL). Dieser sudo-Zugang kann uneingeschränkt sein oder auf ausgewählte Kommandos limitiert werden.

  • Claude Code als root: Sie installieren Claude Code am Zielsystem und führen es dort direkt mit root-Rechten aus. Das widerspricht aber dem Grundprinzip, möglichst nie größere, interaktive Programme mit root-Rechten auszuführen.

Sicherheitstechnisch sind alle drei Varianten in etwa gleich schlecht. Die letzte Variante ist vermutlich die schlimmste. Für Test-VMs und Entwicklungsumgebungen sind die skizzierten Wege akzeptabel. Für echte (produktive) Server ist Variante 2 der am ehesten taugliche Kompromiss.

Mindestens ebenso wichtig ist der Arbeitsmodus. Seit Sommer 2026 gilt der Auto-Modus als Defaultmodus von Claude Code. Dabei entscheidet ein zweites Sprachmodell (der Classifier), welche Kommandos ohne Rückfrage ausgeführt werden dürfen. Beim Programmieren funktioniert das ausgezeichnet.

Für die Administration von Servern ist dieser Modus aber gefährlich. Der Classifier sieht nämlich nie die Ausgabe von Kommandos wie lsblk oder pvs. Er kann deshalb nicht überprüfen, ob /dev/vdb wirklich das neue, leere Disk-Image ist oder ob sich dort schon aktiv genutzte Partitionen befinden. Paradoxerweise gilt: Je präziser Sie Ihren Auftrag formulieren, desto weniger wird nachgefragt. Wenn Sie sich bei /dev/vdb1 vertippt haben: Pech gehabt!

Wenn Claude Code beim Coding falsch »denkt« und Sie per Git zurück zum vorherigen Stand Ihres Projekts gehen müssen, ist das ärgerlich. Sollte Claude Code hingegen versehentlich die falsche SSD Ihres Servers neu partitionieren, ist das ein Fehler, der nicht mehr gutzumachen ist. (Nun gut, Sie haben natürlich ein Backup! Aber der Arbeitstag ist vermutlich trotzdem verloren.)

Für administrative Arbeiten empfehle ich deswegen den manuellen Modus, in dem jede Dateiänderung und jedes Shell-Kommando bestätigt werden muss. Am besten richten Sie für Ihre Admin-Aufgaben ein eigenes Projektverzeichnis ein und verankern den Modus dort dauerhaft in .claude/settings.json, damit Sie die Aktivierung nicht vergessen können:

{
  "permissions": {
    "defaultMode": "manual"
  }
}

Der manuelle Modus ist mit vielen Rückfragen verbunden. Mit der Antwort Yes, and don’t ask again speichert Claude Code eine Freigaberegel in .claude/settings.local.json. Ein regelmäßiger Blick in diese Datei lohnt sich: Zu großzügig geratene Regeln bleiben sonst dauerhaft aktiv, umgekehrt lassen sich oft mehrere Regeln zu einer zusammenfassen (z.B. Bash(sudo du *)). Die goldene Mitte sind Setups, in denen Sie den manuellen Modus mit Allow-Regeln für harmlose Kommandos kombinieren.

Nie auf Produktivsystemen! In meiner Admin-Praxis bin ich begeisterter Claude-Code-Anwender. Aber meine rote Linie sind Produktivsysteme. Mir ist klar, dass die Wissensbasis von Claude Code breiter und tiefer ist als die jedes Linux-Admins, und ich lasse mich auch gerne beraten. Aber so wie sich ein junger Mitarbeiter erst Vertrauen erarbeiten muss, bevor er kritische Aufgaben selbstständig erledigen darf, so geht es mir auch mit Claude Code. Was das Coding angeht, habe ich dieses Vertrauen. Was die Linux-Administration betrifft: noch nicht im gleichen Ausmaß.

Meine Linux-Lehrveranstaltung

Ich unterrichte an der Fachhochschule JOANNEUM in Kapfenberg seit über einem Jahrzehnt Linux-Administration. Das ist eine sehr grundlagenorientierte Lehrveranstaltung: Benutzerverwaltung, Zugriffsrechte samt setuid und setgid, Administration des Dateisystems samt LVM, Netzwerk-Basics, Paketverwaltung, systemd, Logging, elementare Tools (find, tar etc.).

Sowohl während der Übungen als auch zur Prüfung erhalten alle Studentinnen und Studenten Zugang zu virtuellen Maschinen. Die Prüfung besteht darin, Admin-Aufgaben auszuführen. Beurteilt wird danach der Zustand der virtuellen Maschinen. Die Prüfung ist damit viel praxisnäher als ein Multiple-Choice-Test. Drei Beispiele für typische Aufgaben:

  • Richte auf /dev/vdb ein Physical Volume mit xxx MiB ein, füge es der Volume Group für das Root-Dateisystem hinzu und vergrößere dann das Logical Volume und das Dateisystem für /.
  • Richte die Benutzer Jack, Joe und Averall ein. Deren Accounts sollen nach 90 Tagen ablaufen. Sie haben Zugriff auf ein gemeinsames Verzeichnis /data/some-task. Jeder der drei soll dort neu erzeugte Dateien der beiden anderen lesen, bearbeiten, aber nicht löschen können. Richte das Verzeichnis entsprechend ein.
  • Sichere den SSH-Server mit Fail2ban ab.

Diese Prüfungs- bzw. Übungsaufgaben klingen beinahe wie Prompts! Bevor ich Claude Code mit der Korrektur der Prüfungen beauftragt habe, habe ich deswegen die Probe aufs Exempel gemacht: Ich habe eine zusätzliche virtuelle Maschine eingerichtet, Claude Code per SSH-Key Root-Zugang gegeben und ihm eine Prüfung übergeben, samt der Aufforderung, alle Aufgaben zu erledigen und die genaue Vorgehensweise in einer Datei zu protokollieren.

Weniger als zehn Minuten später war Claude Code fertig. Ich habe das Ergebnis kontrolliert: Alle Punkte! Die Studierenden haben 90 Minuten Zeit. Die volle Punkteanzahl erreicht praktisch niemand, nicht weil meine Prüfung so schwierig wäre (ist sie wirklich nicht!), sondern weil auch guten Admins Schlampigkeitsfehler unterlaufen, speziell unter (Prüfungs-)Stress.

Prüfungskorrektur bisher

Zur Korrektur musste ich bisher via SSH in jede virtuelle Maschine »hineinsehen« und den Zustand des Dateisystems, der Netzwerkkonfiguration, von installierten Paketen und Dateien analysieren. Ich habe dazu ein selbst geschriebenes Script verwendet, das per SSH für jede VM Kommandos wie cat /etc/fstab, lsblk, pvs, getfacl usw. ausführte und die Ergebnisse in einer Textdatei sammelte. Diese Textdatei (plus bei Unklarheiten ein direkter Login samt ein paar manuellen Kontrollen) war dann die Grundlage für meine Beurteilung.

Das hat funktioniert, war aber mühsam. Für Details musste ich trotzdem oft in die VM hinein. Und weil sich die Aufgaben von Prüfung zu Prüfung ändern, musste ich auch das Script jedes Mal anpassen. Damit nicht genug: Ich musste in einer Tabelle dokumentieren, welche Teilaufgaben erledigt wurden und welche Fehler dabei passiert sind, mir überlegen, wie viele Teilpunkte eine unvollständige Aufgabe wert ist, und schließlich die wichtigsten Dateien aus den virtuellen Maschinen archivieren, sodass ich meine Beurteilung zur Not später nachvollziehen und begründen kann. Jeder Schritt für sich ist einfach, aber in Summe kostete die Beurteilung jeder Prüfung eine Menge Zeit.

Prüfungskorrektur mit Claude Code

Mittlerweile sieht sich Claude Code die virtuellen Maschinen selbst an. Dazu habe ich ein Projektverzeichnis mit Unterverzeichnissen für die Prüfungsangaben (exams/), meine Unterrichtsunterlagen (teaching/) und die Protokolle der von Claude Code ausgeführten Kommandos (reports/) eingerichtet. Die Datei CLAUDE.md enthält ganz genaue Anweisungen, wie Claude Code die virtuellen Maschinen nach einer Prüfung analysieren soll. Die Idee sieht so ähnlich wie der folgende, stark gekürzte Prompt aus:

Exam evaluation

* You have root access to the VMs fh01.example.com to fh20.example.com.
* Each VM is the result of an exam according to exam-2026-06.md.
  You are to evaluate the exam.
* Prepare an ODS table with columns for each VM and rows for each
  task / subtask.
* For each VM evaluate the exam. First, make a backup of
  /root/.bash_history (backup file name: bash_history_<date_time>).
* Other than that, do not change anything! Only read/access/evaluate.
  Do not create or modify files, do not run configuration commands,
  do not fix errors. The VM should stay as much as possible in the
  state the student left it when finishing the exam.
* Insert the achieved points and comments on wrong or missing details
  into the ODS table.
* Make a backup of /etc, /root and /home/student, download it to the
  local machine and save it as archive-fh<nn>.tar.gz.

Damit die Punkteaufteilung für alle Teilnehmer konsistent ist, lasse ich Claude Code vorweg zu jeder Prüfung ein Bewertungsschema erstellen. Dieses kontrolliere ich und passe es fallweise an: Auch wenn eine Frage in fünf Aufzählungspunkten formuliert ist, sind die Punkte oft unterschiedlich zu gewichten, je nach Schwierigkeit und Zeitaufwand.

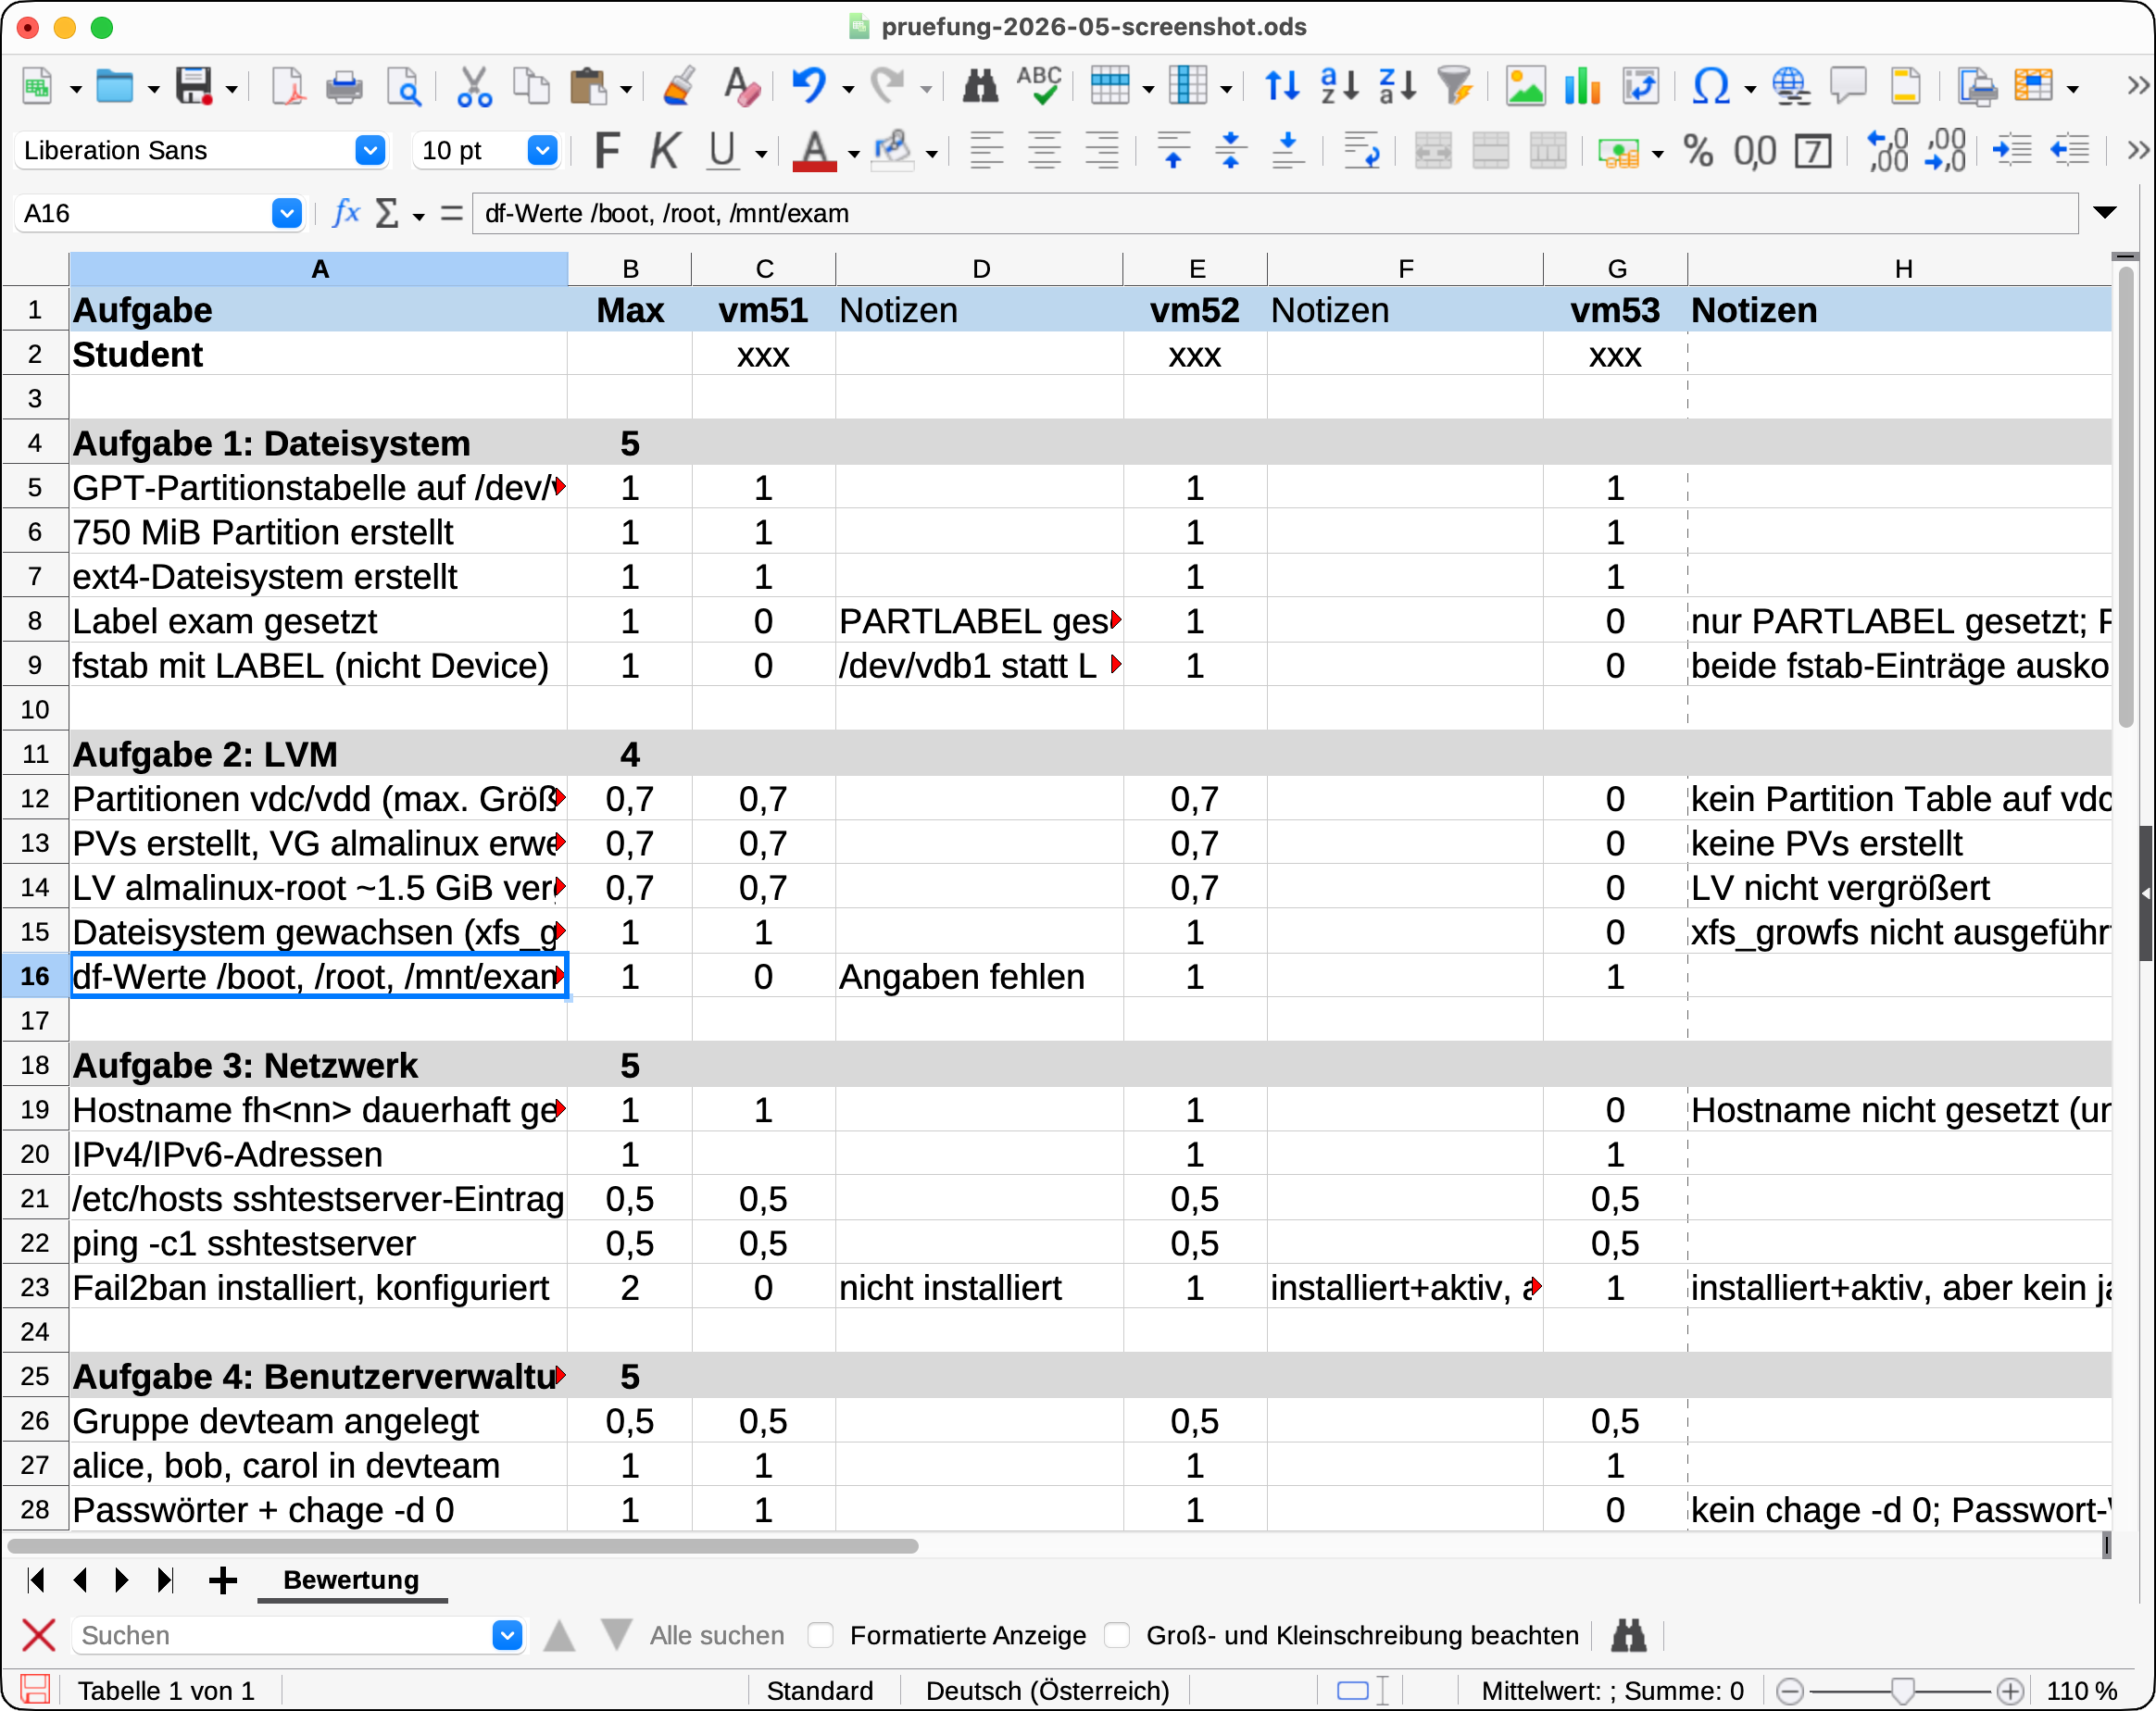
Ein großartiger Aspekt des Setups besteht darin, dass Claude Code die VMs nicht nur auswertet, sondern die Ergebnisse gleich in eine LibreOffice-Tabelle einträgt: Pro Prüfung/VM gibt es eine Spalte mit den Punkten und eine mit Kommentaren zu Fehlern oder fehlenden Details. Wenn ich mit einer Bewertung nicht einverstanden bin, ändere ich einfach die Punkte, die Summe wird automatisch neu berechnet. Um die ODS-Datei zu erzeugen, hat Claude Code ein kleines Python-Script geschrieben (mit dem Modul odfpy, installiert mit uv in einem lokalen Virtual Environment).

Der Screenshot zeigt eine LibreOffice-Calc-Tabelle mit den Prüfungsergebnissen. In der ersten Spalte stehen die Teilaufgaben, gruppiert nach Aufgaben wie „Aufgabe 1: Dateisystem“ oder „Aufgabe 2: LVM“, daneben die maximal erreichbaren Punkte. Für jede virtuelle Maschine (vm51, vm52, vm53) gibt es eine Spalte mit den erreichten Punkten und eine Spalte mit Notizen, z.B. „nicht installiert“ oder „xfs_growfs nicht ausgeführt“.
Die von Claude Code erzeugte Tabelle mit den Prüfungsergebnissen

Beim ersten Durchlauf habe ich die Ergebnisse von Claude Code mit einer älteren Prüfung verglichen, die ich zuvor manuell korrigiert hatte. Überwiegend kamen wir zu den gleichen Resultaten, aber nicht immer. Beispielsweise hat Claude Code nur die benutzerspezifische Crontab-Datei angesehen, nicht aber die systemweite (/etc/crontab). Dort befand sich die in der Prüfung geforderte Konfiguration. Claude Code hätte hier also fälschlich einen Punkt abgezogen. Solche Erkenntnisse lasse ich Claude Code in einer Anleitungsdatei festhalten, die in CLAUDE.md verankert ist. Claude Code hat dort einen Abschnitt Known gotchas angelegt, der mit jeder Prüfung ein wenig wächst.

Die Erstellung des ganzen Setups hat ca. vier Arbeitsstunden beansprucht, in etwa so lange, wie ich bisher für die manuelle Korrektur einer Prüfung gebraucht habe. Bei der ersten »echten« Korrektur hat Claude Code für sieben Teilnehmer ca. eine halbe Stunde gebraucht, geht also keineswegs blitzschnell vor. Laut /status hat die Korrektur ca. ein Drittel des Tagesbudgets meines Pro-Abos verbraucht.

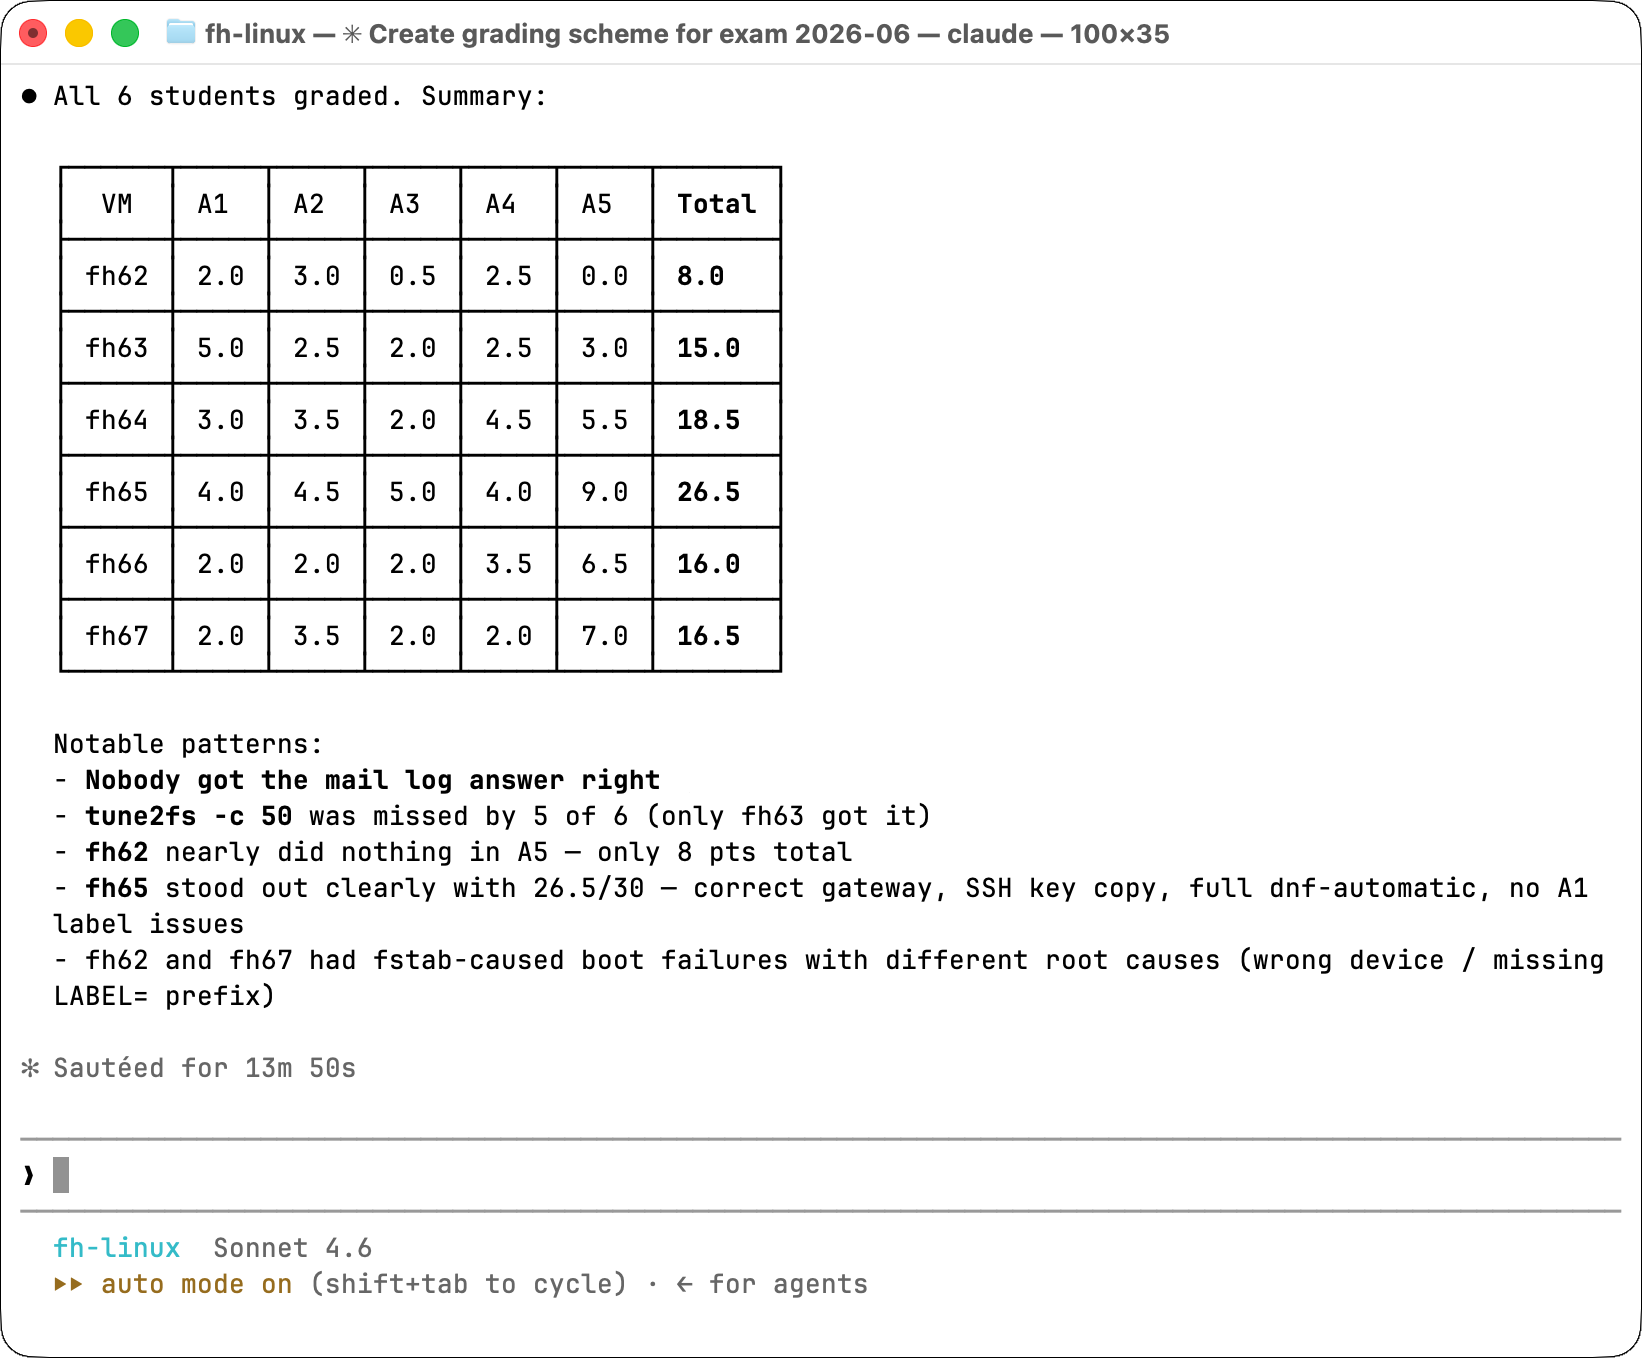
Der Screenshot zeigt ein Terminal mit Claude Code nach Abschluss der Korrektur („All 6 students graded“). Eine Tabelle listet für die VMs fh62 bis fh67 die Punkte der Aufgaben A1 bis A5 und die Gesamtpunkte zwischen 8 und 26,5. Darunter fasst Claude Code auffällige Muster zusammen, z.B. dass fast niemand `tune2fs -c 50` ausgeführt hat und zwei VMs wegen fehlerhafter fstab-Einträge nicht booten konnten.
Claude Code fasst die Ergebnisse von sechs Prüfungen übersichtlich zusammen. (Es handelt sich um eine andere Prüfung als beim ersten Screenshot. Die siebte Prüfung wurde vorweg einzeln korrigiert und scheint in der Zusammenfassung nicht auf.)

Fazit

Ganz ohne Handarbeit geht es nicht. Bei manchen VMs mit einer kaputten /etc/fstab-Datei muss ich diese zuerst reparieren, bevor die VM überhaupt bootet. Natürlich werfe ich nach der KI-Korrektur weiterhin einen Blick in jede virtuelle Maschine. Da und dort finde ich noch einen Punkt, wo mir Claude Code zu streng erscheint. (Ich handle eher nach der Richtlinie »Im Zweifel für den Angeklagten«.) Und in die endgültige Note fließen neben der Prüfung noch weitere Teilleistungen während des Semesters ein.

Was mir an diesem Setup so gut gefällt: Es nimmt mir den ungemein mühsamen Teil der Korrektur ab, das manuelle Auswerten jeder einzelnen VM. Das war in der Vergangenheit ebenso öd wie zeitaufwendig. Per KI-Hilfe verkleinert sich der Gesamtaufwand für die Korrektur etwa auf die Hälfte. Insbesondere muss ich nicht mehr für jede Prüfung ein neues Script zur Datensammlung schreiben: Claude Code liest die Prüfungsangabe und weiß selbst, wo es nachsehen muss.

Für mich ist das eines der besten Beispiele dafür, was »agentische KI« abseits des Codings in der Praxis bedeutet: Der Agent loggt sich selbstständig in beliebig viele VMs ein, führt dort Dutzende Kommandos aus, interpretiert die Ergebnisse im Kontext der Aufgabenstellung, vergibt Punkte, begründet Abzüge und schreibt alles in eine Tabelle. Ich kann Zusatzregeln angeben, dass mir z.B. die exakte Größe von Dateisystemen egal ist (alles im Bereich +/- 10 Prozent ist OK).

Ein angenehmer Nebenaspekt: Datenschutzprobleme gibt es keine. Claude Code erhält zu keinem Zeitpunkt die Namen meiner Studentinnen und Studenten. Der Agent sieht nur Linux-VMs mit Hostnamen wie fh<nn>.example.com. Die Zuordnung der VM-Nummern zu den Prüfungsteilnehmern erfolgt manuell durch mich.

Ist es für mich und meine StudentInnen nicht frustrierend, dass die KI auch bei der Linux-Administration besser ist als wir? Es ist wie beim Programmieren: Wir müssen uns mit neuen Realitäten arrangieren. Ich gebe zu, dass ich Claude Code und vergleichbare Tools noch nie auf produktiven Servern eingesetzt habe. So groß ist mein Vertrauen (noch) nicht. Für Testumgebungen, virtuelle Maschinen usw. ist es aber definitiv gut genug, auch zur Analyse »echter« Systeme. Sicher ist: So wie bei der Programmierung wird die KI auch in der Systemadministration viel verändern.

Bleibt die Frage nach dem richtigen Unterricht bzw. den richtigen Themen: Ist es noch zeitgemäß, tar-Optionen und LVM-Kommandos zu unterrichten? Ich habe mich immer gegen das Auswendiglernen gewehrt und erlaube meinen Studierenden, einen »Schwindelzettel« zur Prüfung mitzunehmen. Wichtiger als Detailwissen ist das Verständnis der Grundlagen. Was ist ein Dateisystem überhaupt? Warum gibt es unterschiedliche Dateisysteme? Was bringt LVM? Was ist der Preis? Wie kann ich LVM mit RAID kombinieren? Warum ist das sinnvoll?

Ich bin der Überzeugung, dass diese Grundlagen wichtig bleiben. KI-Tools werden uns (Systemadmins) manche öde Arbeit abnehmen. Aber so wie gute Programmierer mit KI bessere Ergebnisse erzielen als schlechte Programmierer, so werden gute Admins die KI sinnvoll anwenden, während schlechten Admins mehr Fehler unterlaufen. Die KI tut, was man ihr sagt, aber sie stellt den Auftrag selten in Frage. Wenn schon die Grundannahme falsch war, wird auch das KI-produzierte Ergebnis nicht aufregend ausfallen.

Zuletzt möchte ich noch auf zwei Videos von Florian Dalwigk verweisen. Er unterrichtet Ethical Hacking und hat mit Claude beim Pentesting/Hacking ähnliche Erfahrungen gemacht wie ich im Linux-Unterricht. Unsere Schlussfolgerungen sind vielleicht nicht ganz deckungsgleich, aber Sie werden viele Ähnlichkeiten erkennen …

Quellen/Links

Red Hat Lightwell: Sicherheitsupdates für alte Open-Source-Bibliotheken

Von: MK
08. Oktober 2026 um 06:00

Red Hat will mit Lightwell ein Problem lösen, das viele Unternehmen betrifft: Sicherheitslücken in alten Open-Source-Bibliotheken, die sich nicht einfach aktualisieren lassen. Statt auf einen Fix für die tatsächlich eingesetzte Version zu warten, bringt Lightwell Sicherheitskorrekturen direkt zurück in bestehende Bibliotheken. Nach Angaben von Red Hat basieren mehr als 90 Prozent des Codes in Unternehmensanwendungen […]

Der Beitrag Red Hat Lightwell: Sicherheitsupdates für alte Open-Source-Bibliotheken erschien zuerst auf fosstopia.

COSMIC und GNOME mit unterschiedlichen KI Strategien

Von: MK
08. Oktober 2026 um 05:30

System76 verschärft die Regeln für Beiträge zum Linux-Desktop COSMIC und verlangt ausdrücklich, dass eingereichter Code, Kommentare und Beschreibungen nicht von KI-Systemen erzeugt wurden. Damit steht das Projekt nicht allein: Auch verschiedene GNOME-Projekte schließen KI-generierte Beiträge aus. Innerhalb von GNOME gibt es allerdings die Forderung, zumindest von KI entdeckte Fehlerberichte zuzulassen. Die neuen Richtlinien von COSMIC […]

Der Beitrag COSMIC und GNOME mit unterschiedlichen KI Strategien erschien zuerst auf fosstopia.

Debian 14 „Forky“ sucht nach seinem passenden Look

Von: MK
08. Oktober 2026 um 05:00

Für Debian 14 mit dem Codenamen „Forky“ hat die Suche nach dem passenden Erscheinungsbild begonnen. Das Debian-Projekt lädt Künstler und Mitglieder der Community dazu ein, Vorschläge für das Artwork der kommenden Version einzureichen. Debian 14 soll voraussichtlich Mitte 2027 erscheinen. Das ausgewählte Motiv wird die visuelle Gestaltung von Forky an verschiedenen Stellen des Systems prägen. […]

Der Beitrag Debian 14 „Forky“ sucht nach seinem passenden Look erschien zuerst auf fosstopia.

GNOME 52 nimmt Entwicklung auf: Das sind die nächsten Meilensteine

Von: MK
07. Oktober 2026 um 06:00

Kaum ist GNOME 51 veröffentlicht, beginnt bereits die nächste Entwicklungsrunde. GNOME 52 trägt den Codenamen „Terengganu“ und soll am 17. März 2027 erscheinen. Erste konkrete Termine für den Entwicklungszyklus stehen bereits fest. Der Name geht auf den GNOME.Asia Summit 2026 zurück. Die Konferenz findet vom 31. Oktober bis 2. November in Kuala Lumpur statt. Mit […]

Der Beitrag GNOME 52 nimmt Entwicklung auf: Das sind die nächsten Meilensteine erschien zuerst auf fosstopia.

Linux auf M4-Macs: Erste Schritte im Kernel 7.4

Von: MK
06. Oktober 2026 um 06:00

Linux auf aktuellen Macs mit Apple Silicon bleibt eine technische Herausforderung. Nun gibt es jedoch einen ersten wichtigen Schritt für M4- und A18-Pro-Chips: Ein neuer Device Tree soll in Linux 7.4 aufgenommen werden und ermöglicht bereits das grundlegende Booten ausgewählter Geräte. Mit dem aktuellen Pull Request von Sven Peter aus dem Asahi-Linux-Umfeld hält die Unterstützung […]

Der Beitrag Linux auf M4-Macs: Erste Schritte im Kernel 7.4 erschien zuerst auf fosstopia.

Arch Linux 2026.10.01 ist da: Neue ISO bringt Linux 7.2.7 und Archinstall 4.5

Von: MK
05. Oktober 2026 um 05:30

Arch Linux 2026.10.01 steht als neue Installations-ISO bereit. Das Oktober-Abbild enthält die Paketaktualisierungen aus dem September. Zum Einsatz kommt dabei Linux 7.2.7. Die ISO bringt damit aktuelle Sicherheitskorrekturen und Fehlerbehebungen mit. Auch zahlreiche Pakete aus den Arch-Repositories wurden aktualisiert. Das neue Abbild richtet sich vor allem an Neuinstallationen. Bereits installierte Systeme benötigen keine neue ISO. […]

Der Beitrag Arch Linux 2026.10.01 ist da: Neue ISO bringt Linux 7.2.7 und Archinstall 4.5 erschien zuerst auf fosstopia.

Niederlande und Frankreich bauen auf NixOS für staatliche Arbeitsplätze

Von: MK
30. September 2026 um 07:30

NixOS gewinnt bei europäischen Behörden an Bedeutung. Die Niederlande entwickeln mit DAWO eine eigene digitale Arbeitsumgebung. Frankreich verfolgt mit Sécurix einen ähnlichen Ansatz. Beide Projekte setzen auf NixOS als technische Grundlage. In den Niederlanden steht dabei die digitale Unabhängigkeit im Mittelpunkt. DAWO steht für „Digitaal Autonome Werkomgeving Overheid“. Das Projekt soll eine vollständige Arbeitsumgebung für […]

Der Beitrag Niederlande und Frankreich bauen auf NixOS für staatliche Arbeitsplätze erschien zuerst auf fosstopia.

GNOME 49.10 ist da: Letztes Update vor dem Ende der 49er-Reihe

Von: MK
30. September 2026 um 06:00

GNOME 49.10 beendet die Entwicklung der 49er-Reihe. Das letzte Wartungsupdate bringt noch einmal zahlreiche Fehlerkorrekturen. Gleichzeitig endet damit der reguläre Upstream-Support für GNOME 49. Insgesamt wurden 14 GNOME-Komponenten aktualisiert. Dazu gehören GNOME Shell, Mutter, Epiphany und GNOME Maps. Auch GVfs, libadwaita, libsecret, Papers und Yelp erhalten neue Versionen. GNOME 51 ist inzwischen die aktuelle Generation. […]

Der Beitrag GNOME 49.10 ist da: Letztes Update vor dem Ende der 49er-Reihe erschien zuerst auf fosstopia.

Flatpak 1.18.4 schließt mehrere Sicherheitslücken

Von: MK
29. September 2026 um 06:00

Flatpak 1.18.4 steht als neues Wartungsupdate bereit. Die vierte Version der 1.18-Reihe erscheint nur wenige Tage nach dem Vorgänger. Diesmal stehen mehrere Sicherheitslücken im Mittelpunkt. Eine Schwachstelle konnte privilegierte Schreibzugriffe auf Dateien ermöglichen. Eine manipulierte Anwendung hätte dabei leere Dateien oder symbolische Verknüpfungen anlegen können. Betroffen war unter anderem der Pfad /run/host/monitor/resolv.conf. Flatpak behebt dieses […]

Der Beitrag Flatpak 1.18.4 schließt mehrere Sicherheitslücken erschien zuerst auf fosstopia.

openSUSE Leap 16.1: Release Candidate bringt neuen Immutable-Modus

Von: MK
29. September 2026 um 05:00

Der Release Candidate von openSUSE Leap 16.1 ist da. Die kommende Version erhält erstmals einen Immutable-Modus. Damit lassen sich Systeme mit schreibgeschütztem Root-Dateisystem betreiben. Auch bei den Desktopumgebungen gibt es Neuerungen. Die Entwicklung erfolgt parallel zu SUSE Linux Enterprise Server 16.1. Beide Systeme befinden sich nun in der Release-Candidate-Phase. Die Testversion bietet Gelegenheit, neue Funktionen […]

Der Beitrag openSUSE Leap 16.1: Release Candidate bringt neuen Immutable-Modus erschien zuerst auf fosstopia.

Fedora diskutiert Collabora Office als möglichen Ersatz für LibreOffice

Von: MK
28. September 2026 um 06:00

In der Fedora-Community sorgt derzeit eine ungewöhnlich lebhafte Diskussion für Aufmerksamkeit. Im Mittelpunkt steht die Frage, ob Collabora Office künftig LibreOffice als vorinstallierte Office-Suite ersetzen könnte. Eine formelle Entscheidung gibt es bislang nicht. Ausgangspunkt war ein Vorschlag im Fedora Discussion Forum. Der Initiator kritisiert vor allem die Oberfläche von LibreOffice. Auch Probleme mit komplexen Dokumenten […]

Der Beitrag Fedora diskutiert Collabora Office als möglichen Ersatz für LibreOffice erschien zuerst auf fosstopia.

GNOME 50.5 ist da: Wartungsupdate räumt zahlreiche Fehler aus

Von: MK
28. September 2026 um 05:00

GNOME 50.5 ist ab sofort verfügbar. Das Wartungsupdate behebt zahlreiche Fehler in der runden GNOME-Reihe. Insgesamt wurden 22 Komponenten aktualisiert. GNOME 51 ist inzwischen die aktuelle Hauptversion. Besonders umfangreich fallen die Änderungen bei GNOME Shell und Mutter aus. Die Shell behebt Probleme beim Wechsel zwischen Arbeitsflächen. Auch drahtlose Verbindungen und der Sperrbildschirm wurden verbessert. Hinzu […]

Der Beitrag GNOME 50.5 ist da: Wartungsupdate räumt zahlreiche Fehler aus erschien zuerst auf fosstopia.

Linux Coffee Talk 9/2026

Von: MK
26. September 2026 um 08:00

Der Linux Coffee Talk ist das entspannte Format rund um Linux, Open Source und Technik im Alltag. Ohne Hype und ohne unnötige Aufgeregtheit, dafür mit ehrlichen Einordnungen, persönlichen Meinungen und einem Überblick über die wichtigsten Linux- und FOSS-Themen aus dem September 2026. Wir sprechen über Distributionen, spannende Projekte, Datenschutz, praktische Werkzeuge und alles, was Linux-Nutzer […]

Der Beitrag Linux Coffee Talk 9/2026 erschien zuerst auf fosstopia.

Ubuntu beschleunigt Kernel-Updates

Von: MK
25. September 2026 um 06:00

Canonical stellt die Veröffentlichung von Ubuntu-Kernel-Updates um. Künftig laufen die regulären und sicherheitsbezogenen Aktualisierungen über einen gemeinsamen Zwei-Wochen-Zyklus. Durch die Überschneidung der Zyklen erscheint künftig damit jede Woche ein neuer Kernel. Der neue Ablauf beginnt mit der Vorbereitung des jeweiligen Kernel-Pakets. Canonical integriert Patches, erstellt die Pakete und führt erste Prüfungen durch. Anschließend landet der […]

Der Beitrag Ubuntu beschleunigt Kernel-Updates erschien zuerst auf fosstopia.

openSUSE Tumbleweed ARM bringt neue Kernel-, Firmware- und Treiber-Updates

Von: MK
25. September 2026 um 05:30

openSUSE hat seine ARM-Version von Tumbleweed umfassend aktualisiert. Die September-Snapshots bringen Linux 7.2.5 und zahlreiche neue Komponenten. Besonders Raspberry Pi, Rockchip, Qualcomm und NXP profitieren von den Änderungen. Neben dem Kernel wurde auch die GNU C Library auf Version 2.44 aktualisiert. QEMU erreicht Version 11.1.1 und erhält damit weitere Verbesserungen für ARM-Systeme. Auch GIMP 3.2.6 […]

Der Beitrag openSUSE Tumbleweed ARM bringt neue Kernel-, Firmware- und Treiber-Updates erschien zuerst auf fosstopia.

Flatpak 1.18.3 bringt wichtige Fehlerbehebungen

Von: MK
25. September 2026 um 05:00

Flatpak 1.18.3 steht als neues Wartungsupdate bereit. Die dritte Aktualisierung der 1.18-Reihe konzentriert sich auf Fehlerbehebungen. Auch zwei aktualisierte Sandbox-Komponenten sind enthalten. Ein Problem betraf den Start verschachtelter Sandboxes. Betroffen waren Apps mit bestimmten D-Bus-Berechtigungen. Flatpak behebt außerdem einen Absturz bei der Installation von Bundles. Dabei geht es um Bundles mit explizit angegebenen Schlüsselbytes. Weitere […]

Der Beitrag Flatpak 1.18.3 bringt wichtige Fehlerbehebungen erschien zuerst auf fosstopia.

SUSE baut um: Freiwilliger Abschied für langjährige Mitarbeiter

Von: MK
24. September 2026 um 05:30

SUSE befindet sich offenbar in einer Phase des Umbruchs. Der Linux-Anbieter bietet ausgewählten Mitarbeitern einen freiwilligen Austritt oder Vorruhestand an. Gleichzeitig verändert sich die Ausrichtung der Distributionen deutlich. Das Angebot richtet sich nach aktuellem Sachstand lediglich an berechtigte Beschäftigte. Dabei wird seitens HR der freiwillige Charakter betont. Konkrete Vorgaben für die Zahl der Ausscheidenden gebe […]

Der Beitrag SUSE baut um: Freiwilliger Abschied für langjährige Mitarbeiter erschien zuerst auf fosstopia.

❌