❌

Lese-Ansicht

Der Coding-Agent Pi — die Claude-Code-Antithese

Vor ein paar Wochen habe ich hier beschrieben, wie ich das Sprachmodell Qwen 3.8 Flash Next auf einem Rechner mit Strix-Halo-CPU und 128 GB RAM ausführe. Dort habe ich auch angekündigt, den Coding-Agenten Pi vorzustellen, mit dem ich das lokale Modell getestet habe: Pi ist so ziemlich das Gegenteil von Claude Code — minimalistisch, sparsam mit dem Kontext und gerade deswegen ideal für lokal ausgeführte Sprachmodelle.

Das Problem: Claude Code und lokale Modelle

Claude Code ist für mich aktuell das beste CLI-Coding-Tool. Das gilt aber nicht für das Zusammenspiel mit lokalen Modellen. Zwar lässt sich Claude Code über die Umgebungsvariable ANTHROPIC_BASE_URL mit LM Studio, llama.cpp & Co. verbinden, aber die Ergebnisse sind ernüchternd: Schon für einen Miniprompt wie »Can we talk?« vergehen je nach Modell Minuten, bis die erste Antwort erscheint.

Eine Ursache dafür ist das sogenannte Context Bloating. Claude Code schickt bei jedem Prompt einen riesigen Basiskontext mit. Wenn Sie in einer leeren Session nach »Can we talk?« das Kommando /context ausführen, zeigt Claude Code eine Kontextnutzung von 50k bis 60k Token an:

  • Der Systemprompt beansprucht ca. 10k Token. Das ist eine Grundanleitung, wie Claude Code agieren soll.
  • Ungefähr weitere 30k Token ergeben sich aus der Anleitung, wie der Agent Tools wie Bash, Edit, Read oder Write aufrufen soll.
  • Der Rest stammt von Skills, Plugins, MCP-Servern usw.

Bei den Anthropic-Modellen mit einem Kontextfenster von einer Million Token ist das (fast) vernachlässigbar. Ein lokales Modell mit einem Kontextfenster von 260.000 Token ist aber schon zu 20 bis 25 Prozent gefüllt, bevor Sie überhaupt etwas Sinnvolles gefragt haben. Und all diese Token müssen von Ihrer lokalen Hardware verarbeitet werden, die nun mal nicht mit Cloud-Rechenzentren mithalten kann. Manche Kritiker sprechen bei Claude Code deswegen nicht nur von Context, sondern auch von Feature Bloating.

Die Idee hinter Pi

Hinter Pi steckt Mario Zechner: Der Österreicher hat unter anderem das Game-Framework libGDX entwickelt. Als ihm Claude Code zu komplex und zu geschwätzig wurde, hat er kurzerhand einen eigenen Agenten geschrieben. Der Code steht unter der MIT-Lizenz und wird mittlerweile von der Organisation Earendil weiterentwickelt. Seit 1.10.2026 gibt es die Version 1.0, aktuell (Anfang November 2026) ist schon Version 1.5.

Die Grundidee lässt sich schnell zusammenfassen: Moderne Sprachmodelle wissen ohnehin schon, wie man eine Shell bedient, wie ein Git-Repository funktioniert und wie man eine Datei bearbeitet. Vieles von dem, was ein Systemprompt, AGENTS.md, Skills usw. hinzufügen, kostet zuerst einmal Token und lenkt ab. (Das sagen übrigens nicht nur die Pi-Entwickler, das sagt interessanterweise — wenn auch in einem etwas anderen Zusammenhang — sogar Anthropic!)

Pi aktiviert deswegen standardmäßig nur vier Tools: read, write, edit und bash. Es gibt kein eigenes Tool für die Volltextsuche, keines für Webzugriffe. Wer suchen will, ruft über bash einfach grep oder rg auf. Der komplette Systemprompt inklusive aller Tool-Definitionen beträgt nur gut 1.000 Token. Das ist ein Fünfzigstel von dem, was Claude Code mindestens braucht! Bei einem lokalen Modell mit 130.000 oder 260.000 Token ist das der Unterschied zwischen »unbrauchbar langsam« und »funktioniert«.

Der Preis für diese Sparsamkeit sind weniger Funktionen, weniger Komfort im Terminal und weniger Tools. Pi ist aber erweiterbar (dazu gleich mehr). Erfreulich für Umsteiger: Pi liest beim Start AGENTS.md und ersatzweise CLAUDE.md, und zwar global, aus allen übergeordneten Verzeichnissen sowie aus dem aktuellen Verzeichnis.

Installation

Pi setzt Node.js (Version 22.19 oder neuer) voraus. Zur Installation verwenden Sie am einfachsten das Installations-Script oder npm (hier zur Referenz die Originalanleitung).

$ curl -fsSL https://pi.dev/install.sh | sh                  # Linux, macOS
> powershell -c "irm https://pi.dev/install.ps1 | iex"       # Windows
$ npm i -g --ignore-scripts @earendil-works/pi-coding-agent  # Node.js

Das Installations-Script hat den Vorteil, dass es alle Abhängigkeiten auf exakte Versionen fixiert; Updates führen Sie dann mit pi update durch. Weitere Installationsvarianten beschreibt https://pi.dev.

Anschließend starten Sie den Agenten im Projektverzeichnis mit pi und melden sich mit /login bei einem der über 40 unterstützten Anbieter an. Neben Anthropic, OpenAI und Google funktionieren auch OpenRouter, DeepSeek oder Groq. Bei OpenAI können Sie sogar ein ChatGPT-Abo verwenden.
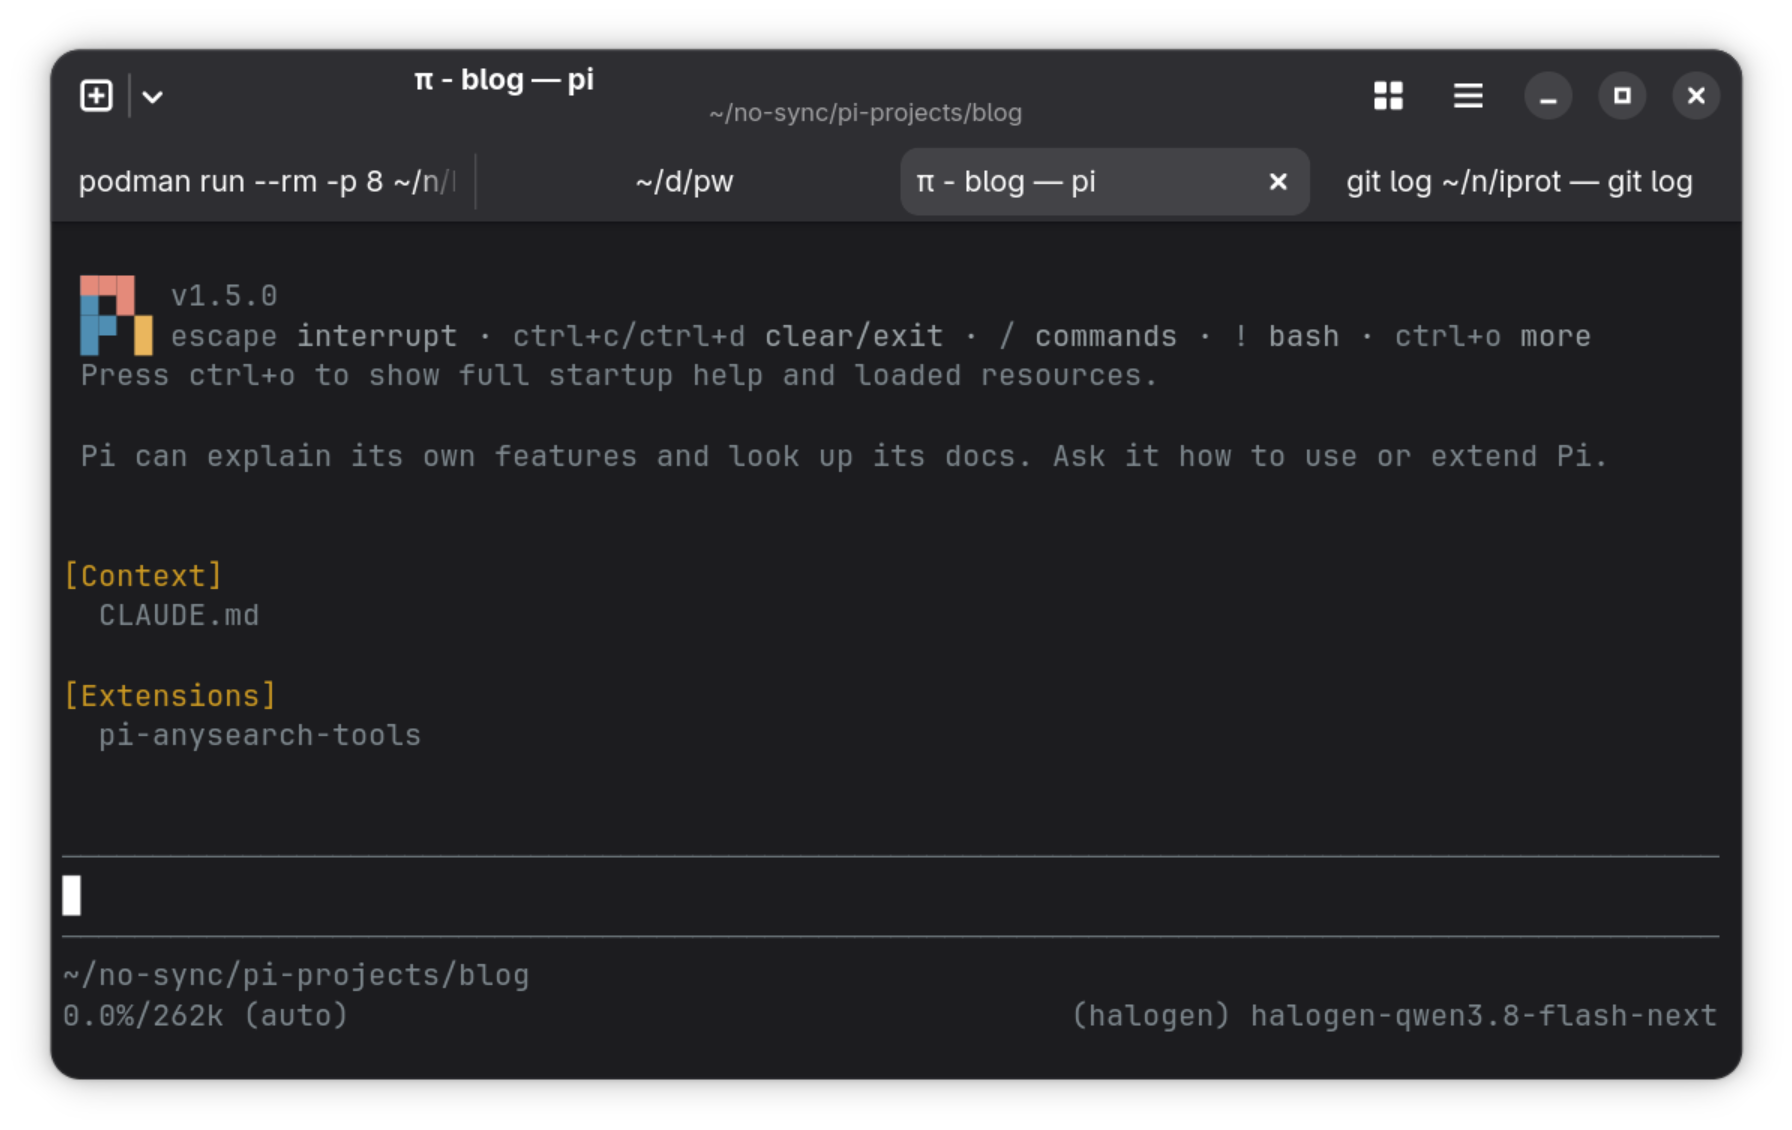
Auch die Startseite von Pi ist minimalistisch

Lokale Modelle anbinden

Für mich viel interessanter ist aber die Anbindung eines lokalen Modells. Dazu tragen Sie den Server in ~/.pi/agent/models.json ein. Das folgende Beispiel geht davon aus, dass LM Studio auf dem lokalen Rechner läuft und dort das Modell Qwen 3.8 Flash Next geladen ist:

{
  "providers": {
    "lmstudio": {
      "baseUrl": "http://localhost:1234/v1",
      "api":     "openai-completions",
      "apiKey":  "lmstudio",
      "models": [
        { "id": "qwen3.8-flash-next",
          "contextWindow": 262144 }
      ]
    }
  }
}

Pi spricht mit LM Studio über die OpenAI-kompatible Schnittstelle. Die meisten Inferenz-Engines unterstützen diese API, d.h., die gleiche Konfiguration funktioniert sinngemäß auch für Ollama, vLLM oder die auf Strix Halo optimierten Engines, die ich in meinem Artikel zu Qwen 3.8 Flash Next vorgestellt habe. Sie müssen nur baseUrl und die Modell-ID anpassen. Die Angabe von contextWindow ist optional; ohne sie nimmt Pi 128.000 Token an. Welche Modelle gerade zur Auswahl stehen, zeigt /model.

Mittlerweile hat Pi außerdem einen eingebauten Provider für den Router-Modus von llama.cpp. Dabei verwaltet llama serve mehrere GGUF-Modelle und lädt diese bei Bedarf. In Pi richten Sie die Verbindung mit /login llama.cpp ein, laden mit /llama ein Modell und wählen es dann mit /model aus.

Hinweis: Achten Sie darauf, dass Sie in Ihrer Inferenz-Engine ein ausreichend großes Kontextfenster einstellen. Viele Engines verwenden per Default einen winzigen Kontext von 4.096 oder 32.768 Token. Für agentisches Coding ist das viel zu wenig, auch mit Pi. Ich verwende auf meinem 128-GB-Rechner das Maximum, das viele lokale Modelle aktuell unterstützen, also 256k Token (262144).

Erweiterungsmechanismen

Ein Agent mit so wenigen Tools klingt trostlos. Pi kompensiert den anfänglichen Minimalismus mit vier Erweiterungsmechanismen:

  • Skills: Im Kontext steht dauerhaft nur die Beschreibung eines Skills. Die eigentliche Anleitung wird erst geladen, wenn der Skill tatsächlich gebraucht wird.
  • Extensions: Das sind TypeScript-Module, die eigene Tools, Slash-Kommandos oder Hooks (ebenfalls auf TypeScript-Basis) zur Verfügung stellen.
  • Prompt Templates: wiederverwendbare Prompt-Bausteine, vergleichbar mit den Slash-Kommandos von Claude Code.
  • Themes und Keybindings: Farbschemata und Tastenkürzel.

Skills liest Pi aus den folgenden Verzeichnissen:

~/.pi/agent/skills
~/.agents/skills
projektverzeichnis/.pi/skills
projektverzeichnis/.agents/skills

Alle vier Mechanismen lassen sich zu einem Pi Package zusammenfassen und über npm oder Git weitergeben. Installiert werden Pakete mit pi install npm:paketname.

MCP: Kehrtwende mit Kontext-Spartrick

Lange Zeit war die Meinung der Pi-Entwickler zu MCP klar: »No MCP. Build CLI tools with READMEs.« Wer partout MCP wollte, musste das Paket pi-mcp-adapter installieren.

Mit Version 0.99 (Ende September 2026) hat sich das geändert: Pi unterstützt MCP-Server jetzt direkt, sowohl lokal (stdio) als auch remote (Streamable HTTP, inklusive OAuth-Login). Die Konfiguration erfolgt in ~/.pi/agent/mcp.json bzw. projektspezifisch in .pi/mcp.json. Das Format entspricht dem von Claude Code, d.h., Sie können vorhandene mcpServers-Einträge einfach kopieren. Alternativ richten Sie Server mit pi mcp add ein:

$ pi mcp add filesystem -- npx -y @modelcontextprotocol/server-filesystem .
$ pi mcp add docs --url https://example.com/mcp --bearer-token-env-var DOCS_TOKEN
$ pi mcp list

Innerhalb von Pi zeigt /mcp den Zustand aller Server an. Dort können Sie Server auch aktivieren oder deaktivieren und sich bei OAuth-Servern anmelden.

Interessant ist, wie Pi das Kontextproblem löst, das MCP-Server üblicherweise verursachen. Per Default landen die Tool-Definitionen der MCP-Server nämlich gar nicht im Kontext. Stattdessen aktiviert Pi ein zusätzliches Tool namens Codemode. Damit schreibt das Sprachmodell kleine JavaScript-Programme, die in einer Sandbox ausgeführt werden. Dort kann das Modell mit searchTools() nach passenden MCP-Tools suchen, diese aufrufen, die Ergebnisse filtern und nur die wirklich relevanten Ergebnisse zurückgeben. Im Systemprompt steht pro MCP-Server nur eine Zeile mit einer Kurzbeschreibung. Alternativ können Sie in mcp.json für jeden Server bzw. für einzelne Tools einstellen, ob diese direkt deklariert werden (direct), erst nach einer Suche mit tool_search (deferred) oder gar nicht (hidden).

Ob dieses Konzept auch mit lokalen Modellen gut funktioniert, hängt vom Modell ab: Ein Modell, das zuverlässig JavaScript schreibt und Tools sucht, profitiert davon. Für kleinere Modelle ist es vermutlich besser, wenige wichtige Tools mit direct freizugeben.

Keine Websuche

Zu den Lücken in Pi zählt nach wie vor die Websuche. Pi greift auf das bash-Tool mit curl zurück, um einzelne Webseiten mit bekannter URL zu lesen, aber das ist kein echter Ersatz. Hier liegt kein technisches Problem vor, sondern ein wirtschaftliches: Die meisten Suchmaschinen leben von der Werbung. Sie erkennen agentische Websuchen und blockieren diese rasch. Die fehlende Websuche ist kein Pi-spezifisches Problem, sondern betrifft auch andere Open-Source-Agenten außerhalb des reinen Coding-Umfelds, z.B. Hermes und OpenClaw.

Glücklicherweise gibt es Packages, die eine Suchfunktion für Pi nachliefern. Die meisten davon benötigen aber einen Key oder ein Abo. Beispielsweise nutzt npm:@burneikis/pi-web-search die Websuche von Anthropic; dass setzt aber einen Claude-API-Key voraus. Ich habe stattdessen pi-anysearch-tools ausprobiert. Die Installation ist unkompliziert:

$ pi install npm:pi-anysearch-tools

Das Paket erfordert allerdings eine Registrierung und einen Key bei https://anysearch.com. AnySearch hat (Stand: November 2026) einen großzügigen Free Plan, der immerhin 1.000 Suchanfragen pro Tag erlaubt. Für mehr Suchen oder eine bessere Suchqualität müssen Sie ein Abo abschließen. Den Key tragen Sie in ~/.pi/agent/anysearch.json ein:

{
  "anysearchApiKey": "as_sk_xxx"
}

Bei meinen Tests hat das Zusammenspiel zwischen Pi und AnySearch ausgezeichnet funktioniert. Seit Pi MCP unterstützt, können Sie natürlich auch einen MCP-Server für die Websuche einbinden.

Keine Permissions

Pi hat kein Permission-System. Das Modell ruft bash auf. Damit läuft jedes Kommando mit Ihren Rechten; im Worst Case gilt das auch für rm -rf! Im Unterschied zu Claude Code gibt es weder einen Auto-Modus noch einen Classifier, der Kommandos vor der Ausführung begutachtet. Wer die Grenzen der Permission-Systeme kommerzieller Coding-Agenten kennt, mag das konsequent finden. Tatsächlich habe ich mit Pi durchwegs gute Erfahrungen gemacht. Dennoch gilt: Pi ist nur so gut wie die Modelle, die es nutzt.

Immerhin gibt es einen sogenannten Project Trust: Wenn ein Projektverzeichnis eigene Einstellungen, Extensions, Skills oder MCP-Server mitbringt (also z.B. .pi/settings.json oder .pi/mcp.json), fragt Pi beim Start, ob Sie diesem Projekt vertrauen. Das verhindert, dass ein fremdes Repository unbemerkt Code in den Pi-Prozess lädt. Auf die Aktionen des Sprachmodells hat das aber keinen Einfluss.

Die Dokumentation empfiehlt stattdessen, Pi in einen Container oder eine virtuelle Maschine zu stecken, und beschreibt dafür mehrere Varianten. Das ist nicht so komfortabel wie die Sandboxing-Systeme kommerzieller Coding-Agenten, aber sicherheitstechnisch ein vernünftiger Ansatz.

Was sonst noch fehlt

Ebenfalls nicht eingebaut sind Subagenten, ein Planungsmodus, Hintergrund-Tasks oder eine Worktree-Unterstützung. Die Entwickler argumentieren, dass solche Features besser als Extension aufgehoben sind. Tatsächlich gibt es fertige Pakete, die genau das nachrüsten. Wer alles auf einmal will, greift zu omp: Das ist ein Fork von Pi, der LSP-Integration, Debugger-Anbindung, Subagenten und Planungsmodus mitbringt. Leider ist man damit wieder bei der Komplexität, vor der Pi ursprünglich geflüchtet ist.

Sessions, Slash-Kommandos und Optionen

Pi speichert jede Session als JSONL-Datei in ~/.pi/agent/sessions, sortiert nach Arbeitsverzeichnis. Mit /resume kehren Sie zu einer früheren Session zurück, mit /fork zweigen Sie von einer beliebigen Nachricht eine neue ab. /compact fasst den bisherigen Verlauf zusammen.

Neuartig aus Claude-Code-Perspektive ist /tree: Das Kommando stellt die Session als Baum dar, in dem Sie navigieren und zwischen Zweigen wechseln können. Wenn Sie einen Prompt zurücknehmen und anders formulieren, geht der alte Ast nicht verloren; Sie können jederzeit dorthin zurückspringen und beide Varianten vergleichen. Das ist deutlich mächtiger als eine lineare Rewind-Funktion.

Für die Automatisierung gibt es Betriebsarten ohne Benutzeroberfläche: pi -p "prompt" liefert die Antwort und endet dann. --mode json gibt einen Event-Stream aus, --mode rpc erlaubt die Steuerung über stdin und stdout. Mit --export machen Sie aus einer Session eine HTML-Datei. Mit --tools bzw. -t bestimmen Sie, welche Tools aktiv sind. Beispielsweise aktiviert pi -t +codemode,-write zusätzlich codemode und deaktiviert write.

Praktische Erfahrungen

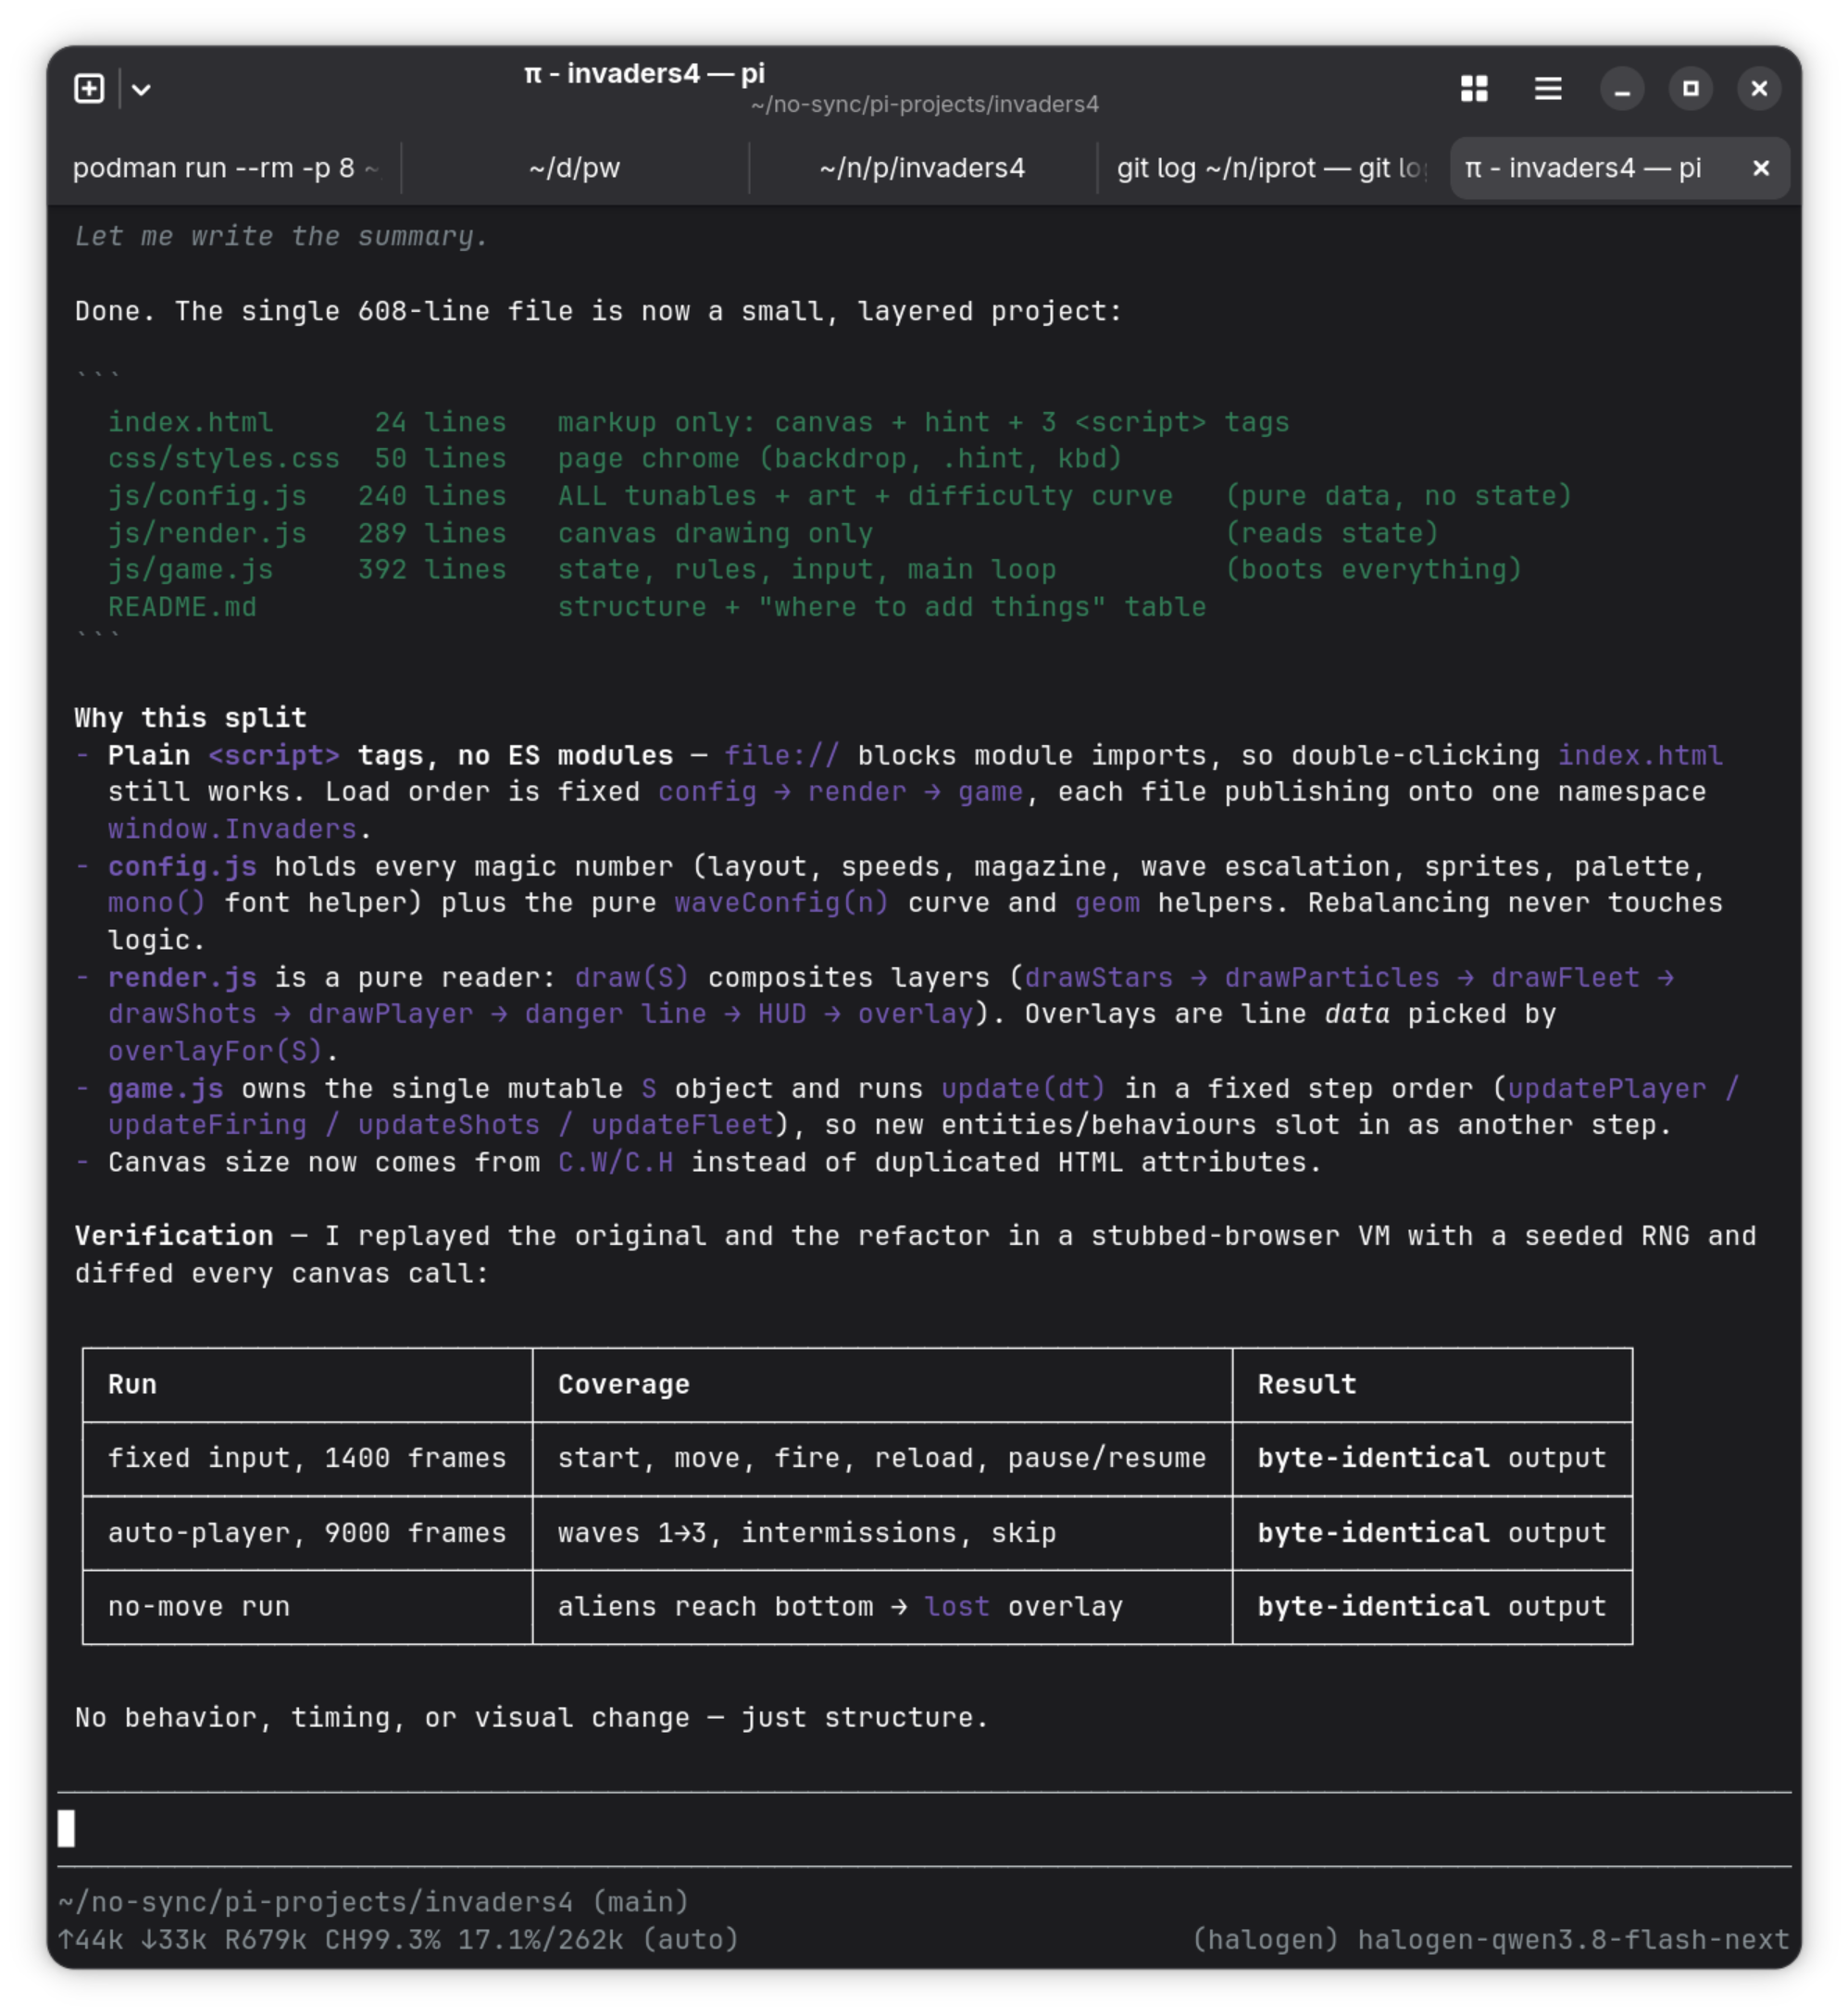
Ich habe Pi mit dem lokalen Modell Qwen 3.8 Flash Next getestet (siehe auch meinen Blog-Artikel zu Qwen 3.8 Flash Next). Als ersten Test habe ich Pi gebeten, ein Spiel in der Art von Space Invaders zu programmieren. Die erste, fehlerfrei spielbare Version war nach vier Minuten fertig. Auch meine Verbesserungswünsche samt einem größeren Refactoring wurden anstandslos und zügig ausgeführt.
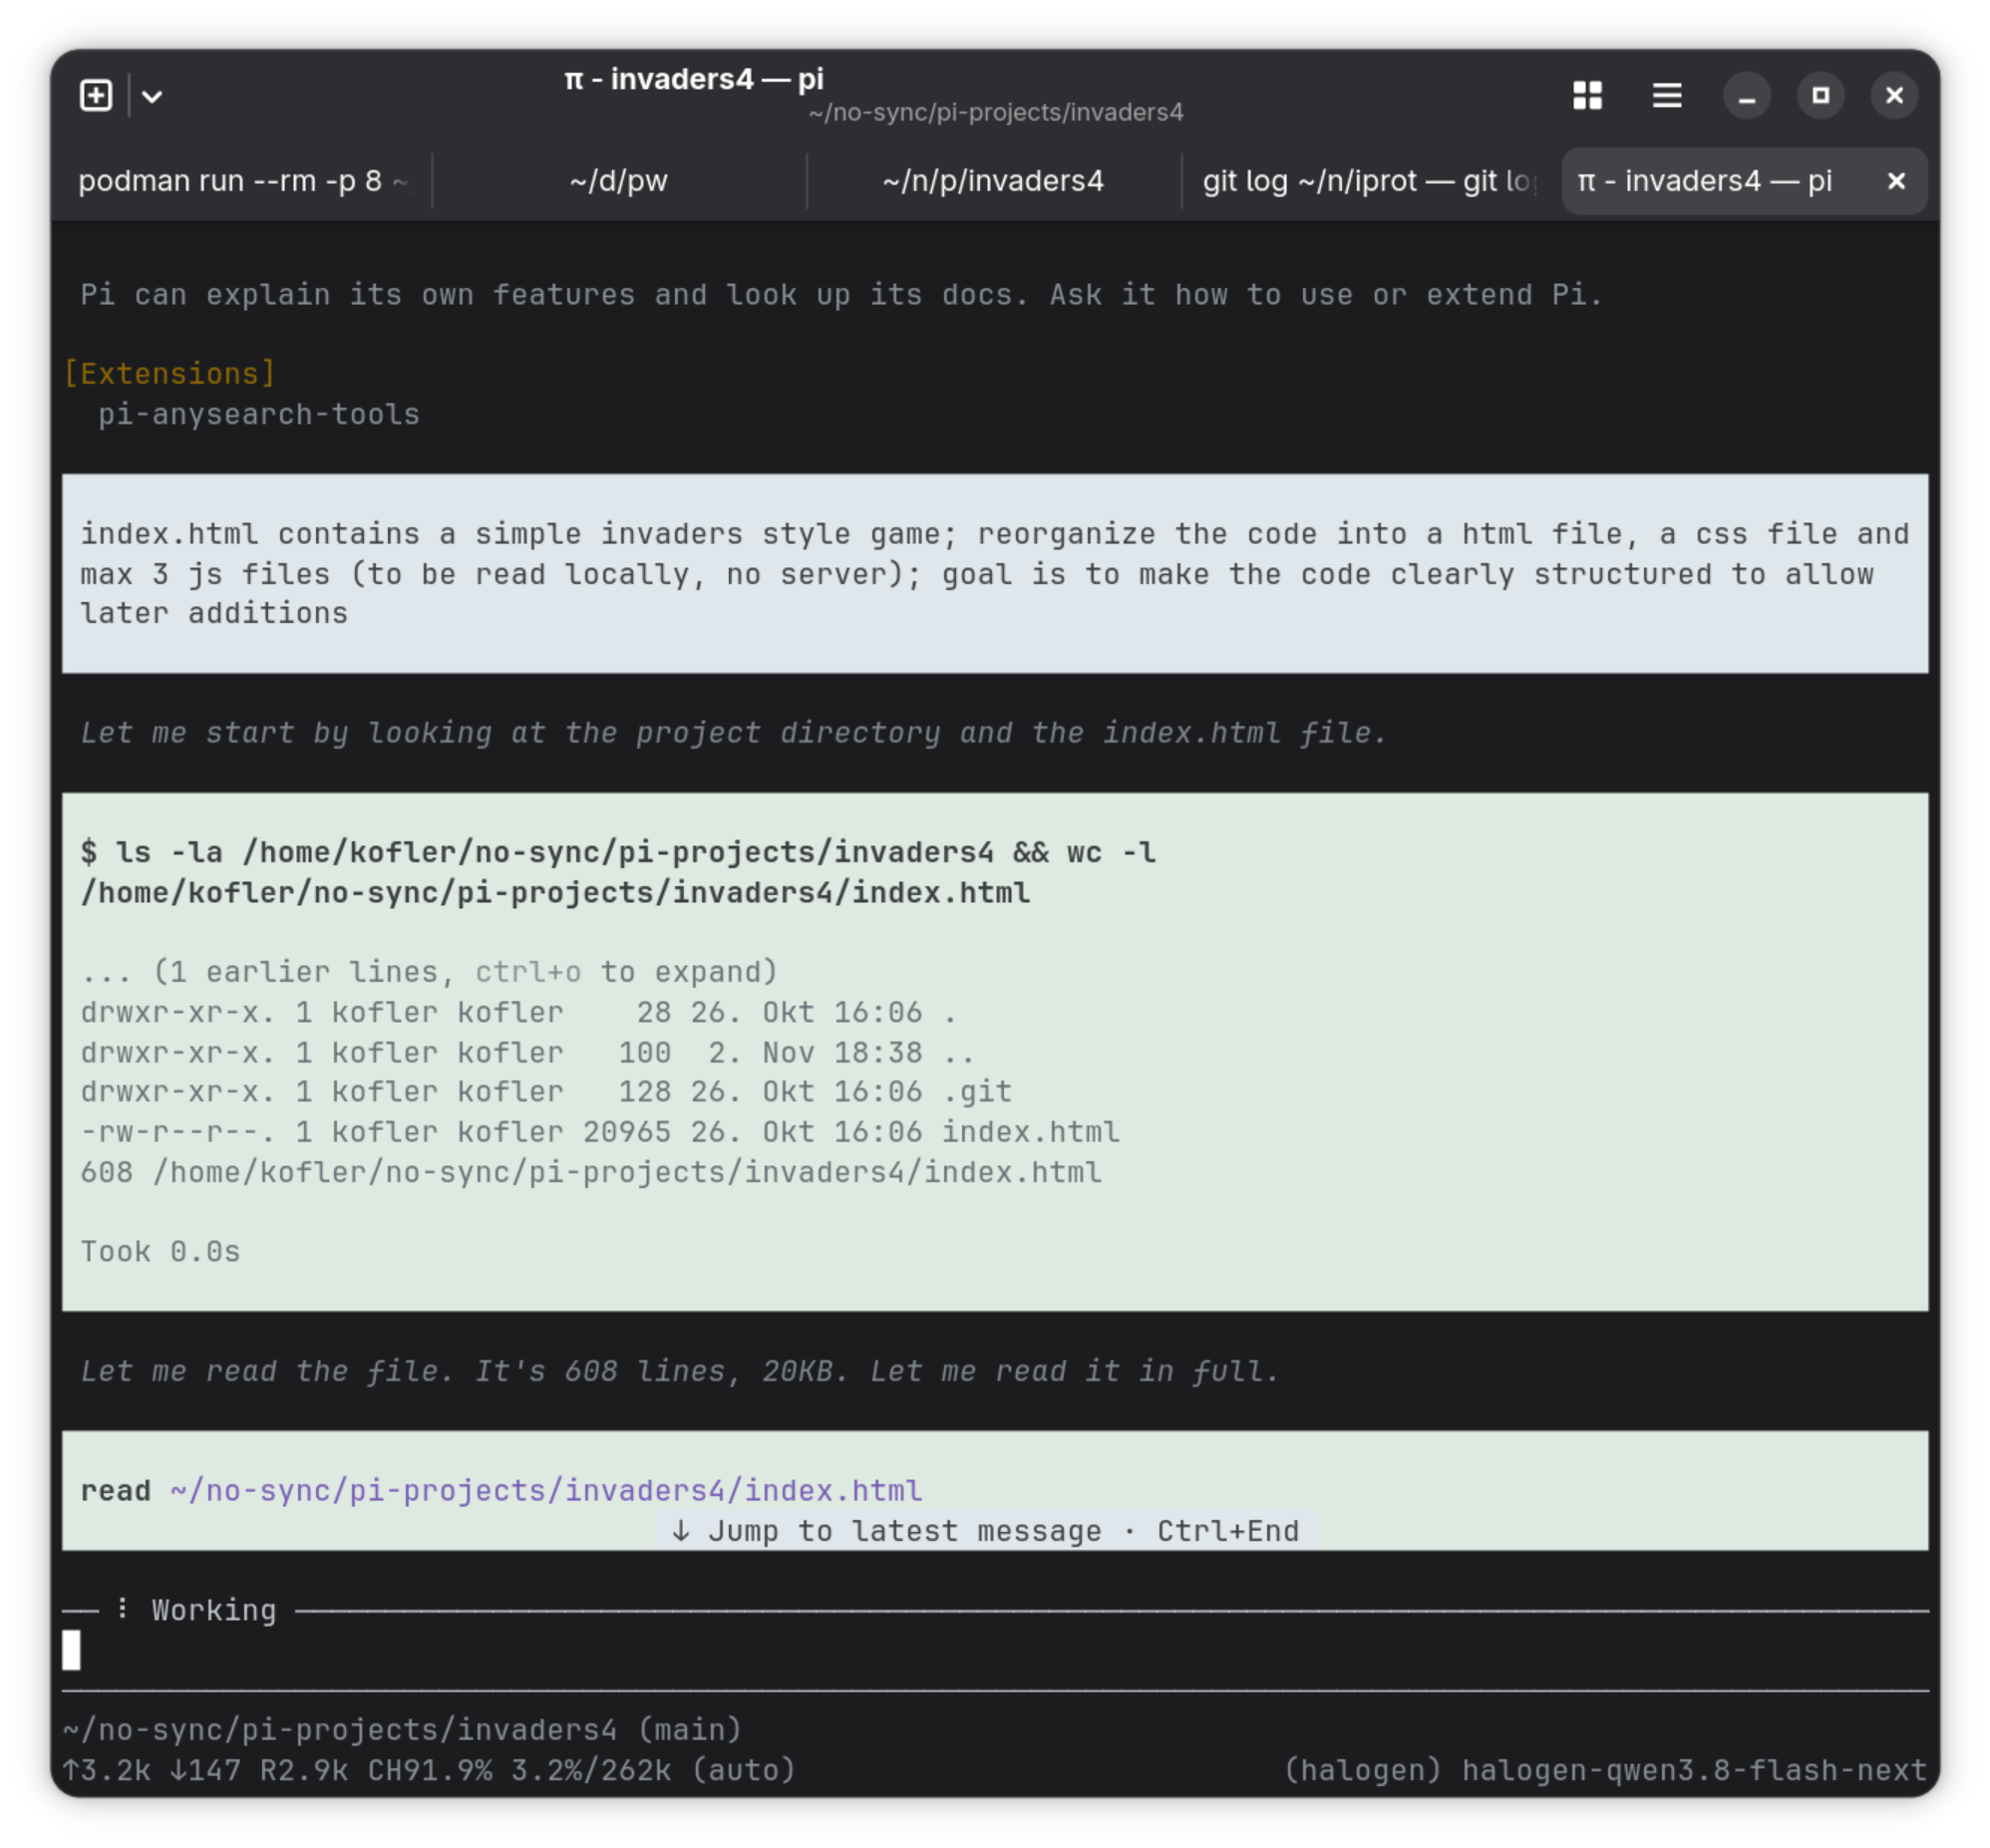
Pi startet einen größeren Refactoring-Prozess
Das abgeschlossene Refactoring

Ein einfaches Browser-Spiel ist ein netter Test, aber wie sieht es mit realem Code aus? Pi und Qwen 3.8 Flash Next schlagen sich wacker. Heute habe ich in einer größeren PHP-Datei (ca. 2000 Zeilen / 60 kByte Code) eine Sicherheitsanalyse durchgeführt. Pi musste natürlich auch diverse verknüpfte Code-Dateien lesen. Das Ergebnis war inhaltlich exzellent und formal gut aufbereitet, aber Claude Code (oder Pi im Zusammenspiel mit kommerziellen Cloud-Modellen) wäre viel schneller fertig gewesen. Wenn Sie diesbezüglich einmal verwöhnt sind, fällt diese Gemächlichkeit schwer, zumal gleichzeitig der Lüfter hochdreht, um die CPU zu kühlen. Lokale Modelle verdeutlichen den mit der KI verbundenen Ressourcenaufwand viel spürbarer als Cloud-Modelle!

Ich verwende KI-Agenten nicht nur für das Coding, sondern auch für eine erste Korrektur meiner in Markdown-Syntax verfassten Texte (Rechtschreibfehler, Grammatik, inhaltliche Fehler, Redundanzen etc.). Die Geschwindigkeit spielt dabei eine untergeordnete Rolle; bei längeren Texten kann ich Korrekturläufe auch über Nacht ausführen. Mit dem Coding-Agent Pi hat dieser Test zugegebenermaßen wenig zu tun, vielmehr betreffen die Ergebnisse das von mir genutzte Sprachmodell.

Das Korrekturlesen für diesen Text samt einer inhaltlichen Kontrolle hat mehr als eine Viertelstunde gedauert. Qwen-3.8-flash-next ist dabei übertrieben pingelig vorgegangen. In Pi können Sie dem Sprachmodell beim »Denken« zusehen. Qwen hat immer wieder dieselben Dinge überprüft und viele — aus meiner Sicht — komplett sinnlose Doppel- und Dreifachkontrollen durchgeführt. (Hinterlassen Sie einen Kommentar, wenn Sie doch noch einen Fehler finden!) Mein Prompt war: »proofread @pi-agent.md: fix obvious typos or grammar errors; list everything else; also check content on factual errors«
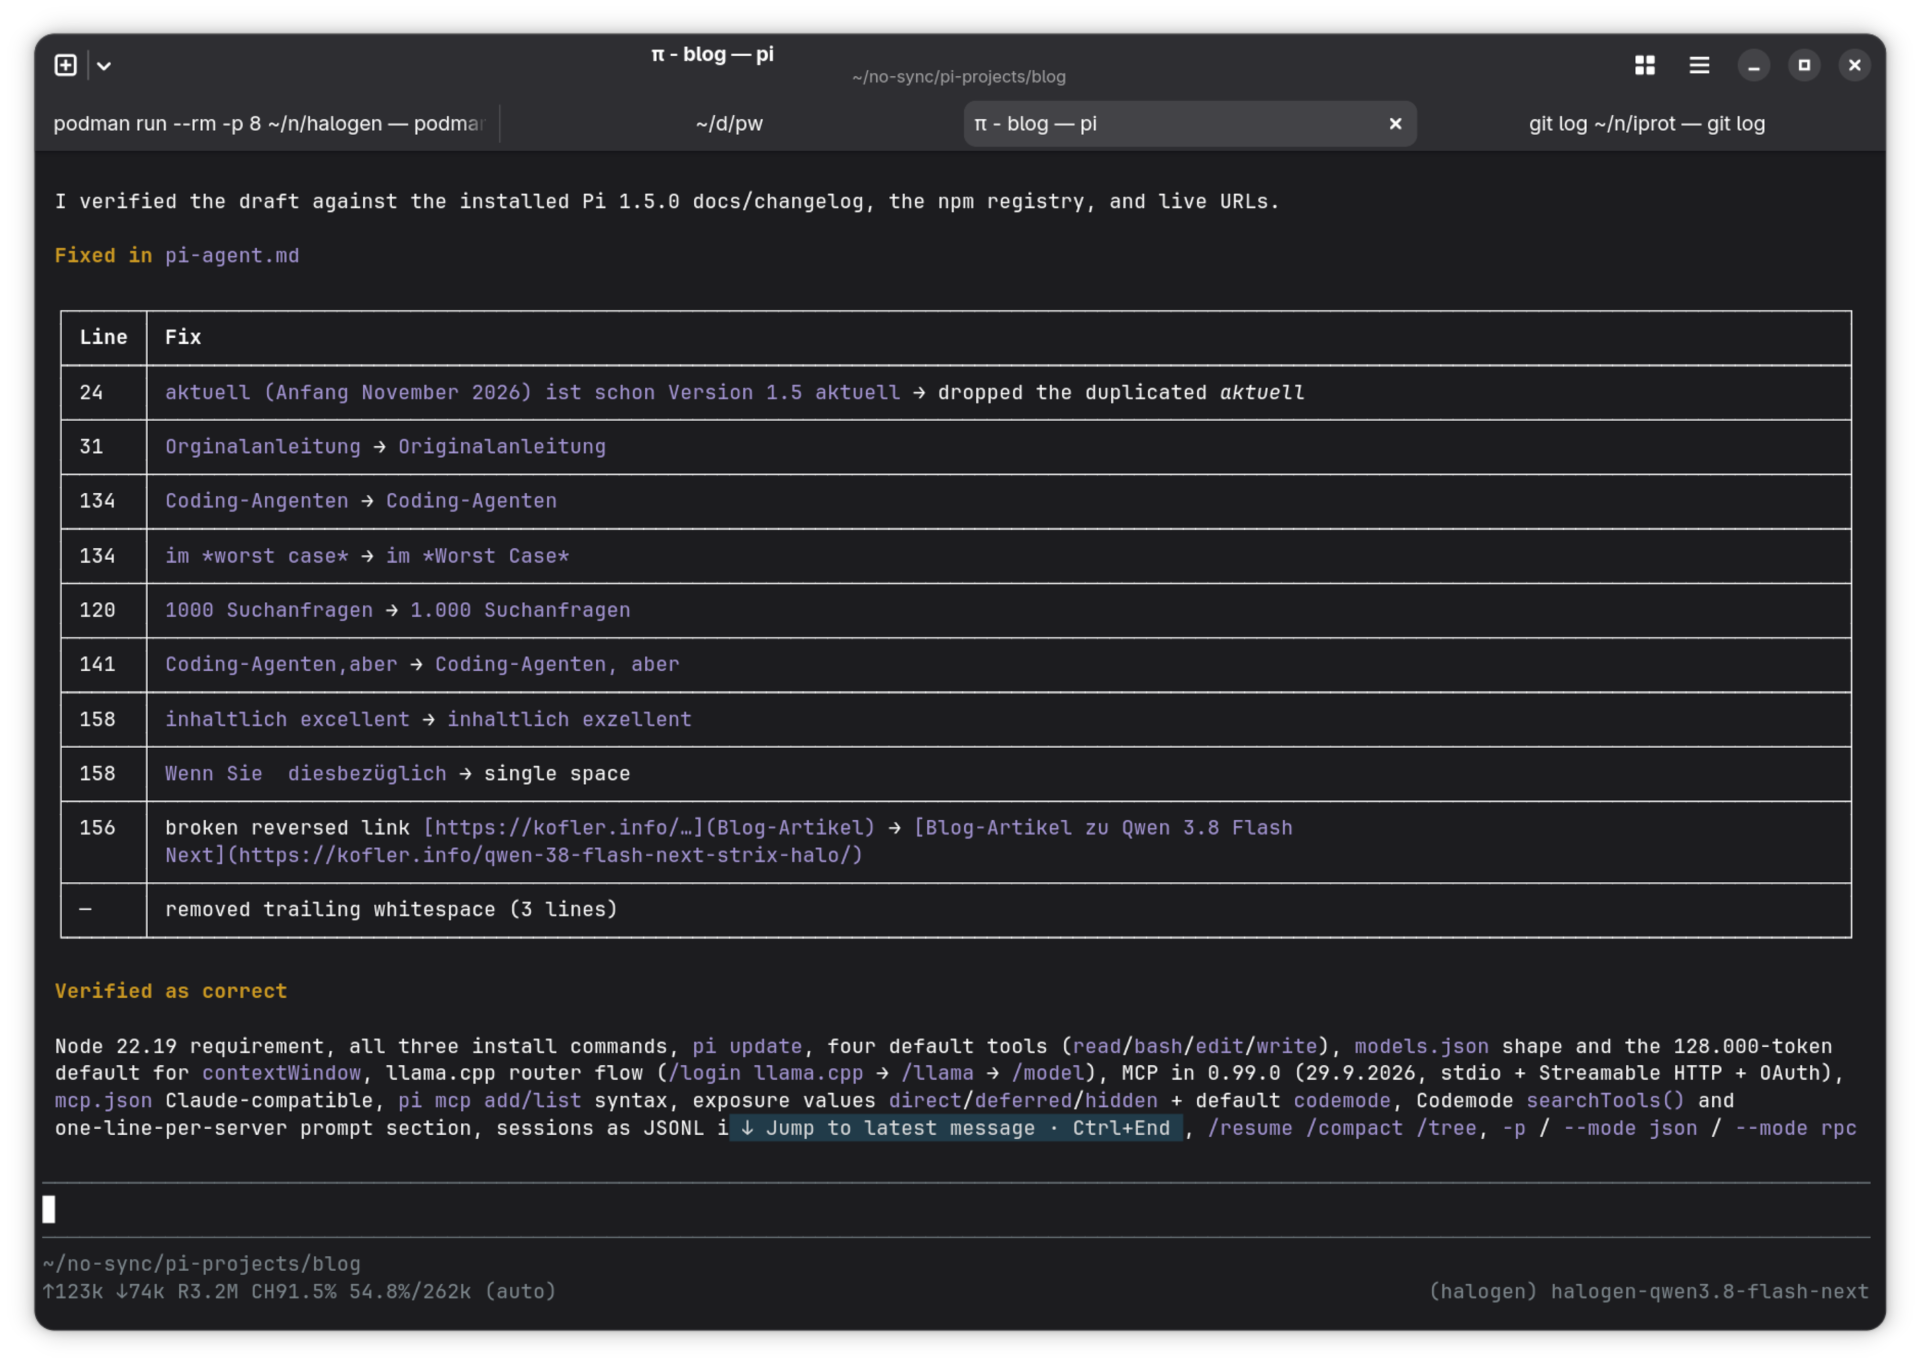
Korrektur dieses Artikels mit Pi und Qwen-3.8-flash-next

Um es zusammenzufassen: Pi mit Qwen 3.8 Flash Next funktioniert ausgezeichnet, aber kommerzielle Coding-Agenten bzw. Pi in Kombination mit kommerziellen Modellen arbeiten eben noch besser.

Fazit

Für mich kann Pi plus ein lokales Modell Claude Code noch nicht vollständig ersetzen. Das habe ich zu Beginn meiner Tests auch nicht erwartet. Für große Software-Projekte bieten kommerzielle CLIs von Anthropic, OpenAI oder Mistral mehr Qualität, Geschwindigkeit und Arbeitskomfort.

Aber Pi zeigt, wie wenig ein Coding-Agent braucht. Pi glänzt da, wo kommerzielle Agenten schwächeln: im Zusammenspiel mit lokalen Modellen mit begrenztem Kontext und begrenzter Rechenleistung. Wenn Sie aus Gründen des Datenschutzes oder der Unabhängigkeit mit einem lokalen Modell arbeiten möchten, ist Pi die erste Wahl.

Von der geringeren Geschwindigkeit und Qualität lokaler Modelle einmal abgesehen, empfand ich die fehlende Websuche als das größte Hindernis für produktives Arbeiten: Für mich ist ein Coding-Agent auch ein Hilfsmittel zur Recherche. Bei Bugs im Zusammenspiel mit modernen Bibliotheken oder bei Setup-Problemen mit neuen Tools erwarte ich, dass der Agent aktuelle Infos aus dem Internet beschaffen kann. Bei Open-Source-Coding-Agenten wie Pi ist dazu die Anbindung an einen externen Suchdienst notwendig, die zumindest bei intensiver Nutzung zusätzliche Kosten verursacht.

Quellen/Links

  •  

Mein inoffizieller Red Hat Errata-Monitor

Hi, in diesem Beitrag möchte ich euch ein Projekt vorstellen, an dem ich gerade arbeite. Inspiriert ist es von meinem RHEL CVE Monitor für arme Admins. Doch bevor es losgeht, beginne ich mit einem Disclaimer und einem Transparenzhinweis. Anschließend erläutere ich die Probleme, die ich mit diesem Projekt lösen möchte und gebe ein Beispiel wie man es nutzt.

Disclaimer: Es handelt sich hierbei um ein Community-Projekt, welches in keinster Weise von Red Hat stammt bzw. unterstützt wird. Es nutzt ausschließlich öffentlich verfügbare APIs, die ohne Authentifizierung genutzt werden können.

Transparenzhinweis: Das Projekt ist unter Nutzung eines KI-Coding-Assistenten entstanden.

Wofür ist das gut?

Ich führe mit meinen Kunden regelmäßig Videokonferenzen durch, um sie über Neuigkeiten zu informieren und ihre Sorgen, Nöte und Anträge aufzunehmen. Da ich ihre Red Hat-Subskriptionen kenne, möchte ich sie darüber informieren, welche Red Hat Errata seit unserem letzten Termin veröffentlicht wurden. Die Scripts aus diesem Projekt helfen mir dabei, diese Informationen effizient zusammenzustellen und in die Agenda einzufügen.

Aktuell bieten die Red Hat Errata Notifications noch keine Möglichkeit die Errata nach Produkt zu filtern. Mein Errata-Monitor bietet diese Funktionalität in Form von Filtern. Im Modus monitor speichert er auch den Status der letzten Ausführung, um bei erneuter Ausführung nur die Änderungen zum vorherigen Lauf auszugeben.

Das Projekt eignet sich damit sowohl für Ad-hoc-Abfragen, als auch für einen Monitoring-Modus, wo das Skript zeitgesteuert ausgeführt wird und neue Errata ausgibt bzw. diese Informationen per E-Mail versendet.

Wie nutzt man das?

Bitte schaut für eine ausführliche Beschreibung in das README des Projekts unter URL: https://github.com/Tronde/rh_errata_monitor. Oder nutzt die Hilfe eines der Scripte:

$ python3 rh_errata_monitor.py --help
usage: rh_errata_monitor.py [-h] [--filters FILTERS] [--state-file STATE_FILE] [--initial-days INITIAL_DAYS] [--format {json,csv,md}] [--output OUTPUT] [--exit-code]
                            [--dry-run] [--verbose]
                            {monitor,list-products,search} ...

Monitor Red Hat Errata Search API for new errata.

positional arguments:
  {monitor,list-products,search}
    monitor             Check for new errata per filter (default)
    list-products       List available product names from the API
    search              One-off stateless errata search

options:
  -h, --help            show this help message and exit
  --filters FILTERS     Path to INI filter config file (default: filters.conf)
  --state-file STATE_FILE
                        Path to JSON state file (default: .errata_state.json)
  --initial-days INITIAL_DAYS
                        On first run (no state), look back this many days (default: 30)
  --format {json,csv,md}
                        Output format (default: md)
  --output OUTPUT       Write report to file in addition to stdout
  --exit-code           Exit with code 2 when new errata are found
  --dry-run             Show queries without hitting the API
  --verbose, -v         Enable debug logging

examples:
  rh_errata_monitor.py monitor
  rh_errata_monitor.py list-products
  rh_errata_monitor.py list-products --search satellite
  rh_errata_monitor.py search --product "Red Hat Satellite" --after 2024-01-01
  rh_errata_monitor.py search --synopsis '"Ansible Automation Platform" "Setup Bundle"'
  rh_errata_monitor.py monitor --format json --output /tmp/errata.json

Die folgenden beiden Codeblöcke zeigen ein kurzes Beispiel für eine Filterdatei und einen Aufruf, den ich benutze, um eine Markdown-Ausgabe für meine Agenda zu generieren.

$ cat filter.conf 
# Red Hat Errata Monitor -- Filter Configuration
#
# Each [section] defines a named filter that the monitor checks on every run.
# Available keys:
#
#   product  = Exact product name as listed by 'list-products' command
#              Maps to: fq=portal_product_names:("...")
#
#   synopsis = Free-text search terms matched against errata synopsis/content
#              Use quotes for exact phrases: "Satellite 6" "release"
#              Maps to: q=...
#
# Both keys are optional.  If both are set, results must match BOTH (AND logic).
# If neither is set, all errata are returned (not recommended).
#
# Run 'list-products' to discover valid product names:
#   python3 rh_errata_monitor.py list-products
#   python3 rh_errata_monitor.py list-products --search satellite

# -- Red Hat Satellite -------------------------------------------------------

[satellite-releases]
# All errata for the "Red Hat Satellite" product that mention "Satellite 6"
product = Red Hat Satellite
synopsis = Satellite 6

[satellite-capsule]
product = Red Hat Satellite Capsule

# -- Red Hat Enterprise Linux ------------------------------------------------
[RHEL]
product = Red Hat Enterprise Linux for x86_64

Ich möchte also Errata für den Red Hat Satellite, Capsules und RHEL abrufen, was wie folgt aussehen kann (Ausgabe gekürzt):

$ python3 rh_errata_monitor.py search --filters filter.conf --after 2026-09-24
### satellite-releases (0 errata since 2026-09-24)

  - none

### satellite-capsule (0 errata since 2026-09-24)

  - none

### RHEL (50 errata since 2026-09-24)

  - [RHBA-2026:73791 - New Application Stream container images](https://access.redhat.com/errata/RHBA-2026:73791) - None
  - [RHSA-2026:73766 - Important: pki-core security update](https://access.redhat.com/errata/RHSA-2026:73766) - Important
  - [RHSA-2026:73765 - Important: dogtag-pki security update](https://access.redhat.com/errata/RHSA-2026:73765) - Important
  - [RHBA-2026:73746 - New Application Stream container images](https://access.redhat.com/errata/RHBA-2026:73746) - None
  - [RHEA-2026:73547 - multiple NVIDIA kernel module packages bug fix and enhancement update](https://access.redhat.com/errata/RHEA-2026:73547) - None
  - [RHEA-2026:73546 - multiple NVIDIA kernel module packages bug fix and enhancement update](https://access.redhat.com/errata/RHEA-2026:73546) - None
  - [RHSA-2026:73512 - Moderate: gawk security update](https://access.redhat.com/errata/RHSA-2026:73512) - Moderate
  - <AUSGABE GEKÜRZT>

**Total: 50 errata since 2026-09-24 across 1 filter**

Ich lasse mir hier die Errata ausgeben, die nach dem 24.09.2026 veröffentlicht wurden. Während es für den Satellite und dessen Capsules nichts neues gibt, sind 50 Errata für RHEL veröffentlicht worden. Ich habe die Ausgabe hier im Blog gekürzt, das Format ist jedoch ersichtlich.

Diese Liste kann ich nun per Copy&Paste in das Tool übernehmen, mit dem ich die Agenda für meinen TAM-Call generiere.

Wie stabil ist das Projekt?

Bei dem was ihr aktuell auf GitHub findet, handelt es sich um ein Pre-Release. Ich nutze es seit einigen Tagen und bisher hat es meinen Rechner nicht gestört.

Für die Filter nutze ich die Produktnamen aus der API und Filter die Strings aus dem Abschnitt Synopsis. Gerade letzteres ist Fehlerbehaftet und kann zu ungenauen bzw. fehlerhaften Ausgaben führen. Falls euch Fehler auffallen, freue ich mich, wenn ihr diese meldet.

Falls ihr dieses Projekt nützlich findet, lasst es mich gerne wissen. Dazu könnt ihr gern einen Kommentar unter diesem Beitrag hinterlassen oder einen Stern auf GitHub vergeben. Die CONTRIBUTING.md enthält Informationen, wie ihr darüber hinaus zum Projekt beitragen könnt.

  •  

Wero erreicht 60 Millionen Nutzer und baut Europas Bezahlsystem aus

Wero hat einen neuen Meilenstein erreicht. Nach Angaben der Sparkasse kann die European Payments Initiative (EPI) inzwischen 60 Millionen Nutzer für das europäische Bezahlsystem vorweisen. Damit wächst die Nutzerbasis weiter und schafft eine wichtige Grundlage für den Ausbau im Handel. Wero startete zunächst mit Zahlungen zwischen Privatpersonen. Geld lässt sich damit direkt zwischen Bankkonten übertragen. […]

Der Beitrag Wero erreicht 60 Millionen Nutzer und baut Europas Bezahlsystem aus erschien zuerst auf fosstopia.

  •  

Raspberry Pi OS mit modernisiertem Desktop

Der Desktop von Raspberry Pi OS erhält nach über zehn Jahren einen neuen Anstrich. Damit einher gehen ein neues Dock, ein grafischer Anwendungsstarter und eine überarbeitete Fensterverwaltung

  •  

DietPi 10.7 mit erweitertem Netzwerk-Script

DietPi, die schlanke Linux-Distribution für Single-Board-Computer bringt in v10.7 unter anderem eine erweiterte Netzwerk-Konfiguration, die mehrere Ethernet- und WLAN-Schnittstellen unabhängig voneinander einrichten kann.

  •  

RHEL CVE Monitor für arme Admins

User Story: Als RHEL-Systemadministrator:in möchte ich für einige ausgewählte Kompontenten, wie z.B. kernel, openssl oder samba, über neue CVE für diese Komponenten informiert werden. Leider steht mir dazu keine Schwachstellenmanagementlösung zur Verfügung. Einen Red Hat Satellite Server habe ich nicht und den Vulnerability Service in der Hybrid Cloud Console kann bzw. darf ich nicht nutzen.

Transparenzhinweis: Ich arbeite als TAM für Red Hat. Die im Folgenden vorgestellte Anwendung habe ich als Open-Source-Projekt unter MIT-Lizenz veröffentlicht. Es steht in keiner offiziellen Verbindung zu Red Hat.

RHEL CVE Monitor ist ein Python-Tool, das die Red Hat Security Data API regelmäßig abfragt und neue Sicherheitslücken (CVEs) für eine konfigurierbare Liste von RHEL-Paketen meldet.

Die zu überwachenden Pakete werden in packages.txt festgelegt (z. B. kernel, openssl, samba, rear). Beim ersten Lauf werden CVEs der letzten 30 Tage ausgegeben; danach zeigt das Tool nur noch neue Einträge seit dem letzten erfolgreichen Durchlauf. Bereits gemeldete CVEs werden in einer lokalen Zustandsdatei (.cve_monitor_state.json) gespeichert, damit nichts doppelt erscheint.

Die Ausgabe kann als Text, JSON oder CSV erfolgen und eignet sich für manuelle Prüfungen, Cron-Jobs oder systemd-Timer. Mit --exit-code lässt sich das Tool auch in CI/CD-Pipelines einbinden, die bei neuen CVEs alarmieren sollen.

Wie benutzt man das?

Der folgende Code-Block zeigt die CVE im RHEL-kernel der letzten 5 Tage:

[host.example.com rhel_cve_monitor]$ python3 rhel_cve_monitor.py --initial-days 4
=== kernel (1 new CVE) ===
  CVE-2026-80725       important    2026-08-29  https://access.redhat.com/security/cve/CVE-2026-80725

Total: 1 new CVE across 1 package

Die Ausgabe ist bewusst spartanisch gehalten. Man erhält lediglich die CVE-Nummer, die Severity, das Erscheinungsdatum und die URL zur Red Hat CVE Datenbank, wo man weitere Informationen zur Schwachstelle findet.

Verfügbare CLI-Optionen findet man in der Hilfe:

[host.example.com rhel_cve_monitor]$ python3 rhel_cve_monitor.py --help
usage: rhel_cve_monitor.py [-h] [--packages PACKAGES]
                           [--state-file STATE_FILE]
                           [--initial-days INITIAL_DAYS] [--output OUTPUT]
                           [--exit-code] [--verbose] [--dry-run]
                           [--format {text,json,csv}]
                           [--reset-packages PACKAGE [PACKAGE ...]]
                           [--reset-after YYYY-MM-DD]

Monitor Red Hat Security Data API for new CVEs affecting given RHEL packages.

options:
  -h, --help            show this help message and exit
  --packages PACKAGES   Path to file with one package name per line (default:
                        packages.txt)
  --state-file STATE_FILE
                        Path to state file tracking last run time (default:
                        .cve_monitor_state.json)
  --initial-days INITIAL_DAYS
                        On first run (no state file), look back this many days
                        (default: 30)
  --output OUTPUT       Optional file path to write the report to (in addition
                        to stdout)
  --exit-code           Exit with code 2 when new CVEs are found (useful for
                        CI/automation)
  --verbose, -v         Enable verbose logging
  --dry-run             Preview what would be queried without hitting the API
  --format {text,json,csv}
                        Output format: text (default), json, or csv
  --reset-packages PACKAGE [PACKAGE ...]
                        Clear seen-CVE state for these packages (use 'all' for
                        every package) and exit
  --reset-after YYYY-MM-DD
                        When resetting, also set last_run to this date so next
                        run queries from here

Mehr kann die kleine Anwendung nicht.

Und wo gibt es das?

Unter der URL: https://github.com/Tronde/rhel_cve_monitor

Das englischsprachige README enthält weitere Beispiele und Hinweise zur Nutzung.

Falls ihr diese kleine Anwendung nützlich findet, freue ich mich, wenn ihr mir hier im Blog einen Kommentar hinterlasst und eure Erfahrung weiterverbreitet. Wenn ihr Fehler findet oder Verbesserungsvorschläge habt, meldet diese bitte im GitHub-Issue-Tracker des Projekts.

  •  

Urlaub mit dem Lama

Urlaub ist herrlich, um einfach mal abzuschalten. Doch nach ein paar Tagen der puren Erholung packt mich meistens wieder der Drang, etwas Kreatives oder Produktives zu tun. Ein gutes Buch lesen? Schon erledigt. Rätseln? Nun ja, dieses Jahr hatte ich mir Sudoku als Endgegner ausgesucht – was mich am Ende ehrlicherweise mehr angestrengt als erfreut hat. Immerhin war ich an anderer Stelle produktiv und habe die Auffrischung meines A2-Fernpiloten-Kompetenznachweises erfolgreich hinter mich gebracht.

Doch der Tech-Spleen lässt einen auch im Urlaub nicht ganz los. Mir ging da nämlich eine Sache durch den Kopf: Letztes Jahr hat Prof. Klaus Knopper auf den Chemnitzer Linux-Tagen einen extrem spannenden Vortrag zum Thema lokale KI gehalten. Konkret ging es um Ollama auf dem Raspberry Pi. Warum also nicht die freie Zeit nutzen, um das Ganze mal aus der Ferne auf dem heimischen RasPi zu installieren und selbst auszuprobieren?

Was ist Ollama?

Für alle, die den Begriff noch nicht gehört haben, hilft ein kurzer Blick in die Wikipedia:

Ollama ist eine Open-Source-Software zur lokalen Ausführung von Large Language Models (LLMs) auf Desktop-Computern. Die Plattform ermöglicht die lokale Nutzung frei verfügbarer KI-Modelle und unterstützt die Integration mit weiteren lokalen Werkzeugen, die über eine Kommandozeilenschnittstelle oder eine Programmierschnittstelle (API) angebunden werden können. Ollama ist für macOS, Linux und Windows verfügbar.

Installation

Gesagt, getan. Die Installation auf dem Raspberry Pi – in meinem Fall ein Raspberry Pi 5 mit 8 GB RAM – erfolgt denkbar einfach über das Terminal mit folgendem Befehl:

curl -fsSL https://ollama.com/install.sh | sh

Am Ende des Installationsvorgangs spuckt das System noch den dezenten Hinweis aus, dass keine NPUs oder Grafikkarten von Nvidia gefunden wurden, die die Ausführung des Large Language Models beschleunigen könnten. Das war beim RasPi natürlich zu erwarten, hält uns aber nicht auf.

Damit wir der KI überhaupt Fragen stellen können, muss im Anschluss ein passendes und vor allem schlankes Modell installiert werden. Für diesen ersten Test habe ich mich für Llama 3.2 (ca. 2 GB) entschieden:

ollama run llama3.2:3b

Der Praxistest: Was taugt die lokale KI?

Nachdem das Modell geladen war, wollte ich es natürlich wissen. Ich habe der lokalen KI eine klassische Frage gestellt:

Welche Linux-Distribution würdest du einem Anfänger empfehlen?

Eine gute Frage!

Als Anfänger ist es wichtig, eine Linux-Distribution zu wählen, die leicht zu installieren und zu bedienen ist. Hier sind einige beliebte Optionen:

  1. Ubuntu: Ubuntu ist eine der bekanntesten und am weitesten verbreiteten Linux-Distributionen. Sie bietet eine intuitive Benutzeroberfläche und eine riesige Gemeinschaft von Benutzern, die ihr helfen können, wenn
    etwas nicht funktioniert.
  2. Linux Mint: Linux Mint basiert auf Ubuntu und ist für ihre einfache und benutzerfreundliche Oberfläche bekannt. Sie ist auch sehr sicher und bietet viele zusätzliche Funktionen wie eine verbesserte
    Sicherheitsfunktion und eine integrierte Diskografie.
  3. Debian: Debian ist eine weitere beliebte Linux-Distribution, die für ihre Stabilität und Sicherheit bekannt ist. Sie bietet eine riesige Auswahl an Software und ist ein beliebter Kandidat für Entwickler und
    Systemadministratoren.
  4. Fedora: Fedora ist eine Linux-Distribution, die von der Open Source Initiative verwaltet wird. Sie bietet eine aktuelle und sichere Version von Linux und ist ein beliebter Kandidat für Entwickler und
    Systemadministratoren.

Meine Empfehlung wäre Ubuntu. Sie ist eine großartige Option für Anfänger, da sie leicht zu installieren und zu bedienen ist. Außerdem bietet sie eine riesige Gemeinschaft von Benutzern, die ihr helfen können, wenn
etwas nicht funktioniert.

Ich hoffe, das hilft! Wenn du noch weitere Fragen hast, stehe ich gerne zur Verfügung.

Das Ergebnis kann sich absolut sehen lassen. Die Antwort hätte ich so oder so ähnlich wahrscheinlich auch gegeben. Ich bin wirklich nachhaltig beeindruckt, was der kleine Einplatinen-Computer hier ganz ohne Cloud-Anbindung zu leisten vermag.

Fazit

Eine lokale und ethische KI auf dem eigenen Raspberry Pi ist auf jeden Fall einen Blick wert. Wer seine Daten nicht ungeschützt den großen Hyperscalern in die Cloud blasen möchte, findet hier eine fantastische Alternative. Im Sinne der digitalen Souveränität ist diese Lösung für kleinere, alltägliche Aufgaben auf jeden Fall hervorragend geeignet.

Der Beitrag Urlaub mit dem Lama erschien zuerst auf intux.de.

  •  

Linux Kommandoreferenz: Shell-Befehle von A bis Z

„Linux Kommandoreferenz: Shell-Befehle von A bis Z“ von Michael Kofler ist 2024 in der 6., aktualisierten Auflage im Rheinwerk Verlag erschienen und umfasst 547 Seiten.

Wer kennt es nicht: Unter Linux ist nahezu alles machbar, was man an einem Computer tun kann – von der Textverarbeitung über Grafikdesign bis hin zur Erstellung eigener Webseiten oder Videos mit faszinierenden Tonspuren. Dennoch weiß man oft nicht, welches Programm oder Tool für die jeweilige Aufgabe am sinnvollsten einzusetzen wäre. Langes Stöbern und Recherchieren ist oft notwendig, bis das richtige Programm gefunden ist. Abgesehen von all den grafischen Anwendungen für Linux findet man etliche Programme und Kommandos, die sich im Terminal ausführen lassen. Eine komplexe Übersicht hierzu gibt das Buch „Linux Kommandoreferenz: Shell-Befehle von A bis Z“ aus dem Rheinwerk Verlag.

Der Autor und Linux-Experte Michael Kofler gibt dem Leser nicht nur eine große Auswahl von Kommandos, sondern auch die wichtigsten Optionen mit ausreichenden Erklärungen an die Hand und weist zudem auf die umfangreichen Manual-Seiten (man pages) des Linux-Systems hin. Über den Befehl tldr lassen sich auch direkte Anwendungsbeispiele zu den einzelnen Kommandos ausgeben.

Nicht nur Kommandos mit den entsprechenden Optionen werden thematisiert, sondern auch die wichtigsten Konfigurationsdateien besprochen – genauso wie Tastenkürzel, die den Anwender schneller zum Ziel führen. Das Buch ist dabei wie ein echtes Werkzeug aufgebaut: Dank einer klaren Gliederung nach Themenbereichen wie Systemadministration, Netzwerk oder Programmierung findet man sofort den passenden Befehl. Ein besonderes Highlight des Verlagsdesigns ist das hilfreiche Griffregister am Buchrand, das wie ein Daumenkino funktioniert und das Nachschlagen im Terminal-Alltag enorm beschleunigt.

Leseprobe

Fazit

Dieses Buch besticht durch inhaltliche Tiefe und Aktualität. Das Linux-Ökosystem ist ständig im Wandel, was die mittlerweile 6. Auflage dieses Klassikers deutlich zeigt. Kofler geht auf viele Befehle bzw. Kommandos ein und erklärt sie bildhaft an Beispielen. Rheinwerk liefert hier gewohnt hohe Qualität mit einem robusten Hardcover, das für den täglichen Einsatz auf dem Schreibtisch gemacht ist. Ein Buch, um noch tiefer in die Arbeit mit dem Terminal einzusteigen – egal ob als Einsteiger, Student oder erfahrener Administrator.

Der Beitrag Linux Kommandoreferenz: Shell-Befehle von A bis Z erschien zuerst auf intux.de.

  •  

DietPi 10.4 schließt Sicherheitslücken

Wie bei vielen anderen Projekten auch steht die Abwehr der Sicherheitslücken Copy Fail und Dirty Frag im Mittelpunkt des Updates zu DietPi 10.4. Der Orange Pi 5B erhält zudem ein eigenes Image.

  •  

Proof of Concept: Abfrage der nicht mehr unterstützten AppStreams über die Red Hat Lifecycle API

Im Folgenden möchte ich euch einen Proof of Concept (PoC) vorstellen, der aus einem Gespräch mit einem meiner Kunden entstanden ist.

AppStreams != AppStream

Es geht hier nicht um den offenen Standard AppStream, sondern um die in RHEL 8 und RHEL 9 genutzten AppStreams. Letztere sind ein inzwischen abgekündigtes Konzept zur Bereitstellung verschiedener Paketversionen mit einem definierten Unterstützungszeitraum innerhalb eines Major-Release. Für weitere Informationen hierzu siehe den englischsprachigen Artikel: Red Hat Enterprise Linux Application Streams Life Cycle.

Das Risiko

  • Pakete aus AppStreams werden auf Servern installiert.
  • Die Unterstützung dieser AppStreams endet und niemand merkt es.
  • Es wird Software in der Infrastruktur betrieben, die nie wieder ein Update erhält.

User Story

Im IT-Betrieb möchten wir die Lebenszyklusinformationen der AppStreams über eine API abfragen, deren Unterstützungszeitraum abgelaufen ist. Diese Liste möchten wir mit den auf unseren Servern installierten AppStreams abgleichen, um die Installationen zu identifizieren, die aktualisiert oder migriert werden müssen.

Lösungsansatz

Die gewünschten Informationen können über die Red Hat Lightspeed for RHEL Planning API abgerufen werden.

Wer seine Systeme an der Hybrid Cloud Console registriert hat, kann mit den abgelaufenen AppStreams gleichzeitig eine Liste der Systeme abrufen, auf denen diese installiert sind. Wer seine Systeme dort nicht registriert hat, kann die abgelaufenen AppStreams abfragen und die Informationen mit eigenen Mitteln weiterverarbeiten, um einen Abgleich durchzuführen.

Zur Demonstration habe ich einen Proof of Concept erstellt:

Die Repos beinhalten eine README.md mit der Dokumentation des Bash- und Python-Skripts sowie Links zu weiterführenden Informationen.

Falls euch dieses Beispiel gefällt, gebt ihm doch gerne einen Stern im jeweiligen Repository oder hinterlasst hier einen Kommentar.

Was gibt es dazu sonst noch wissenswertes?

Die in RHEL Lightspeed enthaltene Roadmap/Lifecycle-Anwendung verhält sich für einige User unerwartet. Als installiert werden AppStreams angezeigt, die auf einem System aktiviert sind. Dies ist auch der Fall, wenn ein Module Stream lediglich aktiviert ist, aber kein RPM-Paket aus diesem Stream tatsächlich installiert wurde. Dies kann zu einer Fehlinterpretation führen.

Red Hat liegt ein Feature Request vor, um dieses Verhalten zu ändern und nur AppStreams aufzuführen, deren RPM-Pakete tatsächlich installiert wurden. Mir liegen keine Informationen vor, ob und wann Red Hat dies umsetzen wird.

Des Weiteren liegt Red Hat die Anfrage vor, die Lightspeed Planning App als on-premises App im Satellite bereitzustellen. Auch hier kann ich leider nicht vorhersagen, ob und wann dies umgesetzt wird.

Falls ihr euch dafür interessiert, nehmt bitte Kontakt zum Red Hatter eures Vertrauens auf.

  •  

Wero wirbt mit europäischer Freiheit, setzt aber auf US‑Cloud

Wero möchte Europas Antwort auf große US-Bezahldienste sein. Der Dienst startete 2024 und verspricht schnelle Zahlungen zwischen Nutzern. Hinter dem Projekt stehen zahlreiche Banken aus mehreren Ländern. Die Plattform präsentiert sich als unabhängige Lösung für digitales Bezahlen. Doch ein Blick hinter die Kulissen zeigt ein anderes Bild. Die Betreiber European Payments Initiative (EPI) bestätigen den […]

Der Beitrag Wero wirbt mit europäischer Freiheit, setzt aber auf US‑Cloud erschien zuerst auf fosstopia.

  •  
❌