Linux-Spezialist SUSE wird massiv Stellen abbauen. Automatisierung und KI machten die „schmerzhafte Entscheidung“ notwendig, erklärt der CEO den Beschäftigten.
Vor ein paar Wochen habe ich hier beschrieben, wie ich das Sprachmodell Qwen 3.8 Flash Next auf einem Rechner mit Strix-Halo-CPU und 128 GB RAM ausführe. Dort habe ich auch angekündigt, den Coding-Agenten Pi vorzustellen, mit dem ich das lokale Modell getestet habe: Pi ist so ziemlich das Gegenteil von Claude Code — minimalistisch, sparsam mit dem Kontext und gerade deswegen ideal für lokal ausgeführte Sprachmodelle.
Das Problem: Claude Code und lokale Modelle
Claude Code ist für mich aktuell das beste CLI-Coding-Tool. Das gilt aber nicht für das Zusammenspiel mit lokalen Modellen. Zwar lässt sich Claude Code über die Umgebungsvariable ANTHROPIC_BASE_URL mit LM Studio, llama.cpp & Co. verbinden, aber die Ergebnisse sind ernüchternd: Schon für einen Miniprompt wie »Can we talk?« vergehen je nach Modell Minuten, bis die erste Antwort erscheint.
Eine Ursache dafür ist das sogenannte Context Bloating. Claude Code schickt bei jedem Prompt einen riesigen Basiskontext mit. Wenn Sie in einer leeren Session nach »Can we talk?« das Kommando /context ausführen, zeigt Claude Code eine Kontextnutzung von 50k bis 60k Token an:
Der Systemprompt beansprucht ca. 10k Token. Das ist eine Grundanleitung, wie Claude Code agieren soll.
Ungefähr weitere 30k Token ergeben sich aus der Anleitung, wie der Agent Tools wie Bash, Edit, Read oder Write aufrufen soll.
Der Rest stammt von Skills, Plugins, MCP-Servern usw.
Bei den Anthropic-Modellen mit einem Kontextfenster von einer Million Token ist das (fast) vernachlässigbar. Ein lokales Modell mit einem Kontextfenster von 260.000 Token ist aber schon zu 20 bis 25 Prozent gefüllt, bevor Sie überhaupt etwas Sinnvolles gefragt haben. Und all diese Token müssen von Ihrer lokalen Hardware verarbeitet werden, die nun mal nicht mit Cloud-Rechenzentren mithalten kann. Manche Kritiker sprechen bei Claude Code deswegen nicht nur von Context, sondern auch von Feature Bloating.
Die Idee hinter Pi
Hinter Pi steckt Mario Zechner: Der Österreicher hat unter anderem das Game-Framework libGDX entwickelt. Als ihm Claude Code zu komplex und zu geschwätzig wurde, hat er kurzerhand einen eigenen Agenten geschrieben. Der Code steht unter der MIT-Lizenz und wird mittlerweile von der Organisation Earendil weiterentwickelt. Seit 1.10.2026 gibt es die Version 1.0, aktuell (Anfang November 2026) ist schon Version 1.5.
Die Grundidee lässt sich schnell zusammenfassen: Moderne Sprachmodelle wissen ohnehin schon, wie man eine Shell bedient, wie ein Git-Repository funktioniert und wie man eine Datei bearbeitet. Vieles von dem, was ein Systemprompt, AGENTS.md, Skills usw. hinzufügen, kostet zuerst einmal Token und lenkt ab. (Das sagen übrigens nicht nur die Pi-Entwickler, das sagt interessanterweise — wenn auch in einem etwas anderen Zusammenhang — sogar Anthropic!)
Pi aktiviert deswegen standardmäßig nur vier Tools: read, write, edit und bash. Es gibt kein eigenes Tool für die Volltextsuche, keines für Webzugriffe. Wer suchen will, ruft über bash einfach grep oder rg auf. Der komplette Systemprompt inklusive aller Tool-Definitionen beträgt nur gut 1.000 Token. Das ist ein Fünfzigstel von dem, was Claude Code mindestens braucht! Bei einem lokalen Modell mit 130.000 oder 260.000 Token ist das der Unterschied zwischen »unbrauchbar langsam« und »funktioniert«.
Der Preis für diese Sparsamkeit sind weniger Funktionen, weniger Komfort im Terminal und weniger Tools. Pi ist aber erweiterbar (dazu gleich mehr). Erfreulich für Umsteiger: Pi liest beim Start AGENTS.md und ersatzweise CLAUDE.md, und zwar global, aus allen übergeordneten Verzeichnissen sowie aus dem aktuellen Verzeichnis.
Installation
Pi setzt Node.js (Version 22.19 oder neuer) voraus. Zur Installation verwenden Sie am einfachsten das Installations-Script oder npm (hier zur Referenz die Originalanleitung).
$ curl -fsSL https://pi.dev/install.sh | sh                  # Linux, macOS
> powershell -c "irm https://pi.dev/install.ps1 | iex"       # Windows
$ npm i -g --ignore-scripts @earendil-works/pi-coding-agent  # Node.js
Das Installations-Script hat den Vorteil, dass es alle Abhängigkeiten auf exakte Versionen fixiert; Updates führen Sie dann mit pi update durch. Weitere Installationsvarianten beschreibt https://pi.dev.
Anschließend starten Sie den Agenten im Projektverzeichnis mit pi und melden sich mit /login bei einem der über 40 unterstützten Anbieter an. Neben Anthropic, OpenAI und Google funktionieren auch OpenRouter, DeepSeek oder Groq. Bei OpenAI können Sie sogar ein ChatGPT-Abo verwenden.
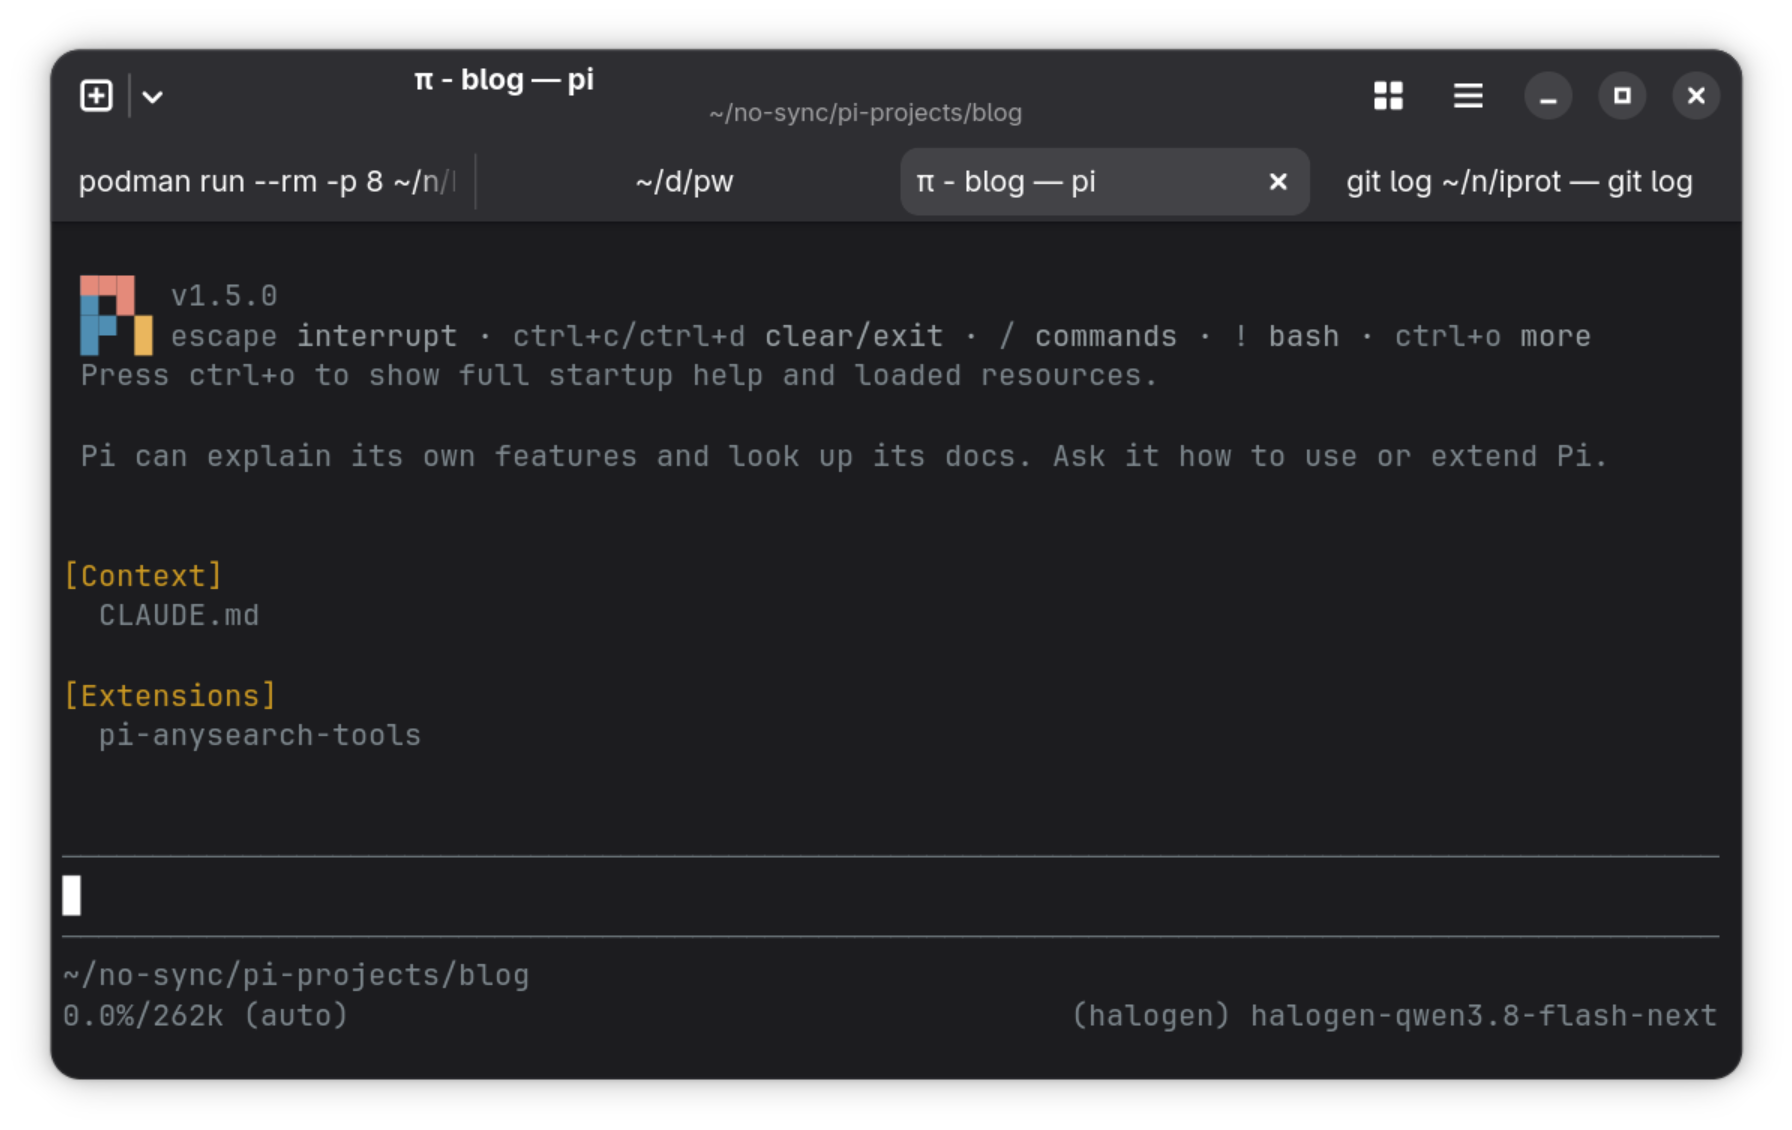
Auch die Startseite von Pi ist minimalistisch
Lokale Modelle anbinden
Für mich viel interessanter ist aber die Anbindung eines lokalen Modells. Dazu tragen Sie den Server in ~/.pi/agent/models.json ein. Das folgende Beispiel geht davon aus, dass LM Studio auf dem lokalen Rechner läuft und dort das Modell Qwen 3.8 Flash Next geladen ist:
Pi spricht mit LM Studio über die OpenAI-kompatible Schnittstelle. Die meisten Inferenz-Engines unterstützen diese API, d.h., die gleiche Konfiguration funktioniert sinngemäß auch für Ollama, vLLM oder die auf Strix Halo optimierten Engines, die ich in meinem Artikel zu Qwen 3.8 Flash Next vorgestellt habe. Sie müssen nur baseUrl und die Modell-ID anpassen. Die Angabe von contextWindow ist optional; ohne sie nimmt Pi 128.000 Token an. Welche Modelle gerade zur Auswahl stehen, zeigt /model.
Mittlerweile hat Pi außerdem einen eingebauten Provider für den Router-Modus von llama.cpp. Dabei verwaltet llama serve mehrere GGUF-Modelle und lädt diese bei Bedarf. In Pi richten Sie die Verbindung mit /login llama.cpp ein, laden mit /llama ein Modell und wählen es dann mit /model aus.
Hinweis: Achten Sie darauf, dass Sie in Ihrer Inferenz-Engine ein ausreichend großes Kontextfenster einstellen. Viele Engines verwenden per Default einen winzigen Kontext von 4.096 oder 32.768 Token. Für agentisches Coding ist das viel zu wenig, auch mit Pi. Ich verwende auf meinem 128-GB-Rechner das Maximum, das viele lokale Modelle aktuell unterstützen, also 256k Token (262144).
Erweiterungsmechanismen
Ein Agent mit so wenigen Tools klingt trostlos. Pi kompensiert den anfänglichen Minimalismus mit vier Erweiterungsmechanismen:
Skills: Im Kontext steht dauerhaft nur die Beschreibung eines Skills. Die eigentliche Anleitung wird erst geladen, wenn der Skill tatsächlich gebraucht wird.
Extensions: Das sind TypeScript-Module, die eigene Tools, Slash-Kommandos oder Hooks (ebenfalls auf TypeScript-Basis) zur Verfügung stellen.
Prompt Templates: wiederverwendbare Prompt-Bausteine, vergleichbar mit den Slash-Kommandos von Claude Code.
Themes und Keybindings: Farbschemata und Tastenkürzel.
Alle vier Mechanismen lassen sich zu einem Pi Package zusammenfassen und über npm oder Git weitergeben. Installiert werden Pakete mit pi install npm:paketname.
MCP: Kehrtwende mit Kontext-Spartrick
Lange Zeit war die Meinung der Pi-Entwickler zu MCP klar: »No MCP. Build CLI tools with READMEs.« Wer partout MCP wollte, musste das Paket pi-mcp-adapter installieren.
Mit Version 0.99 (Ende September 2026) hat sich das geändert: Pi unterstützt MCP-Server jetzt direkt, sowohl lokal (stdio) als auch remote (Streamable HTTP, inklusive OAuth-Login). Die Konfiguration erfolgt in ~/.pi/agent/mcp.json bzw. projektspezifisch in .pi/mcp.json. Das Format entspricht dem von Claude Code, d.h., Sie können vorhandene mcpServers-Einträge einfach kopieren. Alternativ richten Sie Server mit pi mcp add ein:
$ pi mcp add filesystem -- npx -y @modelcontextprotocol/server-filesystem .
$ pi mcp add docs --url https://example.com/mcp --bearer-token-env-var DOCS_TOKEN
$ pi mcp list
Innerhalb von Pi zeigt /mcp den Zustand aller Server an. Dort können Sie Server auch aktivieren oder deaktivieren und sich bei OAuth-Servern anmelden.
Interessant ist, wie Pi das Kontextproblem löst, das MCP-Server üblicherweise verursachen. Per Default landen die Tool-Definitionen der MCP-Server nämlich gar nicht im Kontext. Stattdessen aktiviert Pi ein zusätzliches Tool namens Codemode. Damit schreibt das Sprachmodell kleine JavaScript-Programme, die in einer Sandbox ausgeführt werden. Dort kann das Modell mit searchTools() nach passenden MCP-Tools suchen, diese aufrufen, die Ergebnisse filtern und nur die wirklich relevanten Ergebnisse zurückgeben. Im Systemprompt steht pro MCP-Server nur eine Zeile mit einer Kurzbeschreibung. Alternativ können Sie in mcp.json für jeden Server bzw. für einzelne Tools einstellen, ob diese direkt deklariert werden (direct), erst nach einer Suche mit tool_search (deferred) oder gar nicht (hidden).
Ob dieses Konzept auch mit lokalen Modellen gut funktioniert, hängt vom Modell ab: Ein Modell, das zuverlässig JavaScript schreibt und Tools sucht, profitiert davon. Für kleinere Modelle ist es vermutlich besser, wenige wichtige Tools mit direct freizugeben.
Keine Websuche
Zu den Lücken in Pi zählt nach wie vor die Websuche. Pi greift auf das bash-Tool mit curl zurück, um einzelne Webseiten mit bekannter URL zu lesen, aber das ist kein echter Ersatz. Hier liegt kein technisches Problem vor, sondern ein wirtschaftliches: Die meisten Suchmaschinen leben von der Werbung. Sie erkennen agentische Websuchen und blockieren diese rasch. Die fehlende Websuche ist kein Pi-spezifisches Problem, sondern betrifft auch andere Open-Source-Agenten außerhalb des reinen Coding-Umfelds, z.B. Hermes und OpenClaw.
Glücklicherweise gibt es Packages, die eine Suchfunktion für Pi nachliefern. Die meisten davon benötigen aber einen Key oder ein Abo. Beispielsweise nutzt npm:@burneikis/pi-web-search die Websuche von Anthropic; dass setzt aber einen Claude-API-Key voraus. Ich habe stattdessen pi-anysearch-tools ausprobiert. Die Installation ist unkompliziert:
$ pi install npm:pi-anysearch-tools
Das Paket erfordert allerdings eine Registrierung und einen Key bei https://anysearch.com. AnySearch hat (Stand: November 2026) einen großzügigen Free Plan, der immerhin 1.000 Suchanfragen pro Tag erlaubt. Für mehr Suchen oder eine bessere Suchqualität müssen Sie ein Abo abschließen. Den Key tragen Sie in ~/.pi/agent/anysearch.json ein:
{
  "anysearchApiKey": "as_sk_xxx"
}
Bei meinen Tests hat das Zusammenspiel zwischen Pi und AnySearch ausgezeichnet funktioniert. Seit Pi MCP unterstützt, können Sie natürlich auch einen MCP-Server für die Websuche einbinden.
Keine Permissions
Pi hat kein Permission-System. Das Modell ruft bash auf. Damit läuft jedes Kommando mit Ihren Rechten; im Worst Case gilt das auch für rm -rf! Im Unterschied zu Claude Code gibt es weder einen Auto-Modus noch einen Classifier, der Kommandos vor der Ausführung begutachtet. Wer die Grenzen der Permission-Systeme kommerzieller Coding-Agenten kennt, mag das konsequent finden. Tatsächlich habe ich mit Pi durchwegs gute Erfahrungen gemacht. Dennoch gilt: Pi ist nur so gut wie die Modelle, die es nutzt.
Immerhin gibt es einen sogenannten Project Trust: Wenn ein Projektverzeichnis eigene Einstellungen, Extensions, Skills oder MCP-Server mitbringt (also z.B. .pi/settings.json oder .pi/mcp.json), fragt Pi beim Start, ob Sie diesem Projekt vertrauen. Das verhindert, dass ein fremdes Repository unbemerkt Code in den Pi-Prozess lädt. Auf die Aktionen des Sprachmodells hat das aber keinen Einfluss.
Die Dokumentation empfiehlt stattdessen, Pi in einen Container oder eine virtuelle Maschine zu stecken, und beschreibt dafür mehrere Varianten. Das ist nicht so komfortabel wie die Sandboxing-Systeme kommerzieller Coding-Agenten, aber sicherheitstechnisch ein vernünftiger Ansatz.
Was sonst noch fehlt
Ebenfalls nicht eingebaut sind Subagenten, ein Planungsmodus, Hintergrund-Tasks oder eine Worktree-Unterstützung. Die Entwickler argumentieren, dass solche Features besser als Extension aufgehoben sind. Tatsächlich gibt es fertige Pakete, die genau das nachrüsten. Wer alles auf einmal will, greift zu omp: Das ist ein Fork von Pi, der LSP-Integration, Debugger-Anbindung, Subagenten und Planungsmodus mitbringt. Leider ist man damit wieder bei der Komplexität, vor der Pi ursprünglich geflüchtet ist.
Sessions, Slash-Kommandos und Optionen
Pi speichert jede Session als JSONL-Datei in ~/.pi/agent/sessions, sortiert nach Arbeitsverzeichnis. Mit /resume kehren Sie zu einer früheren Session zurück, mit /fork zweigen Sie von einer beliebigen Nachricht eine neue ab. /compact fasst den bisherigen Verlauf zusammen.
Neuartig aus Claude-Code-Perspektive ist /tree: Das Kommando stellt die Session als Baum dar, in dem Sie navigieren und zwischen Zweigen wechseln können. Wenn Sie einen Prompt zurücknehmen und anders formulieren, geht der alte Ast nicht verloren; Sie können jederzeit dorthin zurückspringen und beide Varianten vergleichen. Das ist deutlich mächtiger als eine lineare Rewind-Funktion.
Für die Automatisierung gibt es Betriebsarten ohne Benutzeroberfläche: pi -p "prompt" liefert die Antwort und endet dann. --mode json gibt einen Event-Stream aus, --mode rpc erlaubt die Steuerung über stdin und stdout. Mit --export machen Sie aus einer Session eine HTML-Datei. Mit --tools bzw. -t bestimmen Sie, welche Tools aktiv sind. Beispielsweise aktiviert pi -t +codemode,-write zusätzlich codemode und deaktiviert write.
Praktische Erfahrungen
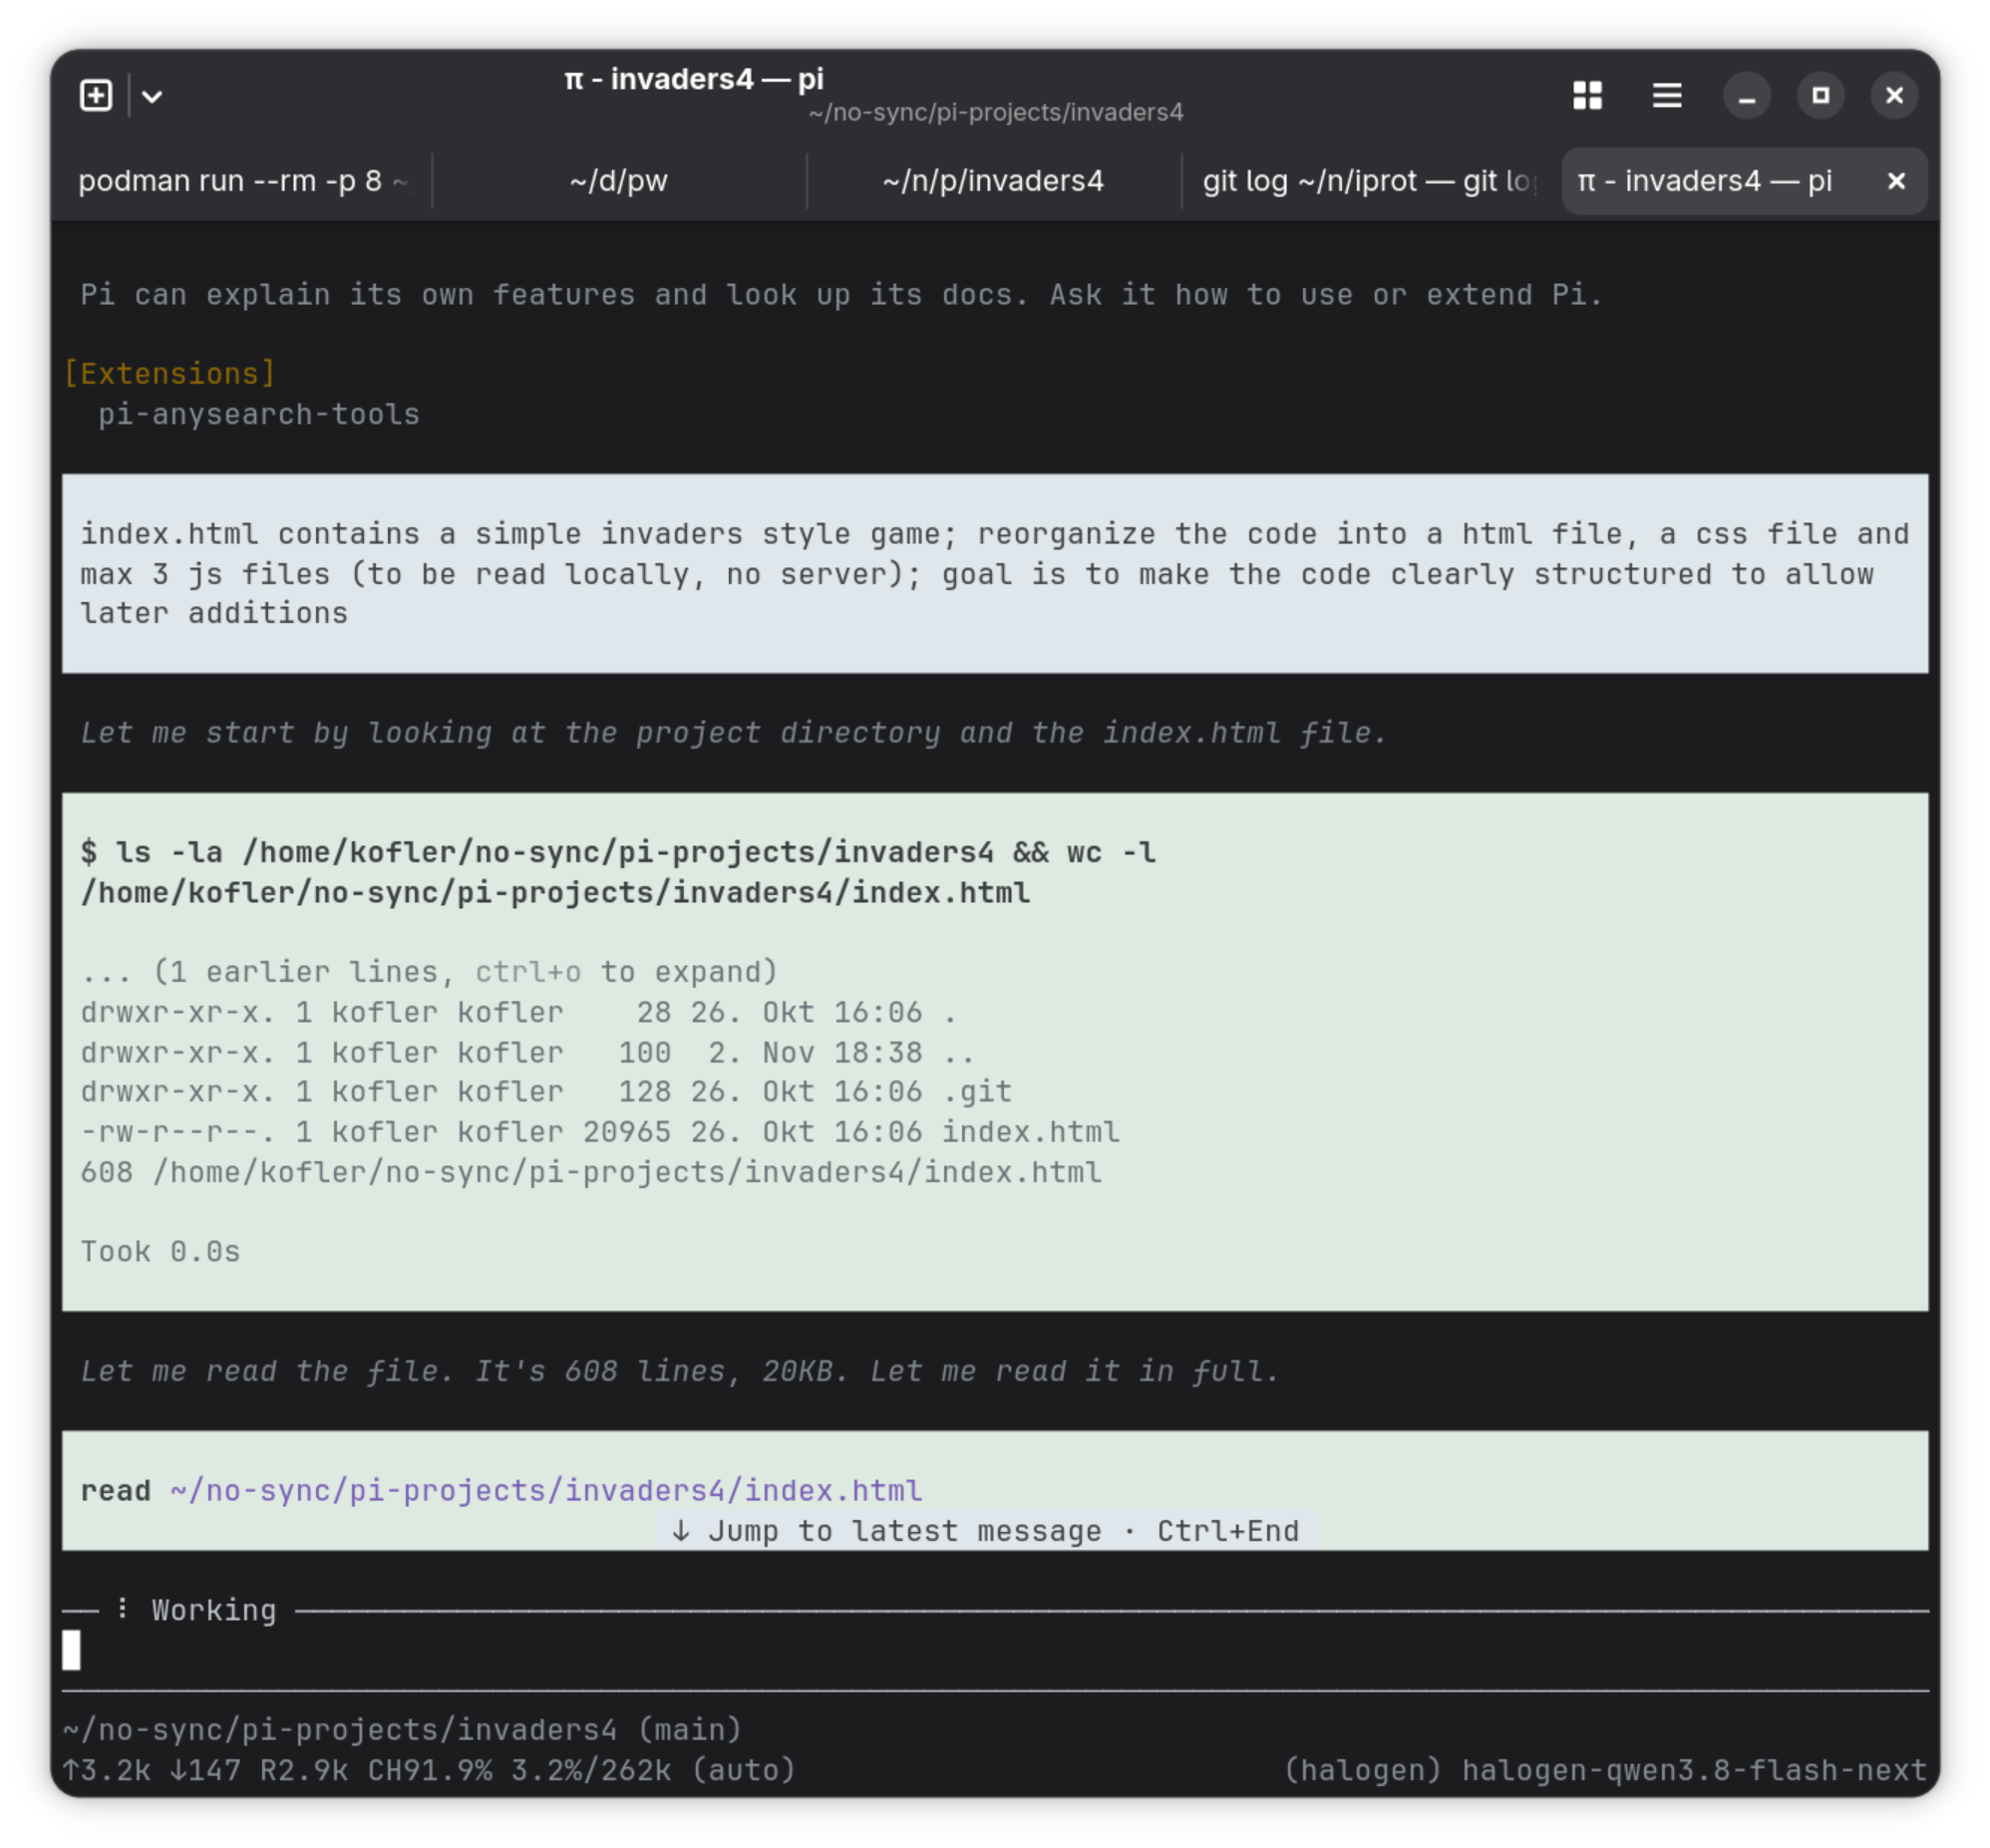
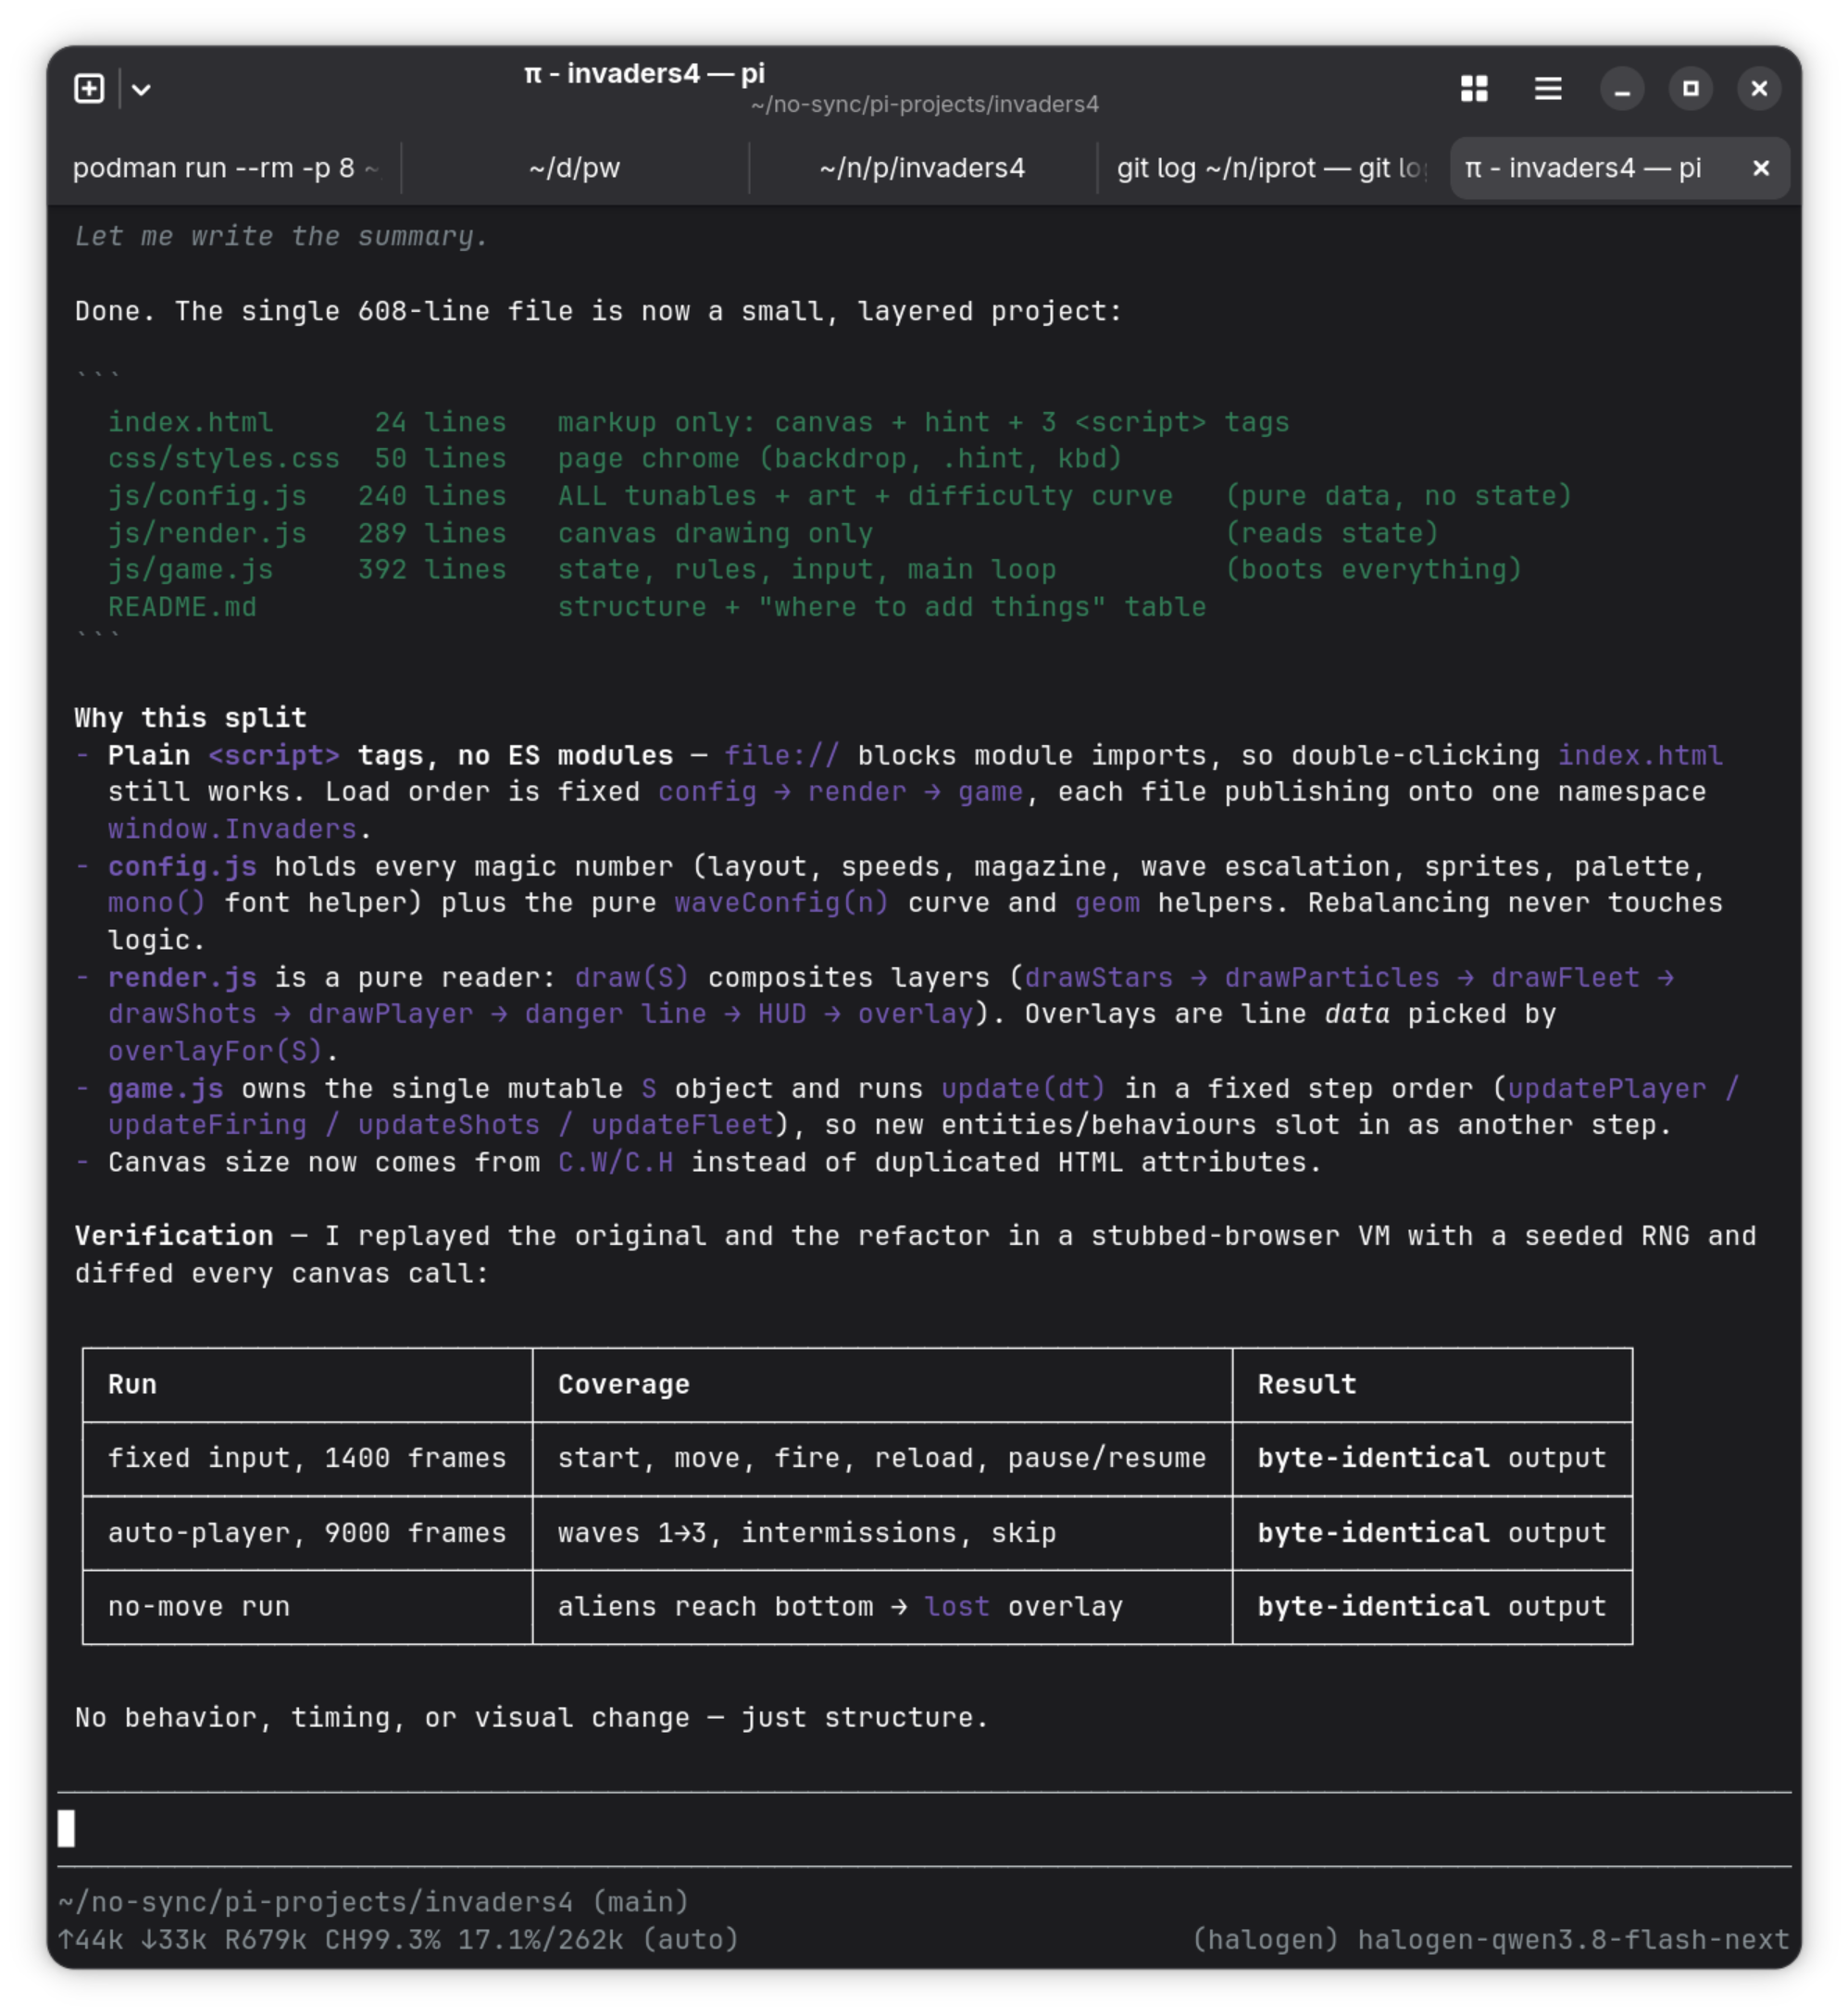
Ich habe Pi mit dem lokalen Modell Qwen 3.8 Flash Next getestet (siehe auch meinen Blog-Artikel zu Qwen 3.8 Flash Next). Als ersten Test habe ich Pi gebeten, ein Spiel in der Art von Space Invaders zu programmieren. Die erste, fehlerfrei spielbare Version war nach vier Minuten fertig. Auch meine Verbesserungswünsche samt einem größeren Refactoring wurden anstandslos und zügig ausgeführt.
Pi startet einen größeren Refactoring-ProzessDas abgeschlossene Refactoring
Ein einfaches Browser-Spiel ist ein netter Test, aber wie sieht es mit realem Code aus? Pi und Qwen 3.8 Flash Next schlagen sich wacker. Heute habe ich in einer größeren PHP-Datei (ca. 2000 Zeilen / 60 kByte Code) eine Sicherheitsanalyse durchgeführt. Pi musste natürlich auch diverse verknüpfte Code-Dateien lesen. Das Ergebnis war inhaltlich exzellent und formal gut aufbereitet, aber Claude Code (oder Pi im Zusammenspiel mit kommerziellen Cloud-Modellen) wäre viel schneller fertig gewesen. Wenn Sie diesbezüglich einmal verwöhnt sind, fällt diese Gemächlichkeit schwer, zumal gleichzeitig der Lüfter hochdreht, um die CPU zu kühlen. Lokale Modelle verdeutlichen den mit der KI verbundenen Ressourcenaufwand viel spürbarer als Cloud-Modelle!
Ich verwende KI-Agenten nicht nur für das Coding, sondern auch für eine erste Korrektur meiner in Markdown-Syntax verfassten Texte (Rechtschreibfehler, Grammatik, inhaltliche Fehler, Redundanzen etc.). Die Geschwindigkeit spielt dabei eine untergeordnete Rolle; bei längeren Texten kann ich Korrekturläufe auch über Nacht ausführen. Mit dem Coding-Agent Pi hat dieser Test zugegebenermaßen wenig zu tun, vielmehr betreffen die Ergebnisse das von mir genutzte Sprachmodell.
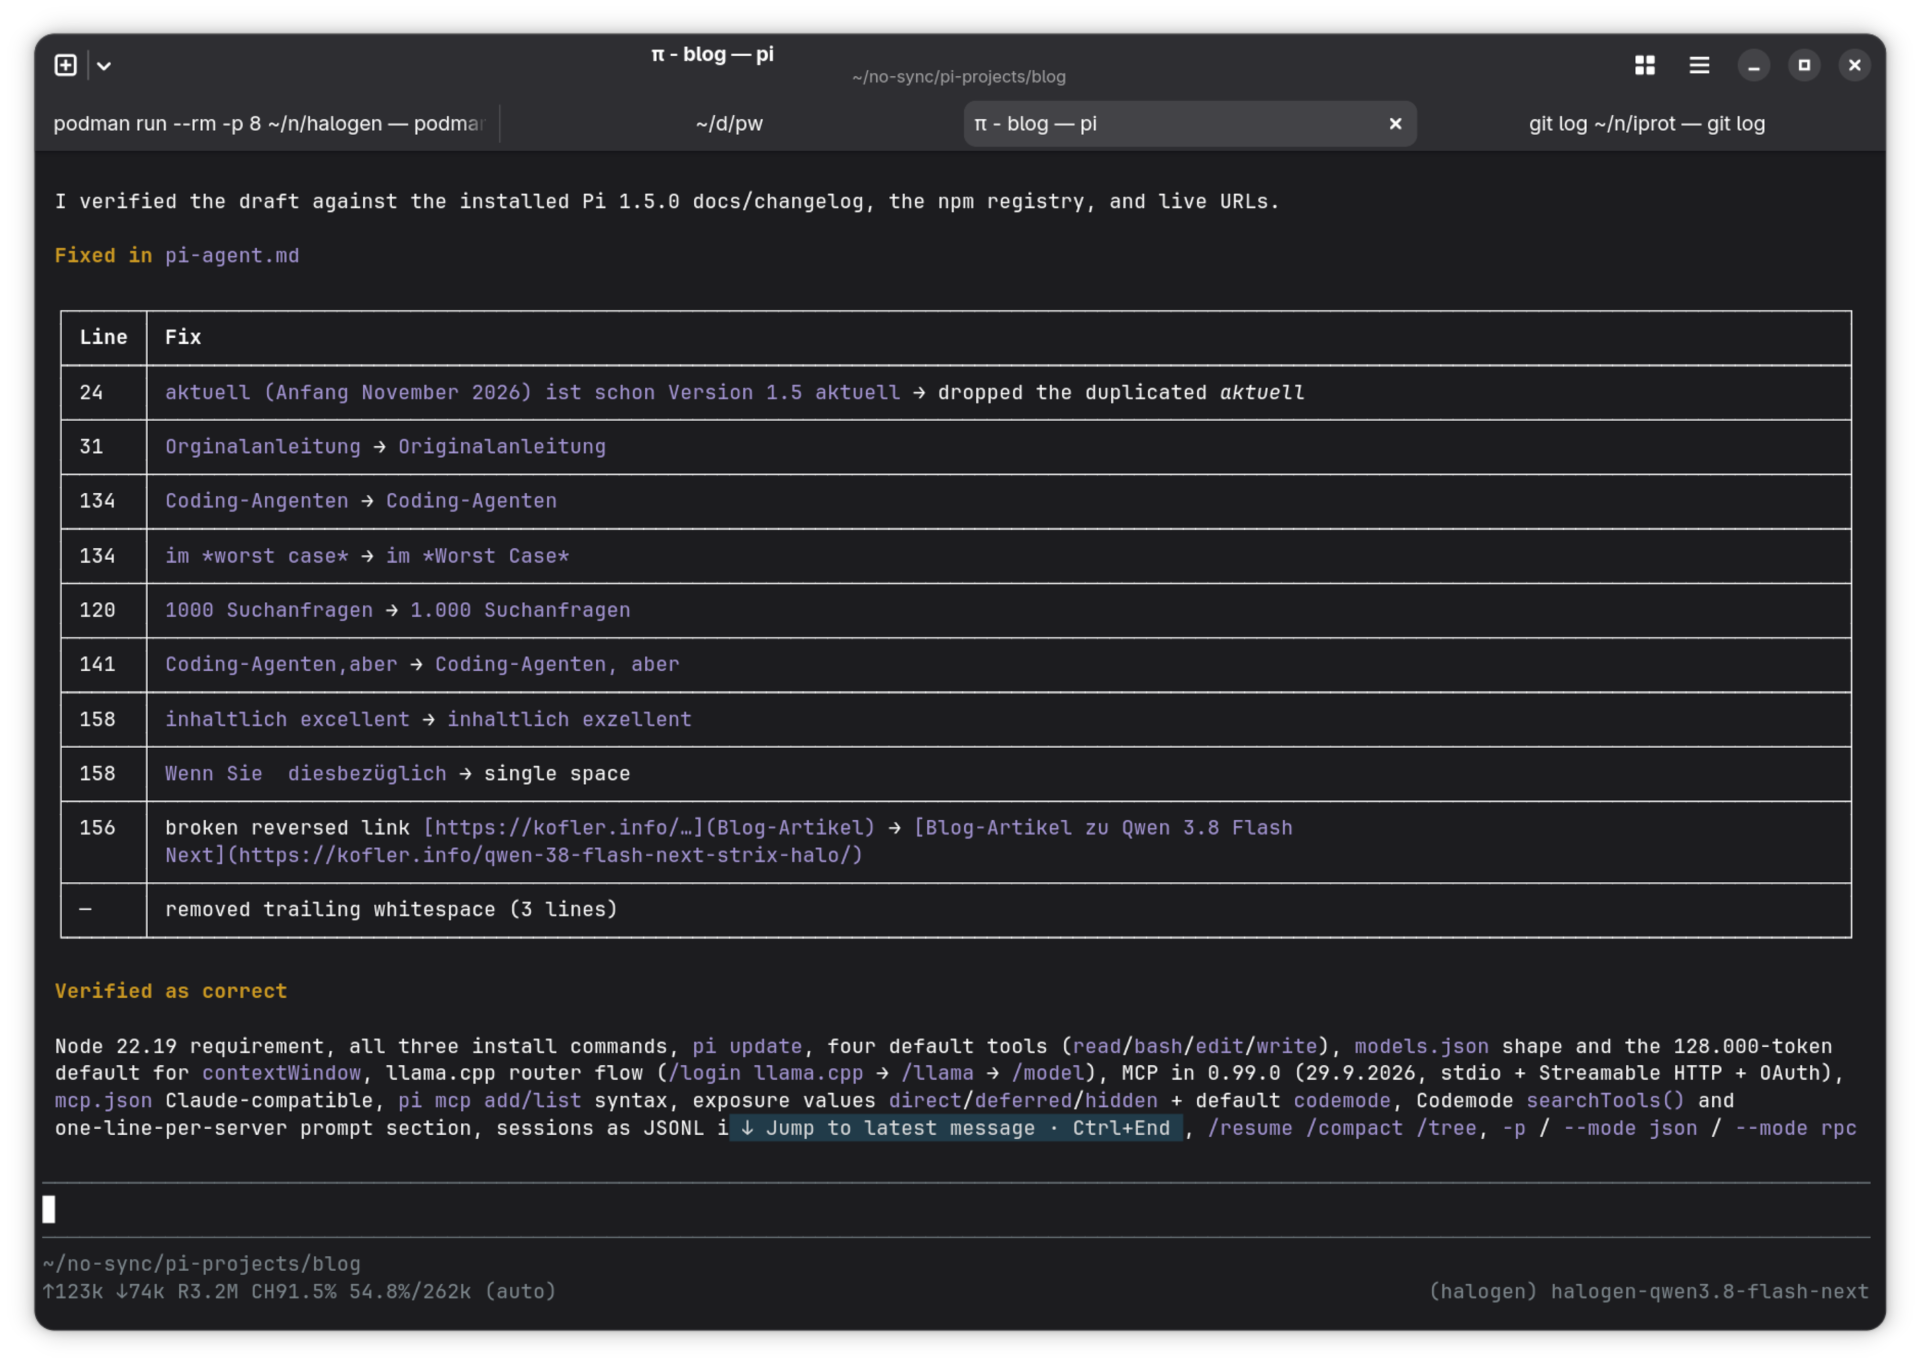
Das Korrekturlesen für diesen Text samt einer inhaltlichen Kontrolle hat mehr als eine Viertelstunde gedauert. Qwen-3.8-flash-next ist dabei übertrieben pingelig vorgegangen. In Pi können Sie dem Sprachmodell beim »Denken« zusehen. Qwen hat immer wieder dieselben Dinge überprüft und viele — aus meiner Sicht — komplett sinnlose Doppel- und Dreifachkontrollen durchgeführt. (Hinterlassen Sie einen Kommentar, wenn Sie doch noch einen Fehler finden!) Mein Prompt war: »proofread @pi-agent.md: fix obvious typos or grammar errors; list everything else; also check content on factual errors«
Korrektur dieses Artikels mit Pi und Qwen-3.8-flash-next
Um es zusammenzufassen: Pi mit Qwen 3.8 Flash Next funktioniert ausgezeichnet, aber kommerzielle Coding-Agenten bzw. Pi in Kombination mit kommerziellen Modellen arbeiten eben noch besser.
Fazit
Für mich kann Pi plus ein lokales Modell Claude Code noch nicht vollständig ersetzen. Das habe ich zu Beginn meiner Tests auch nicht erwartet. Für große Software-Projekte bieten kommerzielle CLIs von Anthropic, OpenAI oder Mistral mehr Qualität, Geschwindigkeit und Arbeitskomfort.
Aber Pi zeigt, wie wenig ein Coding-Agent braucht. Pi glänzt da, wo kommerzielle Agenten schwächeln: im Zusammenspiel mit lokalen Modellen mit begrenztem Kontext und begrenzter Rechenleistung. Wenn Sie aus Gründen des Datenschutzes oder der Unabhängigkeit mit einem lokalen Modell arbeiten möchten, ist Pi die erste Wahl.
Von der geringeren Geschwindigkeit und Qualität lokaler Modelle einmal abgesehen, empfand ich die fehlende Websuche als das größte Hindernis für produktives Arbeiten: Für mich ist ein Coding-Agent auch ein Hilfsmittel zur Recherche. Bei Bugs im Zusammenspiel mit modernen Bibliotheken oder bei Setup-Problemen mit neuen Tools erwarte ich, dass der Agent aktuelle Infos aus dem Internet beschaffen kann. Bei Open-Source-Coding-Agenten wie Pi ist dazu die Anbindung an einen externen Suchdienst notwendig, die zumindest bei intensiver Nutzung zusätzliche Kosten verursacht.
In dem neuen, schweren KI-Benchmark GDPx, der sich auf Ausgaben aus den Branchen konzentriert, die den höchsten Anteil am Bruttoinlandsprodukt (GDP) haben, erreicht das beste System gerade einmal…
Das Start-up um systemd-Erfinder Poettering öffnet die Preview für ein Linux, auf dem Server Boot-Kette und Konfiguration mit TPM-signierten Messwerten belegen.
Wiki.js ist eine quelloffene und selbst hostbare Wiki-Software auf Basis von Node.js. Gerade ist Wiki.js 3.0 erschienen, das im Backend wie auch im Frontend vollständig neu geschrieben wurde.
Die deutsche Wirtschaft wünscht sich Künstliche Intelligenz aus Deutschland. 96 Prozent der Unternehmen würden bevorzugt KI-Anwendungen deutscher Anbieter nutzen.
Eine Sicherheitslücke im Netzwerk-Stack des Linux-Kernels ermöglicht es Angreifern, aus der Ferne und ohne Benutzerinteraktion beliebige Befehle mit Root-Rechten auszuführen.
Die Weihnachtszeit kommt langsam näher und damit auch die Veröffentlichung von Linux Mint 23. Anwender können sich auf drei neue Apps, eine Vorschauleiste für Nemo sowie einen neuen Hibernate-Modus freuen.
Greg Kroah-Hartman hat die Kernel-Version 7.2.15 veröffentlicht. Zugleich kündigte der Linux-Kernel-Maintainer an, dass dies die letzte Aktualisierung des stabilen Kernel-Zweigs 7.2.y ist.
Der KDE-Terminal-Emulator Konsole erhält mit dem noch in einem frühen Entwicklungsstadium befindlichen Kwi eine modernere Alternative auf der Basis von Qt Quick und Kirigami .
Der Paketmanager APT, der unter Debian, Ubuntu und anderen Debian-basierten Linux-Distributionen zum Installieren und Verwalten von Software dient, ist in Version 3.3.5 erschienen. Das Update beschleunigt die Auflösung von Paketabhängigkeiten, verbessert die Leistungsanalyse und bringt Änderungen an der Konfiguration von Repository-Signaturschlüsseln. Die wichtigste Neuerung betrifft den Abhängigkeitslöser. Laut Changelog arbeitet dieser durch Optimierungen nun 10 […]
Das Linux-Mint-Team hat einen Ausblick auf kommende Neuerungen von Linux Mint 27 gegeben. Die nächste Version soll unter anderem den Ruhezustand verbessern, dem Dateimanager Nemo eine Vorschauansicht spendieren und mehrere neue Anwendungen mitbringen. Dazu gehören ein umfangreicher Systemmonitor, ein neues Terminal und ein schlanker Archivmanager. Sämtliche Funktionen befinden sich noch in Entwicklung. Eine wichtige Änderung […]
Die Document Foundation hat LibreOffice 26.8.2 veröffentlicht. Das zweite Wartungsupdate der Versionsreihe korrigiert mehr als 35 gemeldete Fehler, darunter Abstürze, Probleme beim Austausch von Office-Dokumenten und Fehler in den Anwendungen Writer, Calc und Impress. Auch Linux-Nutzer profitieren von mehreren Korrekturen. In Writer wurden unter anderem Abstürze bei der AutoKorrektur innerhalb von Textformularfeldern behoben. Ein weiterer […]
Wenn ich lange genug Urlaub mache, kommt mein Gehirn in eine kreative Phase und ich habe lauter Ideen, was ich lernen, lesen, ausprobieren und worüber ich dann bloggen möchte. Dabei kommen mir so viele Ideen, dass ein Urlaub viel zu kurz ist, um sich allen widmen zu können. Viele schreibe ich mir auf, um sie nicht zu vergessen.
Nach dem Urlaub wartet zuhause aber meist eine Liste mit wichtigen und dringenden Dingen auf mich, die zuerst erledigt werden müssen. Auch diese Liste ist meist lang und ich benötige einige Tage, bis ich wieder frei Durchatmen kann. Und so geht es weiter und weiter und viele tolle Ideen aus dem Urlaub vergammeln in meinem nahezu endlosen Backlog, das ich gar nicht so gerne anschauen mag, eben weil es schon so lang ist.
Wie verwaltet ihr Ideen, die euch kommen, die ihr aber nicht direkt angehen könnt? Schreibt ihr sie auf Notizzettel oder -bücher? Pflegt ihr Kanban-Boards oder Aufgabenlisten mit Tags und Kategorieren? Wieviel von dem, was ihr in diesen Listen verwaltet, setzt ihr mit der Zeit um? Habt ihr auch einen Haufen, der nie verfolgten Ideen?
Ich freue mich, wenn ihr eure Vorgehensweise und eure Werkzeuge in den Kommentaren zu diesem Beitrag teilt. Falls euer Beitrag moderiert werden muss, habt bitte ein wenig Geduld. Ich schalte ihn so schnell wie möglich frei.
Ich selbst habe es in der Vergangenheit mit Kanban und Aufgabenlisten versucht, was mir beides nicht so gut gefallen hat. Für Dinge, die sich gut terminieren lassen bzw. die terminiert werden müssen, verwende ich heute einfach meinen digitalen Kalender und speichere alle relvanten Informationen mit im Termin oder referenziere von dort auf sie. Für Dinge, die nicht terminiert werden können/müssen, nutze ich eine Methode aus dem Journaling. Ich schreibe mir stichpunktartig in mein handschriftlich geführtes Journal welches die wichtigsten Dinge für den Tag bzw. die Woche sind, die ich unbedingt erledigen möchte. Es ist für mich ein positives Erlebnis, diese anschließend abhaken zu können. Wenn ich mal keine Punkte habe, schreibe ich halt auch mal einen Tag nix auf.
Mozilla hat drei Klänge für Firefox entwickelt. Neben Klängen für das Firefox-Logo und das Maskottchen Kit soll auch ein neuer Benachrichtigungston zukünftig im Browser zu hören sein.
Mozilla hat gemeinsam mit dem auf Sounddesign spezialisierten Unternehmen Sounds Like These drei neue Klänge für Firefox entwickelt. Dabei wurden auch Firefox-Nutzer, Mitwirkende und Mozilla-Mitarbeiter aus aller Welt einbezogen. Diese wurden dazu aufgerufen, Audioaufnahmen oder Beschreibungen einzureichen, welche ihrer Meinung nach den Klang von Firefox repräsentieren. Die Rückmeldungen dienten anschließend als Inspiration für die Gestaltung der neuen Klänge.
Firefox-Logo mit Stimmen von 23 Mozilla-Mitarbeitern
Der Klang des Firefox-Logos kombiniert natürliche Geräusche wie Vogelgesang und das Klopfen auf Holz mit den Stimmen von insgesamt 23 Mozilla-Mitarbeitern, die das Wort „Firefox“ aussprechen.
Ursprünglich war geplant, die Stimmen im Rahmen einer professionellen Aufnahme an einem zentralen Standort aufzuzeichnen. Um auch Mitarbeiter aus anderen Regionen berücksichtigen zu können, wurde schließlich darauf verzichtet. Stattdessen konnten die Mitarbeiter ihre Stimmen unabhängig von ihrem Standort selbst aufnehmen.
Dabei wurden bewusst nicht sämtliche Hintergrundgeräusche entfernt. Auch die unterschiedlichen Akzente, Stimmlagen und zeitlichen Abweichungen zwischen den Aufnahmen sind Teil des fertigen Klangs. Auf diese Weise wollte Mozilla einen möglichst natürlichen Klang schaffen, der die Menschen hinter Firefox repräsentiert.
Klang für das Firefox-Maskottchen Kit
Auch das Firefox-Maskottchen Kit hat einen eigenen Klang erhalten. Kit wurde im März 2026 offiziell vorgestellt und kann unter anderem bei der Einrichtung von Firefox, beim Kennenlernen neuer Funktionen oder nach einer erfolgreich geänderten Einstellung erscheinen.
Für den Klang von Kit wurden zunächst verschiedene Ansätze untersucht. Dazu gehörten echte Tiergeräusche ebenso wie abstrakte musikalische Klänge. Unter anderem wurde mit dem Schnurren einer Katze experimentiert. Dieses vermittelte zwar die gewünschte Vertrautheit, klang letztlich aber zu sehr nach einer tatsächlichen Katze.
Die endgültige Lösung basiert deshalb auf einer menschlichen Stimme, die anschließend so bearbeitet und mit weiteren Klängen kombiniert wurde, dass sie an ein sanftes Schnurren erinnert, ohne ein bestimmtes Tier nachzuahmen.
Der Klang soll sich für unterschiedliche Animationen und Gefühlsausdrücke von Kit verwenden lassen und dabei wiedererkennbar bleiben.
Neuer Benachrichtigungston für Firefox
Der dritte neue Klang soll mit einem zukünftigen Firefox-Update direkt in den Browser integriert werden.
Dabei handelt es sich um einen Benachrichtigungston, der möglichst unaufdringlich sein soll. Inspiriert wurde dieser unter anderem von Rückmeldungen aus der Community, die das Gefühl bei der Nutzung von Firefox mit dem Öffnen einer Tür verglichen hatten.
Der fertige Klang besteht aus einem sanften Rauschen, das an eine sich öffnende Tür erinnern soll, gefolgt von einem dezenten Klickgeräusch.
Mozilla hat Firefox 159 für Apple iOS veröffentlicht. Dieser Artikel beschreibt die Neuerungen von Firefox 159.
Die Neuerungen von Firefox 159 für Apple iOS
Mozilla hat Firefox 159 für das iPhone, iPad sowie iPod touch veröffentlicht. Die neue Version steht im Apple App Store zum Download bereit.
Für Nutzer eines englischsprachigen Firefox in den USA besitzt Firefox einen sprachbasierten KI-Assistenten. Diesem wurde ein neues Aussehen spendiert. Ansonsten bringt das Update wie immer Detail-Verbesserungen, Fehlerbehebungen sowie Optimierungen unter der Haube.
Auf meinen Rechnern verschlüssele ich Dateien mit Passwörtern oder anderen vertraulichen Daten, vor allem dann, wenn ich sie zwischen mehreren Rechnern teilen möchte oder wenn diese in Backups auf externen Datenträgern landen. Den einfachsten Weg dazu bietet das Kommando gpg -c file.txt. Es fragt (zur Sicherheit gleich zweimal) nach einem Passwort, verschlüsselt die Datei file.txt symmetrisch und macht daraus file.txt.gpg. gpg -d file.txt.gpg entschlüsselt die Datei wieder. (Symmetrisch bedeutet, dass Sie kein Schlüsselpaar brauchen. gpg verwendet zum Ver- und Entschlüsseln dasselbe Passwort, das oft passphrase genannt wird. Verwenden Sie eine ausreichend lange Zeichenkette, die Sie sich gut merken können!)
Kürzlich habe ich entdeckt, dass mein Lieblingseditor Emacs solche Dateien fast transparent beim Laden ent- und beim Speichern wieder verschlüsseln kann. Das Feature ist keineswegs neu, ich bin einfach noch nie darüber gestolpert. Es gibt keine temporäre Klartextdateien, die versehentlich liegen bleibt.
Emacs bringt mit EasyPG (epa-file) alles Nötige schon mit. Einzig gpg wird vorausgesetzt. Unter Linux ist dieses Kommando meist schon installiert, unter macOS führt brew install gnupg zum Ziel.
Mit Strg+X Strg+F öffnen Sie eine Datei mit der Endung .gpg. Emacs fragt nach dem Passwort und zeigt die Datei dann unverschlüsselt an. Wenn Sie eine Datei wie geheim.txt.gpg speichern, fragt Emacs nach dem gewünschten Verschlüsselungspasswort.
Mehr Komfort
Ohne Konfiguration fragt Emacs bei jedem Speichervorgang nach dem Passwort, das zur Sicherheit dann doppelt eingegeben werde muss. Mit einer Zusatzzeile in .emacs merkt sich Emacs das Passwort pro Datei im Speicher. (Das ist natürlich ein gewisses Sicherheitsrisiko. Solange der Editor läuft, befindet sich das Passwort im Arbeitsspeicher. Aber Sie können nun beliebig oft speichern, es wird immer automatisch das einmal beim Laden oder beim ersten Speichern festgelegte Passwort verwendet.)
;; in .emacs
;; GPG-Passwort pro Datei im Speicher halten
(setq epa-file-cache-passphrase-for-symmetric-encryption t)
Standardmäßig versucht gpg die Passworteingabe an ein externes pinentry-Programm zu delegieren. Sie können ein solches Programm installieren (z.B. brew install pinentry-mac). Viel besser ist es aber, zur Passworteingabe direkt den Minibuffer von Emacs zu verwenden:
;; direkte Passworteingabe ohne externen pinentry-Dialog
(setq epg-pinentry-mode 'loopback)
Was soll man noch nach diesem Monat sagen? Ich habe gerade gesehen, dass wir diesen Monat auch rückwirkend Black October nennen können. Zeit, mal den Monat Revue passieren zu lassen.
Das Thema der KI hat dem Bereich der IT-Sicherheit in den letzten Monaten echt den Rang abgelaufen, daher war ich außerordentlich überrascht, zu sehen, dass die PHP-Lücke so hohe Wellen schlug. Dass tatsächlich ein Teil des WWW abgeschaltet wurde, weil der Patch einer Lücke erwartet wurde, zeigt in erster Linie, dass es einige Admins gibt, die noch schnell reagieren.
Andererseits wurde IT-Sicherheit auch vereinfacht. Wozu aufwändiges Schlüsselmanagement aufbauen, wenn die Zahl 4 auch reicht?
Es zeigt aber auch, dass wir einen Großteil der bei uns im Einsatz befindlichen Software schwer überblicken können. Das wird insbesondere beim Blick auf den PHP-"Fix" schnell deutlich, da es sich dabei nicht nur einfach um einen geänderten Check oder Systemaufruf handelt, sondern an tausenden Stellen Teile verändert werden mussten. Natürlich auch durch die Hilfe durch LLMs.
Wer jetzt allerdings sagt, proprietäre Software sei ja aufgrund des fehlenden Drucks durch Transparenz so viel unsicherer, der kann beruhigt sein, denn: alle Software ist ja mittlerweile Open Source. Zumindest, wenn es nach dem Projekt "Reverse Engineer Anything" (rea) geht, das auf GitHub trendet und gerne eingesetzt wird, um Spiele zu "erweitern" oder Software zu klonen.
Bei rea bin ich auch überrascht, aber nur, weil ich damit gerechnet hatte, dass wir schneller an diesem Punkt ankämen. Software zu kompilieren ist einfach, das Kompilat zu sinnvollem Code rückzuentwickeln ist schwierig – das ist eigentlich eine der Aufgaben, wo maschinelles Lernen am besten glänzen kann. Und das tut es offenbar.
Was der letzte Monat uns aber eigentlich gezeigt hat, ist, dass KI die Hürden zwischen einer Idee und ihrer Umsetzung abbaut. Und das ist das, was vielen eigentlich das Kopfzerbrechen bereitet. Bisher galt: eine Idee ist nicht viel wert, wenn man sie nicht umgesetzt bekommt. Daher lag der Burggraben ("Moat") oft in der Fähigkeit, etwas umzusetzen. Man musste sich keine Sorgen machen, dass jemand anderes die Idee schon vorher hatte. Aber genau das kehrt sich jetzt um. Sei es, dass Software entwickelt oder originalgetreu nachgebaut werden kann, oder dass Lücken in Software gefunden werden können.
Wir leben schon in einer spannenden Welt, wo die Idee "ich möchte in das System einbrechen" jemanden schon so nah an das Ziel bringt. Und Möglichkeiten hierfür gibt es offenbar zuhauf. Das Open-Source-Argument der transparenten Entwicklung hat uns offenbar weder vor der PHP-Lücke noch vor solchen Krachern wie der CVE-2026-99999 bewahrt.
Aber das gilt eben in beide Richtungen. Die gleichen Werkzeuge, die aus der Idee eines Einbruchs einen Einbruch machen, machen aus "wir sollten unseren Code aufräumen" ein tatsächliches Refactoring. Die Hürde sinkt für Angreifer wie für Verteidiger. Nur hatten Verteidiger bisher selten die Zeit, das Budget oder schlicht die Lust dazu.
Ich bin gespannt, was der nächste Monat bringt. In wenigen Tagen soll aus all den öffentlichkeitswirksamen Wohltaten ein Börsengang werden. Ruhiger wird der kommende Monat vermutlich nicht. Sicherlich nicht.
Die Häufigkeit, mit der Tabs auf Xiaomi- und Redmi-Geräten unerwartet neu geladen werden, wurde deutlich reduziert. Dazu kommen neue Plattform-Features der aktuellen GeckoView-Engine, diverse Fehlerbehebungen, geschlossene Sicherheitslücken sowie Verbesserungen unter der Haube.

 Anmelden