Die Linux-Kommandoreferenz ist erstmalig 1995 erschienen. Die Kommandoreferenz war damals aber nur ein 56 Seiten langes Kapitel in der ersten Auflage meines Linux-Buchs. Aufgrund von Platzproblemen musste ich das Kommandoreferenz-Kapitel 15 Jahre später aus dem Linux-Buch entfernen und in ein eigenes Buch auslagern. Die erste Auflage im Taschenbuchformat hatte noch schlanke 176 Seiten. In der gerade neu erschienen sechsten Auflage hat das Buch den dreifachen Umfang!
547 Seiten, Hard-Cover
ISBN: 978-3-367-10103-0
Preis: Euro 29,90 (in D inkl. MWSt.)
Vor 15 Jahren zweifelten der Verlag und ich, ob die Kommandoreferenz überhaupt ein sinnvolles Buch wäre. Natürlich lassen sich alle Kommandos im Internet recherchieren. Heute verrät auch ChatGPT die gerade relevanten Optionen von find oder grep.
Dessen ungeachtet geben die Verkaufszahlen eine klare Botschaft: Ja, es gibt ganz offensichtlich den Bedarf nach einer Linux-Kommandoreferenz, die das Wesentliche vom Unwesentlichen trennt, die anhand thematischer Übersichten einen Startpunkt in das riesige Universum der Linux-Kommandos bietet, die mit vielen Beispielen alltägliche »Linux-Praxis« vermittelt. Keines meiner Bücher öffne ich selbst so oft (natürlich als PDF-Datei), um irgendein Detail rasch nachzulesen!
Für die 6. Auflage habe ich das Buch einmal mehr komplett aktualisiert. Die folgenden Kommandos habe ich neu aufgenommen:
Außerdem habe ich die Beschreibung vieler Kommandos aktualisiert oder mit zusätzlichen Beispielen versehen, unter anderem bei acme.sh, chmod, convert, curl, dd, find, firewall-cmd, mail, nmcli, pip und tcpdump.
Bernd Öggl und ich haben vor einigen Monaten darüber diskutiert, welche Tools wir täglich nutzen. Das Ergebnis: Docker, Git und Claude Code. Nachdem wir zu den ersten beiden Themen bereits Bücher geschrieben haben, war es naheliegend, einen weiteren Band zu unserem neuen Lieblingswerkzeug nachzulegen. Und genau das haben wir getan! Das Buch soll noch diese Woche in die Druckerei gehen.
Eigentlich beginnt die Geschichte dieses Buchs schon 2024. Da haben wir mit Aider das erste Coding-CLI ausprobiert. Die Begeisterung hielt sich damals in Grenzen. Im Herbst 2025 hat sich das geändert: Die Sprachmodelle waren gut genug, um agentisches Programmieren ohne die Kontrolle jeder einzelnen Zeile zu ermöglichen. Anthropic ist mit Claude Code das Kunststück gelungen, schneller und agiler als die Konkurrenz zu erraten, was Programmiererinnen und Entwicklern wichtig ist, und das Ganze in eine Terminal-basierte Umgebung zu verpacken. Agentic Coding per CLI erlebt gerade seinen Durchbruch.
Heute ist für uns ein Arbeiten ohne Claude Code kaum noch vorstellbar. Wir setzen das Programm nicht nur zur Software-Entwicklung ein, sondern auch für administrative Arbeiten, die Lösung von Setup-Problemen, die Suche nach Sicherheitslücken usw.
Das Buch ist kein Handbuch, das alle Optionen und Slash-Kommandos der Reihe nach abarbeitet. Stattdessen verbinden wir die Grundlagen mit vielen praktischen Beispielen aus größeren und kleineren Software-Projekten, die aus unserem beruflichen Alltag stammen. Wir versprechen Ihnen nicht das Blaue vom Himmel: Wir zeigen auch, wo Claude Code danebenliegt, und leiten daraus Arbeitsweisen ab, die sich bei uns bewährt haben.
Natürlich behandeln wir wichtigen Funktionen: Permissions, CLAUDE.md, Skills, Hooks, Plugins, MCP-Server, Subagenten und Worktrees. Ein eigenes Kapitel zeigt, was Claude Code als IT-Agent jenseits des Programmierens leisten kann. Auf KI-Grundlagen verzichten wir dagegen bewusst. Das Buch konzentriert sich fast vollständig auf die Nutzung von Claude Code im Terminal.
Gemeinsam mit Rainer Hattenhauer arbeite ich gerade an Agentic AI – Wie Sie die KI für sich arbeiten lassen. Das Buch erscheint voraussichtlich Ende Oktober im Rheinwerk Verlag. Es geht nicht mehr um Chatbots, sondern um KI-Agenten, die selbstständig planen, Werkzeuge nutzen und mehrstufige Aufgaben ausführen – von der Tagesplanung über die E-Mail-Kommunikation bis zu Workflows mit Skills, MCP, lokalen Modellen und der Steuerung von Smart-Home-Systemen.
Das Buch richtet sich explizit nicht an Leute, die mit KI-Unterstützung programmieren möchten. Dieses Thema habe ich mit Bernd Öggl und Sebastian Springer schon in Coding mit KI abgehandelt.
Ein paar persönliche Anmerkungen: Der reine Chat mit einer KI – Frage stellen, Antwort bekommen – gehört für mich schon fast der Vergangenheit an. Natürlich verwende ich Chatbots weiterhin zur Recherche. Aber auf dem Rechner installierte KI-Agenten (sprich: die ChatGPT-App, die Claude-App, aber auch Claude Code, oder unter Linux das Programm Hermes) können viel mehr: Ich erstelle damit komplexe Automatisierungs-Setups, die dann in einem faszinierenden Ausmaß selbstständig laufen.
Ich frage also nicht mehr »Wie geht das?«, sondern ich fordere den KI-Agenten auf: »Mach das!« Ganz von alleine geht das natürlich nicht. Ein wenig Arbeit für das Setup, das Einrichten von CLAUDE.md oder AGENTS.md, manchmal die Installation eines Plugins oder MCP-Servers — das gehört dazu. Und das lohnt sich meist nur, wenn es um Aufgaben geht, die sich wiederholen.
Mein Aha-Erlebnis war die Korrektur einer Linux-Prüfung, die ich vor einem Monat (fast) vollständig auf KI umgestellt habe (siehe den entsprechenden Blog-Artikel). Nein, die Korrektur erfolgt NICHT zur Gänze KI-gesteuert, ich muss zum Schluss noch einmal darüberschauen. Aber Claude Code (mein Lieblings-Tool für fast alles) nimmt mir jetzt unglaublich viel öde Arbeit ab. Claude Code verbindet sich via SSH mit einem Dutzend virtueller Maschinen, sieht nach, welche der Aufgabenstellungen dort erledigt sind, und trägt die Ergebnisse in eine ODS-Tabelle ein. Grandios!
Oder werfen Sie einen Blick auf https://scripting-buch.netlify.app. Spannend ist weniger der Inhalt, den können Sie auch hier auf kofler.info nachlesen. Spannend ist, dass diese Website ausschließlich aus ein paar Prompts entstanden ist. Ich habe der ChatGPT-App (ehemals Codex, jetzt ChatGPT Work) die Markdown-Dateien zum Buch gegeben, einen Link auf die Buchseite beim Rheinwerk-Verlag, und habe im Prinzip gesagt: »Mach‘ mir eine tolle Website zu diesem Buch.« Ich bin nicht leicht zu verblüffen, aber alleine das zum Scripting-Thema so gut passende Layout ist großartig! Mit meinen eher bescheidenen Layout-Fähigkeiten hätte das viel nüchterner, langweiliger ausgesehen. Beachten Sie die konzentrischen Kreisen hinter dem Cover. Die Idee stammt von Codex nach einer Analyse des Cover-Bilds, die Umsetzung sind wenige Zeilen CSS-Code. Das ist schon ziemlich genial.
Hab‘ ich Sie neugierig gemacht? Alle Details – Kapitelübersicht und Bestell-Links – finden Sie auf der Buchseite.
Eine Weile hat es so ausgesehen, als wäre »Swift 5« die letzte Auflage meiner Swift-Bücher. Um so mehr freut es mich, dass »Swift — Das umfassenden Handbuch« diese Woche rundumerneuert erschienen ist! Auch wenn der Verlag von der 5. Auflage spricht — aus meiner Sicht ist das Buch praktisch komplett neu. Aus der vorigen Auflage habe ich eigentlich nur einige Grundlagenkapitel übernommen (und aktualisiert), die die Syntax von Swift beschreiben.
Vollkommen neu ist hingegen der Fokus auf SwiftUI. Diese Bibliothek wird längerfristig das UIKit ablösen. SwiftUI erfordert in vielerlei Hinsicht ein Neulernen der UI-Programmierung. Der Aufwand lohnt sich! UIKit funktioniert plattformübergreifend (macOS, iOS etc.), passt sich automatisch an den Dark Mode an, übernimmt die Font-Einstellungen aus den Systemeinstellungen usw. Endlich könnenSie die Oberflächen Ihrer Apps per Code gestalten und sind nicht auf den unübersichtlichen Story-Board-Editor angewiesen.
Geändert hat sich das Buch auch aus einem zweiten Grund: Als ich die vorige Auflage verfasst habe, gab es ChatGPT noch nicht. Mit KI-Assistenten ändert sich der Coding-Alltag aber grundlegend. Sie müssen die Konzepte und Grundlagen verstehen; Details wie die Reihenfolge der Optionen, die Syntax exotischer Klassen etc. können Sie hingegen getrost KI-Tools überlassen. Mit etwas Glück werden brauchbare KI-Werkzeuge demnächst auch in Xcode integriert. (Diesbezüglich hat Apple viel versprochen, aber bisher wenig geliefert.) Bis es so weit ist, liefern auch ChatGPT, Claude oder Gemini verblüffend gute Code-Vorschläge.
Kurz und gut: »Swift — Das umfassende Handbuch« vermittelt Ihnen das Fundament, um selbstständig oder mit KI-Unterstützung eigene Apps zu entwickeln. Mehr Details zum Buch können Sie hier nachlesen:
Die 2. Auflage meines Scripting-Buchs ist frisch aus der Druckerei und ab Anfang August im Buchhandel erhältlich. Wie schon die erste Auflage dreht sich alles um die drei Scripting-Sprachen Bash, PowerShell und Python. Für die Neuauflage habe ich das Buch vollständig überarbeitet und aktualisiert. Neu dazugekommen sind unter anderem:
Terminal Tuning (»Pimp my Terminal«): Nerd Fonts, Prompt Frameworks, moderne CLI-Tools
Python-Modulverwaltung mit uv
Ein neues Kapitel zum Erstellen und Zeichnen von Diagrammen
Ein neues Kapitel zum E-Mail-Versand per Script
Ein neues Kapitel zur Nutzung von KI-APIs in eigenen Scripts
Viele neue Praxisbeispiele: Claude-Code-Sessions exportieren, Web Scraping mit Playwright, GPS-Tracks aus Fotos extrahieren, WordPress-Bilder nachträglich mit Alt-Beschreibungen versehen usw.
Gerade jetzt ist Scripting-Wissen wichtiger denn je. KI-Tools wie Claude, ChatGPT oder Gemini erzeugen auf Zuruf Scripts – und führen sie oft gleich selbst aus. Das funktioniert erstaunlich gut, solange jemand am Ruder sitzt, der den resultierenden Code auch beurteilen kann: Welche Sprache eignet sich für die Aufgabe? Was macht dieses PowerShell-Cmdlet eigentlich? Ist der generierte Bash-Einzeiler sicher, oder löscht er versehentlich das falsche Verzeichnis? Ohne dieses Grundwissen bleibt nur blindes Vertrauen in den KI-Output – und das ist bei Code, der auf Servern oder Produktivsystemen läuft, keine gute Idee.
Das Buch vermittelt das Fundament, um Scripts selbst oder mit KI-Hilfe zu erstellen: Crashkurse zu den drei Sprachen, das nötige Handwerkszeug (SSH, Git, VS Code, reguläre Ausdrücke, JSON/XML-Verarbeitung) und zahlreiche Praxisbeispiele aus Backup, Bildverarbeitung, Web Scraping, Datenbank- und Cloud-Administration. Wer diese Grundlagen beherrscht, kann KI-generierte Scripts nicht nur einsetzen, sondern auch verstehen, anpassen und im Zweifel selbst debuggen.
Alle Infos zum Buch, eine Leseprobe und die Bestell-Links finden Sie auf der Buchseite.
Soeben ist die dritte Auflage meines Python-Bestsellers erschienen:
Für die 3. Auflage habe ich das Buch im Hinblick auf die Python-Version 3.12 aktualisiert. Neu hinzugekommen ist das Kapitel »Python lernen mit KI-Unterstützung«. Es zeigt, wie Ihnen ChatGPT oder ein vergleichbares KI-Tool beim Erlernen von Python helfen kann. Ebenfalls neu ist ein Abschnitt zur Nutzung von Python direkt in Excel.
Viele Beispiele aus der Praxis sowie Übungsaufgaben helfen dabei, Python ohne allzu viel Theorie kennenzulernen. Im handlichen Taschenbuchformat ist das Buch auch unterwegs ein idealer Begleiter. Mehr Details zum Buch gibt es hier:
Soeben ist die dritte Auflage unseres Photovoltaik-Buchs erschienen. Für diese Auflage haben wir das Buch an die aktuellen gesetzlichen Richtlinien und Förderungen angepasst. Gerade bei den Förderungen sieht es ja aktuell so aus, als würde die Politik einen Schritt zurück machen. In Österreich läuft die Umstatzsteuerbefreiung für private PV-Anlangen und -Komponenten ironischerweise genau heute aus. Schade!
Ganz frisch zu Java 25 erscheint diese Woche die fünfte Auflage meines Java-Grundkurses. Das Buch richtet sich an Schüler, Studentinnen und alle, die gerade Java lernen oder von einer anderen Programmiersprache auf Java umsteigen möchten. Im handlichen Taschenbuchformat fasst das Buch die Syntax von Java in seiner aktuellen Form zusammen. Das Buch berücksichtigt dabei die vielen in Java 25 endlich verfügbaren Vereinfachungen, die gerade Einsteigern sehr entgegenkommen.
100 Beispiele und Übungen (inkl. Lösungen!) führen von der Theorie in die Praxis. Alle Beispieldateien liegen in zwei Versionen vor, einmal aktuell zu Java 25 und einmal für ältere Java-Installationen, wie sie gerade im Schulbetrieb leider üblich sind.
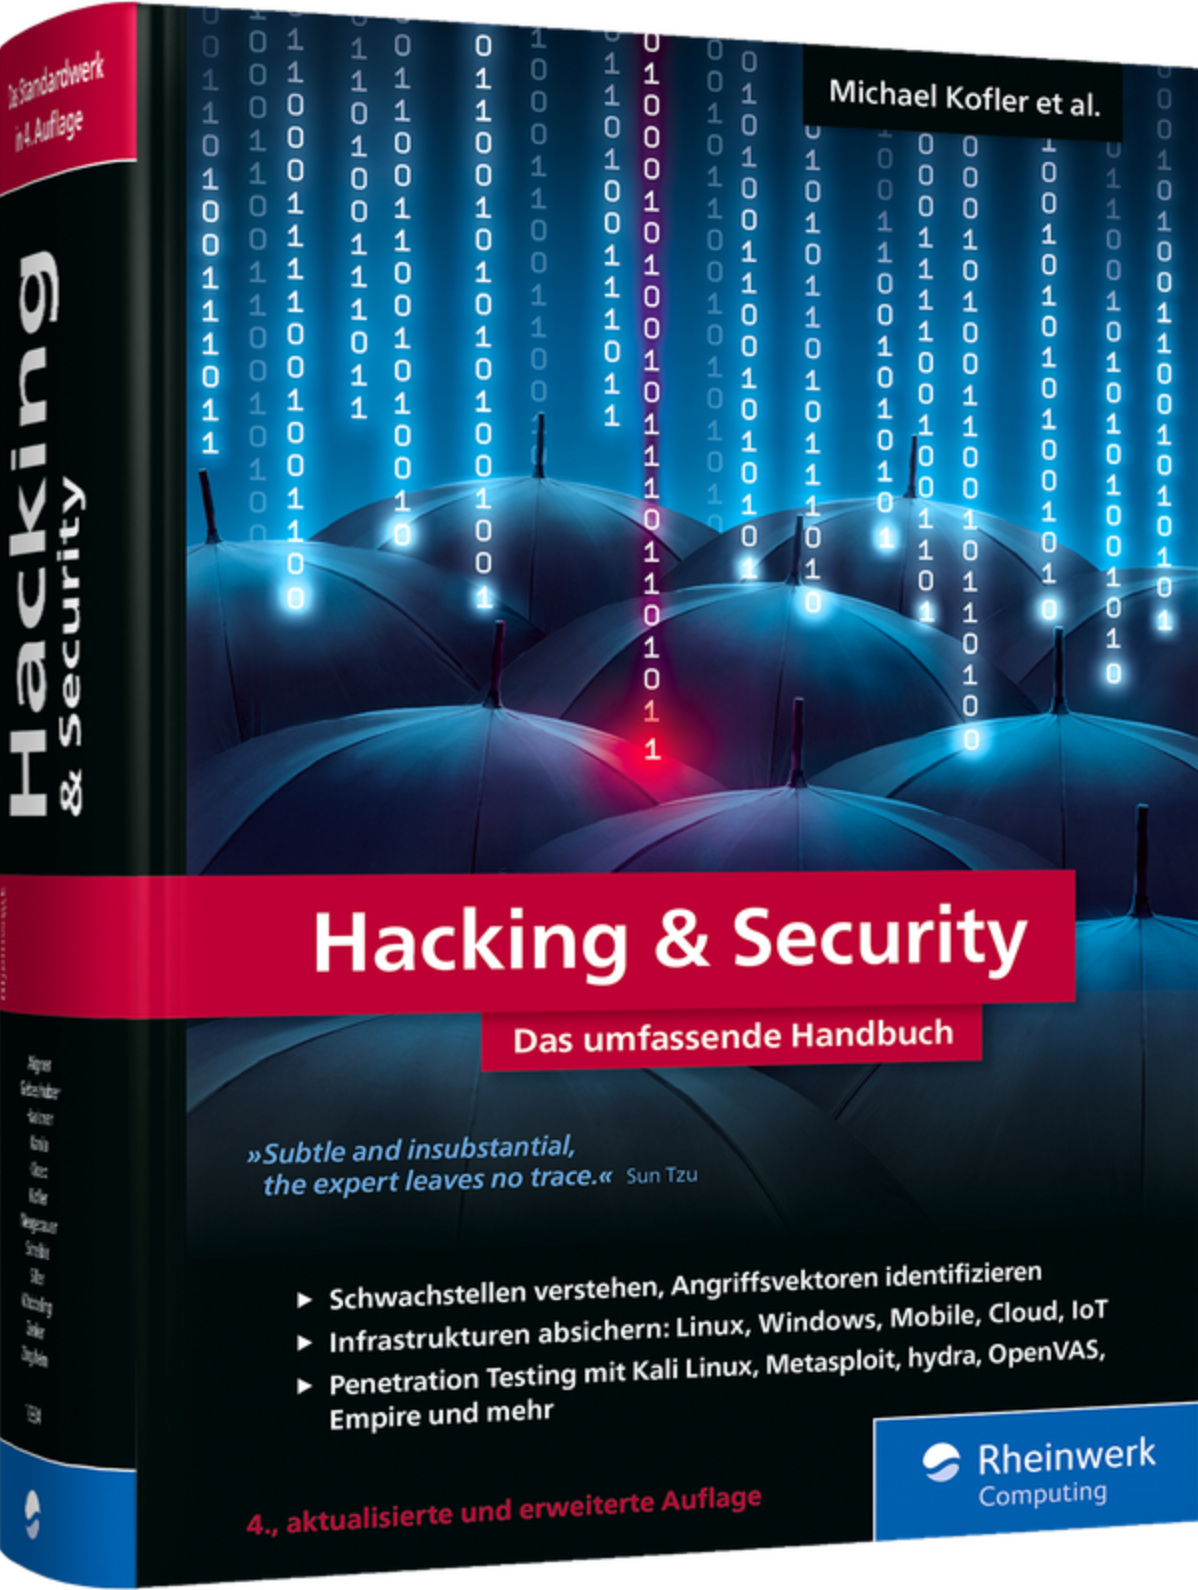
Es ist schon eine logistische Herausforderung, wenn ein Buch mit nunmehr zwölf Autoren auf den neuesten Stand gebracht werden soll! Das hat uns natürlich nicht abhalten können. Diese Woche wird die vierte Auflage unseres Standardwerks mit fast 1300 Seiten an die Buchhandlungen ausgeliefert. Ich glaube, wir dürfen ein wenig stolz sein :-)
Die Inhalte sind auf dem neuesten Stand, aber das Konzept ist gleich geblieben: Wir wollen in diesem Buch zeigen, wie und mit welchen Tools Hacker und Pen-Tester arbeiten. Und Ihnen in logischer Konsequenz erklären, wie Sie sich gegen Angriffe bestmöglich schützen können. Ganz bewusst lassen wir es nicht beim klassischen Netzwerk-Hacking bewenden, sondern gehen auch auf Einfallsvektoren wie Cloud, IoT, Mobile Devices usw. ein.
Für die hier vierte Auflage haben wir das Buch umfassend aktualisiert und um viele neue Inhalte erweitert. Besonders erwähnen möchten wir:
Hacking lernen (neues Kapitel mit Fokus auf den Hacking-Einstieg)
Absicherung von Samba (Kapitel grundlegend überarbeitet und erneuert)
Absicherung von Microsoft 365 (neues Kapitel)
Absicherung von KI-Anwendungen (neues Kapitel)
Absicherung von Docker, Geoblocking mit Firewalls (nft)
SIEM-Systeme (Wazuh, Microsoft Senitel)
Die wohl größte Neuerung im Vergleich zur vorigen Auflage besteht darin, dass KI-Tools 2022 noch exotisch waren, heute aber allgegenwärtig sind. KI-Tools werden sowohl von Hackern (Angriff) als auch zur Verbesserung der Sicherheit (Verteidigung) genutzt. Viele Kapitel enthalten Tipps und Hinweise zur Anwendung von KI-Werkzeugen.
Die dritte Auflage unseres Git-Buchs wird gerade an die Buchhandlungen ausgeliefert. In dem Buch beschreiben Bernd Öggl und ich, wie git funktioniert und wie das Kommando in der Praxis angewendet wird. Natürlich beschränken wir uns nicht auf git an sich, sondern zeigen auch die Integration mit Git-Plattformen wie GitHub und Gitlab, erläutern zweckmäßige Workflows für Teams, diverse Arbeitstechniken (Hooks, Submodules, Subtrees, Etckeeper), gehen auf die Migration von SVN zu Git und beschreiben häufige Git-Probleme und ihre Lösung.
Das Docker-Buch, das ich zusammen mit Bernd Öggl 2018 konzipiert und verfasst habe, hat sich zu einem kleinen Bestseller entwickelt. Die 5. Auflage wird gerade in die Buchhandlungen ausgeliefert.
Für diese Auflage haben wir das Buch vollständig aktualisiert und alle Beispiele auf den neuesten Stand gebracht. compose.yaml hat in diesem Buch schon immer eine große Rolle gespielt, aber diese Auflage enthält diesbezüglich noch mehr Grundlagen und Beispiele. Schließlich haben wir das Buch um einige neue Kapitel bzw. Abschnitte erweitert:
KI-Funktionen mit Docker: Sprachmodelle mit dem Docker Model Runner (DMR) ausführen, MCP mit dem Docker-MCP-Katalog nutzen
Prometheus Monitoring Server mit Docker Compose aufsetzen
Netzwerk- und Firewall-Interna in Docker und Podman
Windows-Testinstallationen im Grafikmodus mit Dockur ausführen
Toolbx: Software-Umgebungen ohne Container-Isolierung ausführen
Es kommt selten vor, dass ein IT-Buch innerhalb von 18 Monaten eine zweite Auflage erfährt und dabei in großen Teilen neu geschrieben werden muss. Genau das ist uns mit diesem Buch passiert! Wir haben die Gelegenheit genutzt und das Buch komplett aktualisiert und stark erweitert. Der Fokus liegt jetzt bei Agentic Coding, MCP und Skills.
Wir haben in diesem Buch den »State of the Art« im Bereich KI und Agentic Coding abgesteckt. In unzähligen Tests haben wir ausprobiert, wie weit die Versprechen der KI-Hersteller zutreffen, aber auch, wo heutige KI-Tools versagen. Wir haben lokale Modelle und Open-Source-Tools ebenso verwendet wie kommerzielle KI-Tools von Claude, Cursor, Google und OpenAI. Ein eigenes Kapitel behandelt den neuen Trend der CLI-basierten KI-Tools, also z.B. Claude Code oder OpenAI Codex.
Ein halbes Jahr lang haben wir zu dritt intensiv getestet:
Was ist möglich?
Was ist sinnvoll?
Welche Anwendungsfälle gibt es, die über das reine Erstellen von Code hinausgehen?
Wo liegen die Grenzen?
Was sind die Risken?
Ist der KI-Einsatz ethisch vertretbar?
Wir haben mit ChatGPT und Claude gearbeitet und deren Ergebnisse mit lokalen Sprachmodellen (via Ollama, GPT4All, Continue, Tabby) verglichen. Wir haben Llama, Mistral/Mixtral, CodeLlama, Starcoder, Gemma und andere »freie« Sprachmodelle ausprobiert. Wir haben nicht nur Pair Programming getestet, sondern haben die KI-Werkzeuge auch zum Debugging, Refactoring, Erstellen von Unit-Tests, Design von Datenbanken, Scripting sowie zur Administration eingesetzt. Dabei haben wir mit verschiedenen Prompt-Formulierungen experimentiert und geben dazu eine Menge Tipps.
Der nächste Schritt beim Coding mit KI sind semi-selbstständige Level-3-Tools. Also haben wir uns OpenHands und Aider angesehen und waren von letzterem ziemlich angetan. Wir haben die Grenzen aktueller Sprachmodelle mit Retrieval Augmented Generation (RAG) und Text-to-SQL verschoben. Wir haben Scripts entwickelt, die mit KI-APIs kommunizieren und automatisiert dutzende oder auch hunderte von Code-Dateien verarbeiten.
Kurz und gut: Wir haben uns das Thema »Coding mit KI« so gesamtheitlich wie möglich angesehen und teilen mit Ihnen unsere Erfahrungen. Die Quintessenz ist vielleicht ein wenig banal: Es kommt darauf an. In vielen Fällen haben wir sehr gute Ergebnisse erzielt. Oft sind wir aber auch an die Grenzen gestoßen — umso eher, je spezieller die Probleme, je exotischer die Programmiersprachen und je neuer die genutzten Sprach-Features/Frameworks/Bibliotheken sind.
Was bleibt, ist die Überzeugung, dass an KI-Tools in der Software-Entwicklung kein Weg vorbei geht. Wer KI-Tools richtig einsetzt, spart Zeit, kürzer lässt es sich nicht zusammenfassen. Aber wer sie falsch einsetzt, agiert unverantwortlich und produziert fehlerhaften und unwartbaren Code!
Mehr Details zum (Vorwort, Leseprobe) finden Sie hier.
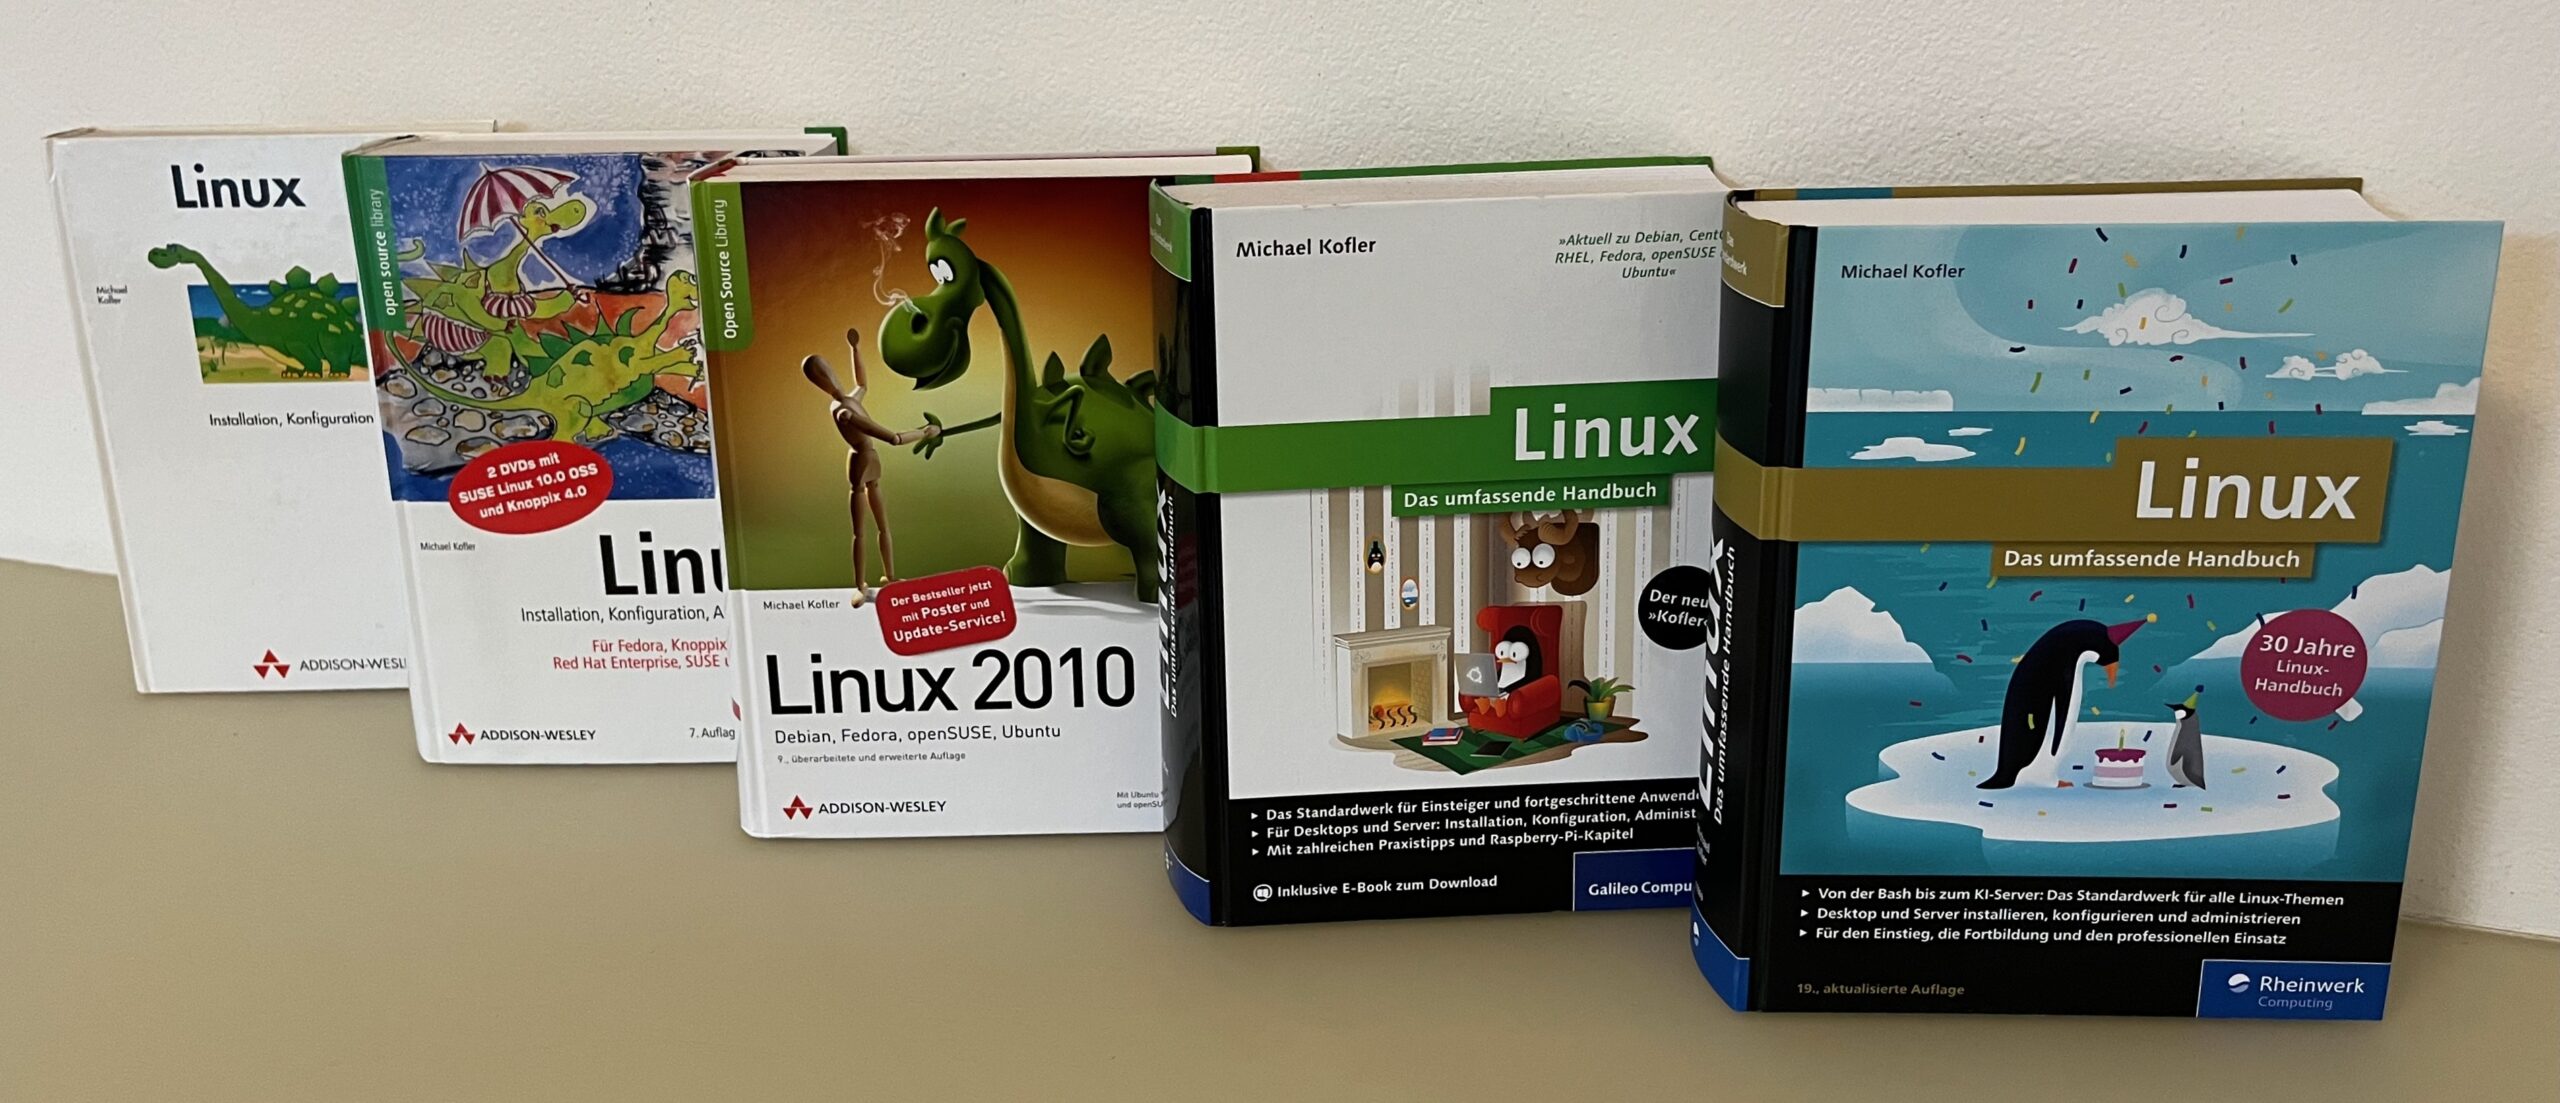
Ende November erscheint die 19. Auflage meines Linux-Buchs und markiert damit ein denkwürdiges Jubiläum: Das Buch ist jetzt 30 Jahre alt!
Das Linux-Buch: 1995, 2004, 2010, 2014, 2025
Gleichzeitig ist das Buch so modern wie nie zuvor. Bei der Überarbeitung habe ich das Buch an vielen Stellen gestrafft und von Altlasten befreit. Das hat Platz für neue Inhalte gemacht, z.B. rund um die folgenden Themen:
Die Shell fish (neues Kapitel)
Swap on ZRAM
Geoblocking mit nft (neuer Abschnitt)
Samba im Zusammenspiel mit Windows 11 24H2
Monitoring mit Prometheus und Grafana (neues Kapitel, Docker-Setup mit Traefik)
KI-Sprachmodelle ausführen (neues Kapitel)
Berücksichtigung von CachyOS
Umfang: 1429 Seiten
ISBN: 978-3-367-11069-8
Preis: Euro 49,90 (in D inkl. MWSt.)
Sowohl Linux als auch mein Buch haben sich in den vergangenen 30 Jahren natürlich dramatisch verändert. Die folgenden Absätze stammen aus dem Vorwort. Das gesamte Vorwort befindet sich in der Leseprobe (PDF) zum Buch.
Als ich an der ersten Auflage dieses Buchs schrieb, hatten die meisten Privatanwenderinnen und -anwender noch gar keinen Internetzugang, und wenn doch, dann über ein unzuverlässiges Modem. Das World Wide Web war gerade im Entstehen. In der ersten Auflage des Buchs habe ich Mosaic als Linux-tauglichen Webbrowser empfohlen. Erst in der zweiten Auflage konnte ich auf Netscape eingehen, der damals als erster »richtiger« Browser kostenlos für Linux zur Verfügung stand. (Aus Netscape wurde später Mozilla Firefox.)
Das wichtigste Medium zur Verbreitung von Linux war in den 90er-Jahren die CD. Die ersten Auflagen dieses Buchs enthielten deswegen CDs (später DVDs) mit Linux-Distributionen. Der Siegeszug des Internets veränderte den Charakter dieses Buchs: Es war nicht mehr notwendig, alle Optionen diverser Kommandos bis ins letzte Detail zu beschreiben; jetzt reicht ein Link auf eine Webseite mit vertiefenden Informationen.
In den Vordergrund des Buchs rückte die Vermittlung von Unix/Linux-Grundlagen. Ja, alles steht im Internet, aber Leserinnen und Leser schätzen den geordneten Überblick über Linux, die strukturierte Sammlung von Basiswissen so sehr, dass sich regelmäßige Neuauflagen lohnen. Die altmodische, aber werbefreie Präsentation auf Papier (oder in einem E-Book), frei von blinkenden Bannern und lästigen Werbevideos, ist ein entscheidender Vorteil.
Parallel zur Entwicklung des Internets bekam dieses Buch einen neuen inhaltlichen Fokus. Immer mehr Organisationen und Firmen betreiben selbst Linux-Server, sei es zu Hause, auf gemieteten Root-Servern oder in virtuellen Maschinen (Cloud-Instanzen). Dementsprechend erklärt dieses Buch, wie Sie selbst SSH-, Web-, Mail- und Datenbank-Server einrichten und sicher betreiben.
Ein weiterer Meilenstein der Linux-Geschichte war die Vorstellung des Raspberry Pi vor gut einem Jahrzehnt. Dieser preisgünstige Linux-basierte Mini-Computer bietet viele Anwendungen, von elektronischen Bastelprojekten bis zur Basisstation für die eigene Home Automation.
Seit 2022 zeichnet sich eine weitere IT-Zeitenwende ab: Mit ChatGPT wird der erste brauchbare KI-Chatbot frei verfügbar. Es lässt sich trefflich darüber streiten, wie »intelligent« dieses und konkurrierende Systeme sind. Fest steht, dass KI-Tools eine großartige Hilfe bei Linux-Problemen aller Art sind.
Nachdem ich mich vor zwei Jahrzehnten gefragt habe, ob das Internet IT-Bücher obsolet macht, stellt sich diese Frage jetzt wieder. Und neuerlich glaube ich, dass dies nicht der Fall sein wird. KI-Tools helfen (auch) bei der Lösung von Linux-Problemen. Dennoch brauchen Sie einiges an Grundwissen, um funktionierende Prompts zu formulieren. Und noch mehr Wissen zur Abschätzung, ob die Antworten von ChatGPT & Co. plausibel, veraltet oder frei erfunden sind. Genau dieses Wissen vermittle ich hier — seit 30 Jahren!
In der Vergangenheit gab es in Österreich eine PV-Förderung (EAG-Investitionszuschuss). Die Anträge waren kompliziert, der Fördertopf innerhalb weniger Minuten erschöpft.
Die damalige türkis-grüne Regierung hat diesen Unsinn per 1.1.2024 weitgehend abgestellt und stattdessen die Umsatzsteuer für private PV-Anlagen bis 35 kWp ausgesetzt. Damit entfielen für fast alle privaten PV-Anlagen die lästigen Förderanträge bei der OeMAG. Die erlassene USt entsprach ziemlich genau der Förderhöhe. Im Gegenzug sank der irrsinige Verwaltungsaufwand praktisch auf Null.
Mit dem Regierungswechsel kam das rasche Ende. In einer der ersten Maßnahmen wurde die ohnedies befristete USt-Aussetzung per 1.4.2025 vorzeitig beendet. Aber ein bisschen »öko« wollte die neue Regierung dann doch sein. Das alte Fördermodell wurde mit all seinen Nachteilen reaktiviert, aber mit einem (noch) bescheidenerem Budget ausgestattet. So bescheiden, dass beim letzten Förder-Call nur Anträge innerhalb der ersten 33 Sekunden angenommen wurden (derstandard.at).
Lieber ein ehrlicher Förderstopp als eine Verhöhnung des Volkes
PV-Produkte sind in den vergangenen Jahren erheblich billiger geworden. Man kann also volkswirtschaftlich argumentieren, dass eine Förderung nicht mehr notwendig ist. Von diesem Argument lasse ich mich sogar überzeugen. Ein regenerativer Umbau Österreichs genießt ja leider nicht die höchste Priorität der Regierung, um es einmal höflich zu formulieren. Insofern wäre es also vermutlich zweckmäßiger, die ohnedies bescheidenen Mittel zur Förderung regenerativer Heizungen (Wärmepumpen!) zu bündeln und den PV-Sektor ganz dem freien Markt zu überlassen.
Aber wenn man zu dieser Erkenntnis gelangt, dann sollte man auch den Mut haben, das auszusprechen. Die Pseudo-PV-Förderung, die wir heute haben, ist eine Verhöhnung des Volkes. In den Genuss einer Förderung kann aktuell nur kommen, wer erstens die Formulare für den Förderantrag praktisch auswendig kennt und alle Daten per Cut&Paste blitzschnell einfügen kann; und wer zweitens Glück hat.
Dieses System ist absurd. Es ist mit einer Lotterie zu vergleichen. Dann lieber gar keine Förderung! Das aktuelle System bereitet nur Frust und ist sogar kontraproduktiv, weil geplante PV-Anlagen verschoben werden — in der unsinnigen Hoffnung, vielleicht beim nächsten Förder-Call mehr Glück zu haben.
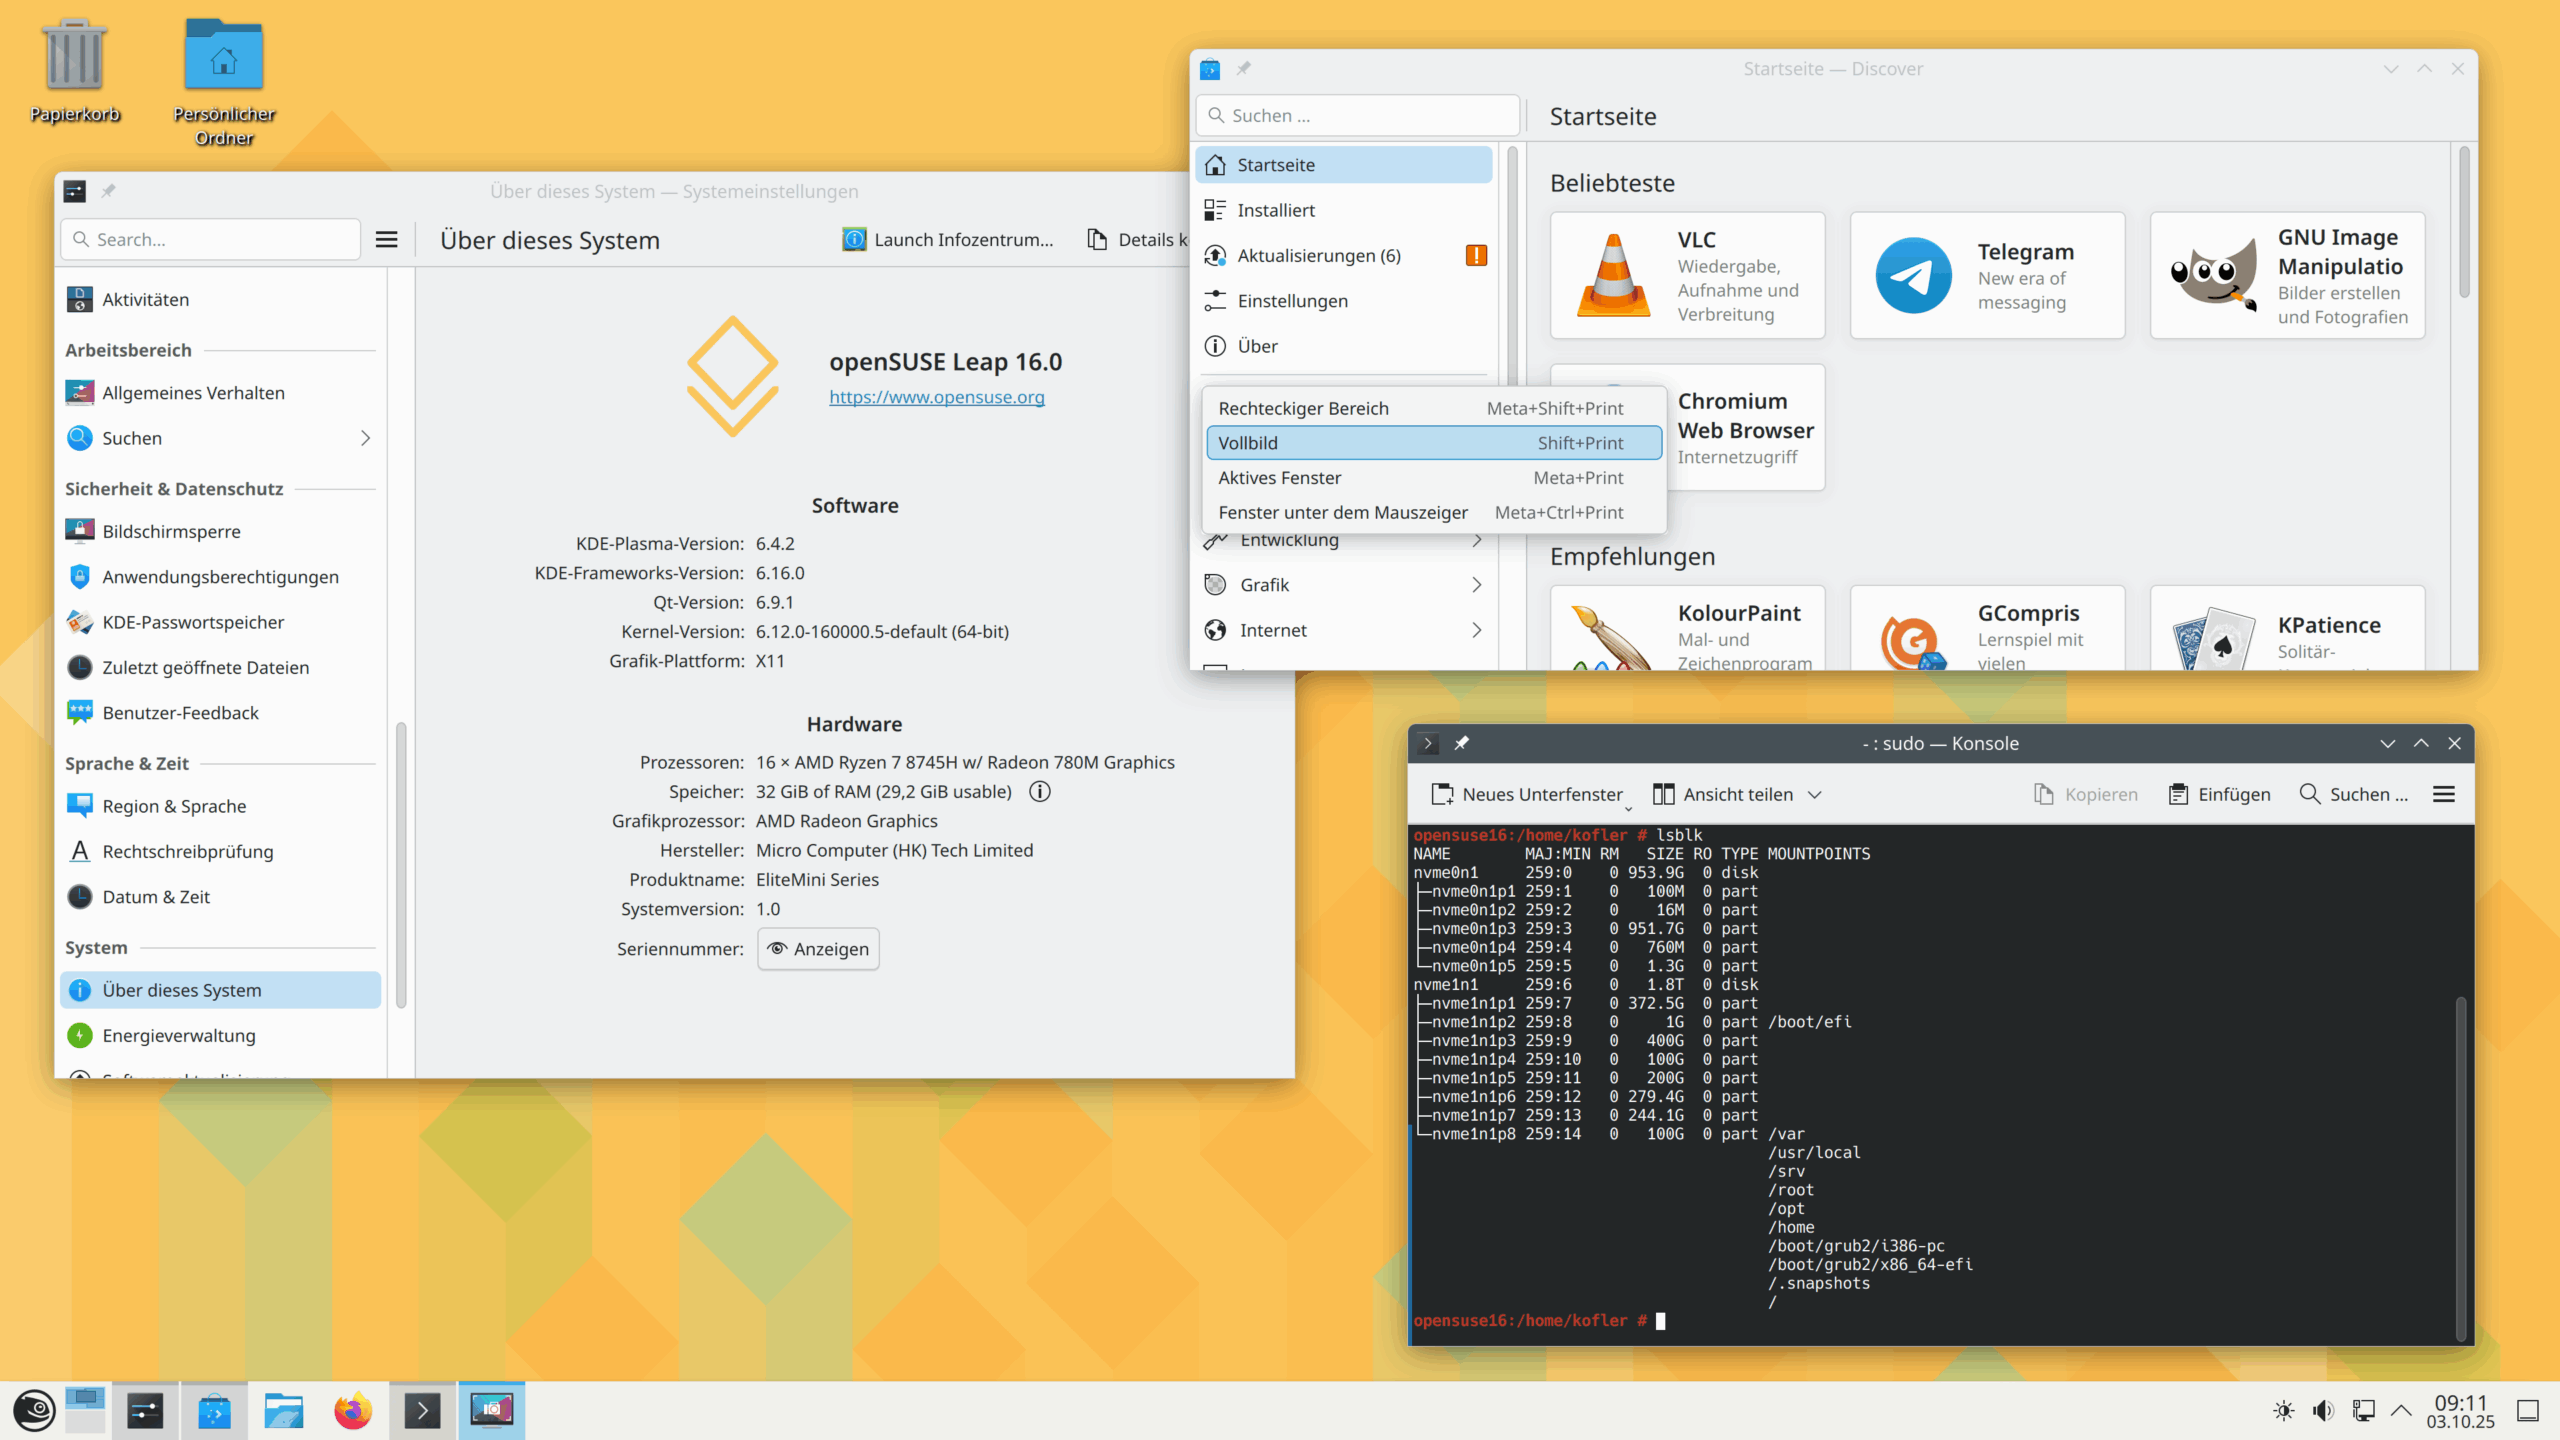
Mit Version 16 springt openSUSE gewissermaßen in ein neues Zeitalter. Eine Weile war unklar, in welcher Form und auf welcher Basis openSUSE (überhaupt) weitergeführt wird. Letztlich haben sich die Entwickler zu einem pragmatischen Ansatz entschieden: Auch mit Version 16 bleibt openSUSE Leap eine »normale« Distribution mit Paket-Updates (kein Immutable System mit atomaren Updates) — so wie der große Enterprise-Bruder SLES 16. Für diesen Artikel habe ich einen ersten Blick auf die Distribution geworfen.
openSUSE Leap 16 mit KDE Desktop
Installation
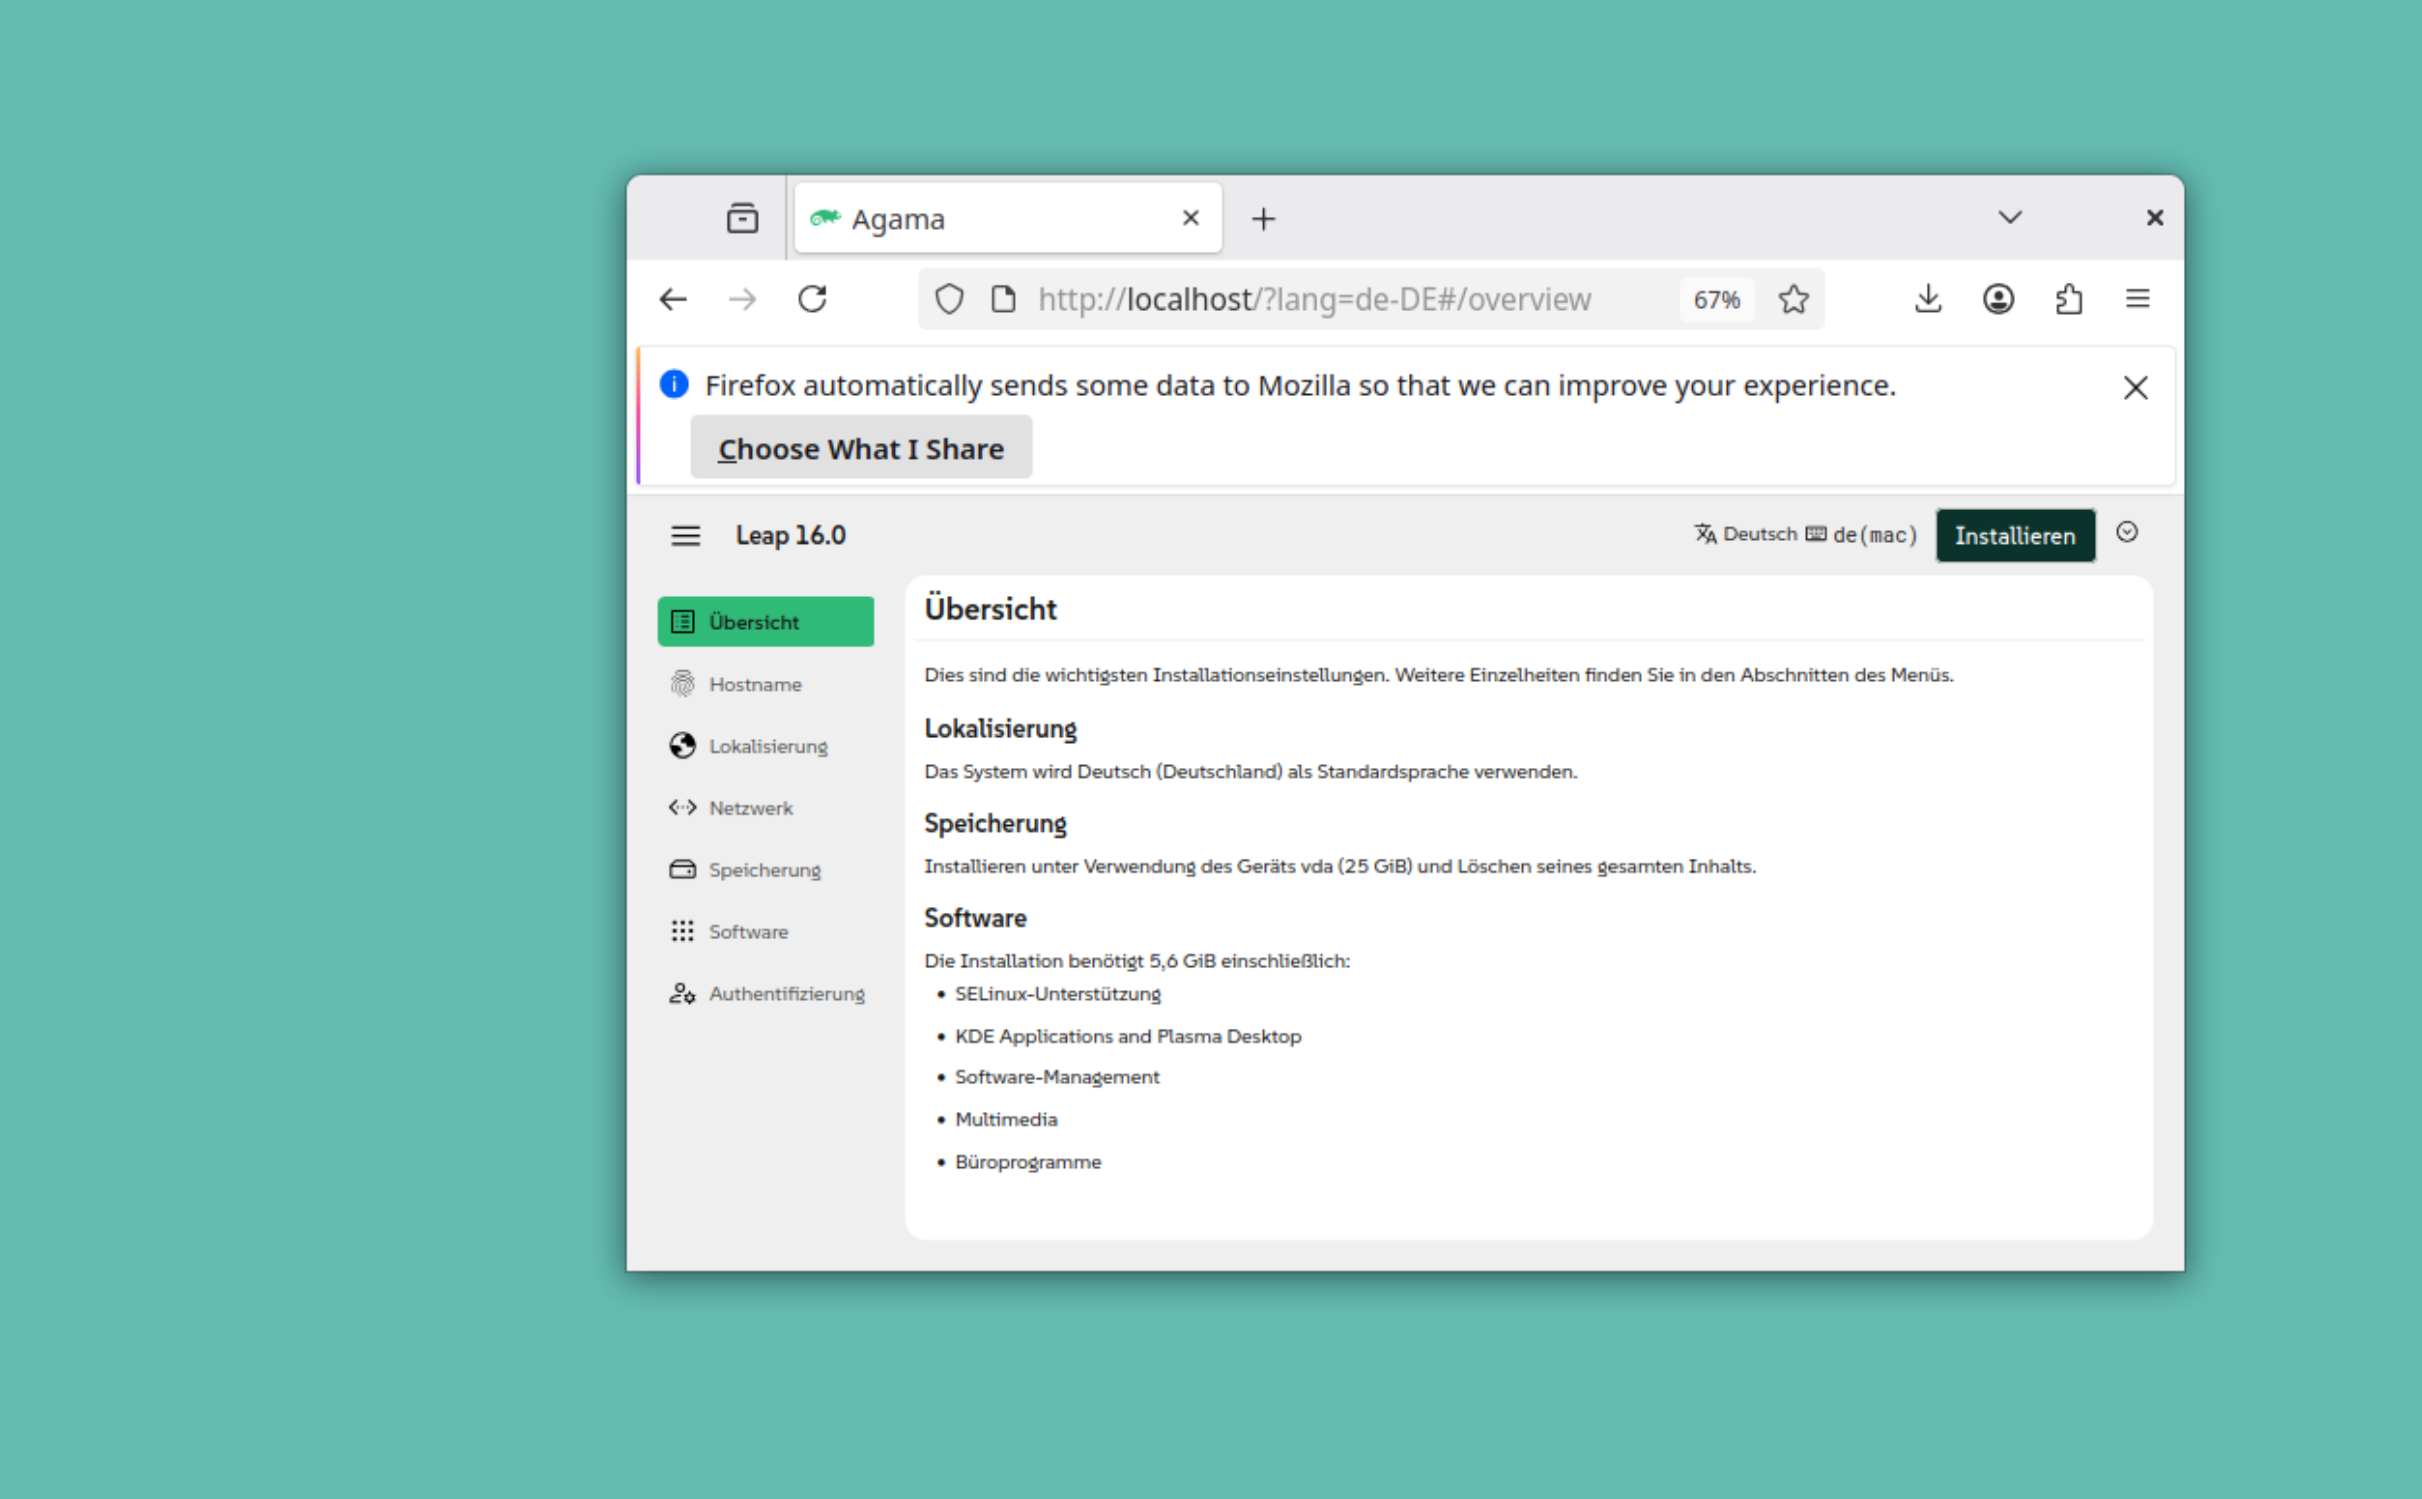
openSUSE verwendet das neue, HTML-basiertes Installationsprogramm agama, dessen Minimalismus Parallelen zu Fedora zeigt. Das Programm läuft unter Gnome im Webbrowser Firefox im Full-Screen-Modus. Es ist mir zwar gelungen, den Voll-Screen-Modus zu beenden, ich konnte aber keine anderen Programme starten, d.h. es liegt kein vollwertiges Live-System vor.
Tipp 1: Mit [Strg]+[+] bzw. [Strg]+[-] können Sie den Zoomfaktor verändern. Per Kontextmenüs können Sie Screenshots erstellen. Je nach (erkannter) Bildschirmauflösung wird das seitliche Menü nicht dauerhaft angezeigt, kann aber über den Menü-Button eingeblendet werden.
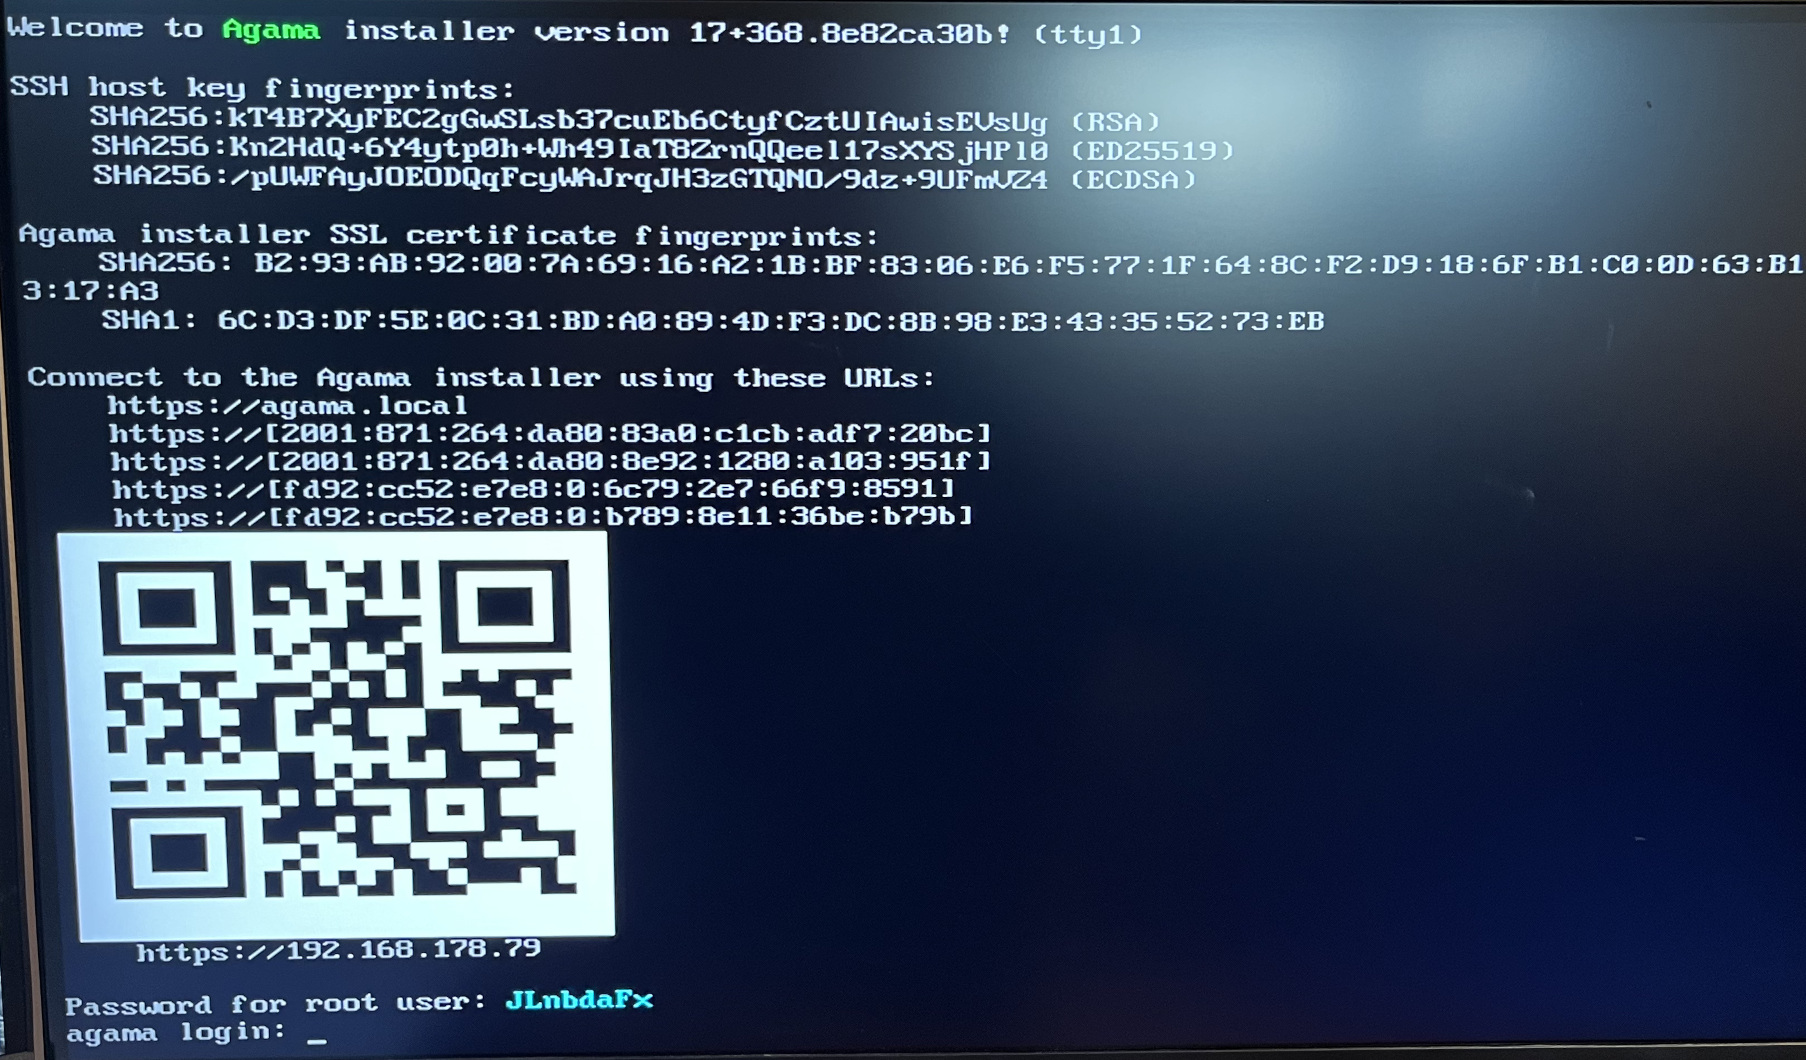
Tipp 2: Es ist möglich, das Installationsprogramm von einem externen Rechner aus zu bedienen. Dazu wechseln Sie mit Strg+Alt+F1 in eine Konsole. Dort wird die URL (https://agama.local) und das Passwort angezeigt. Jetzt können Sie im Webbrowser die URL oder IP-Adresse angeben, müssen die unsichere Verbindung (selbst signiertes Zertifikat) akzeptieren und sich einloggen. Eigentlich cool!
Die Installation läuft im Webbrowser, der aber normalerweise nicht sichtbar ist (Fullscreen-Modus)Ein Wechseln in die Textkonsole offenbart einen Login-Link zur Weboberfläche des Installers
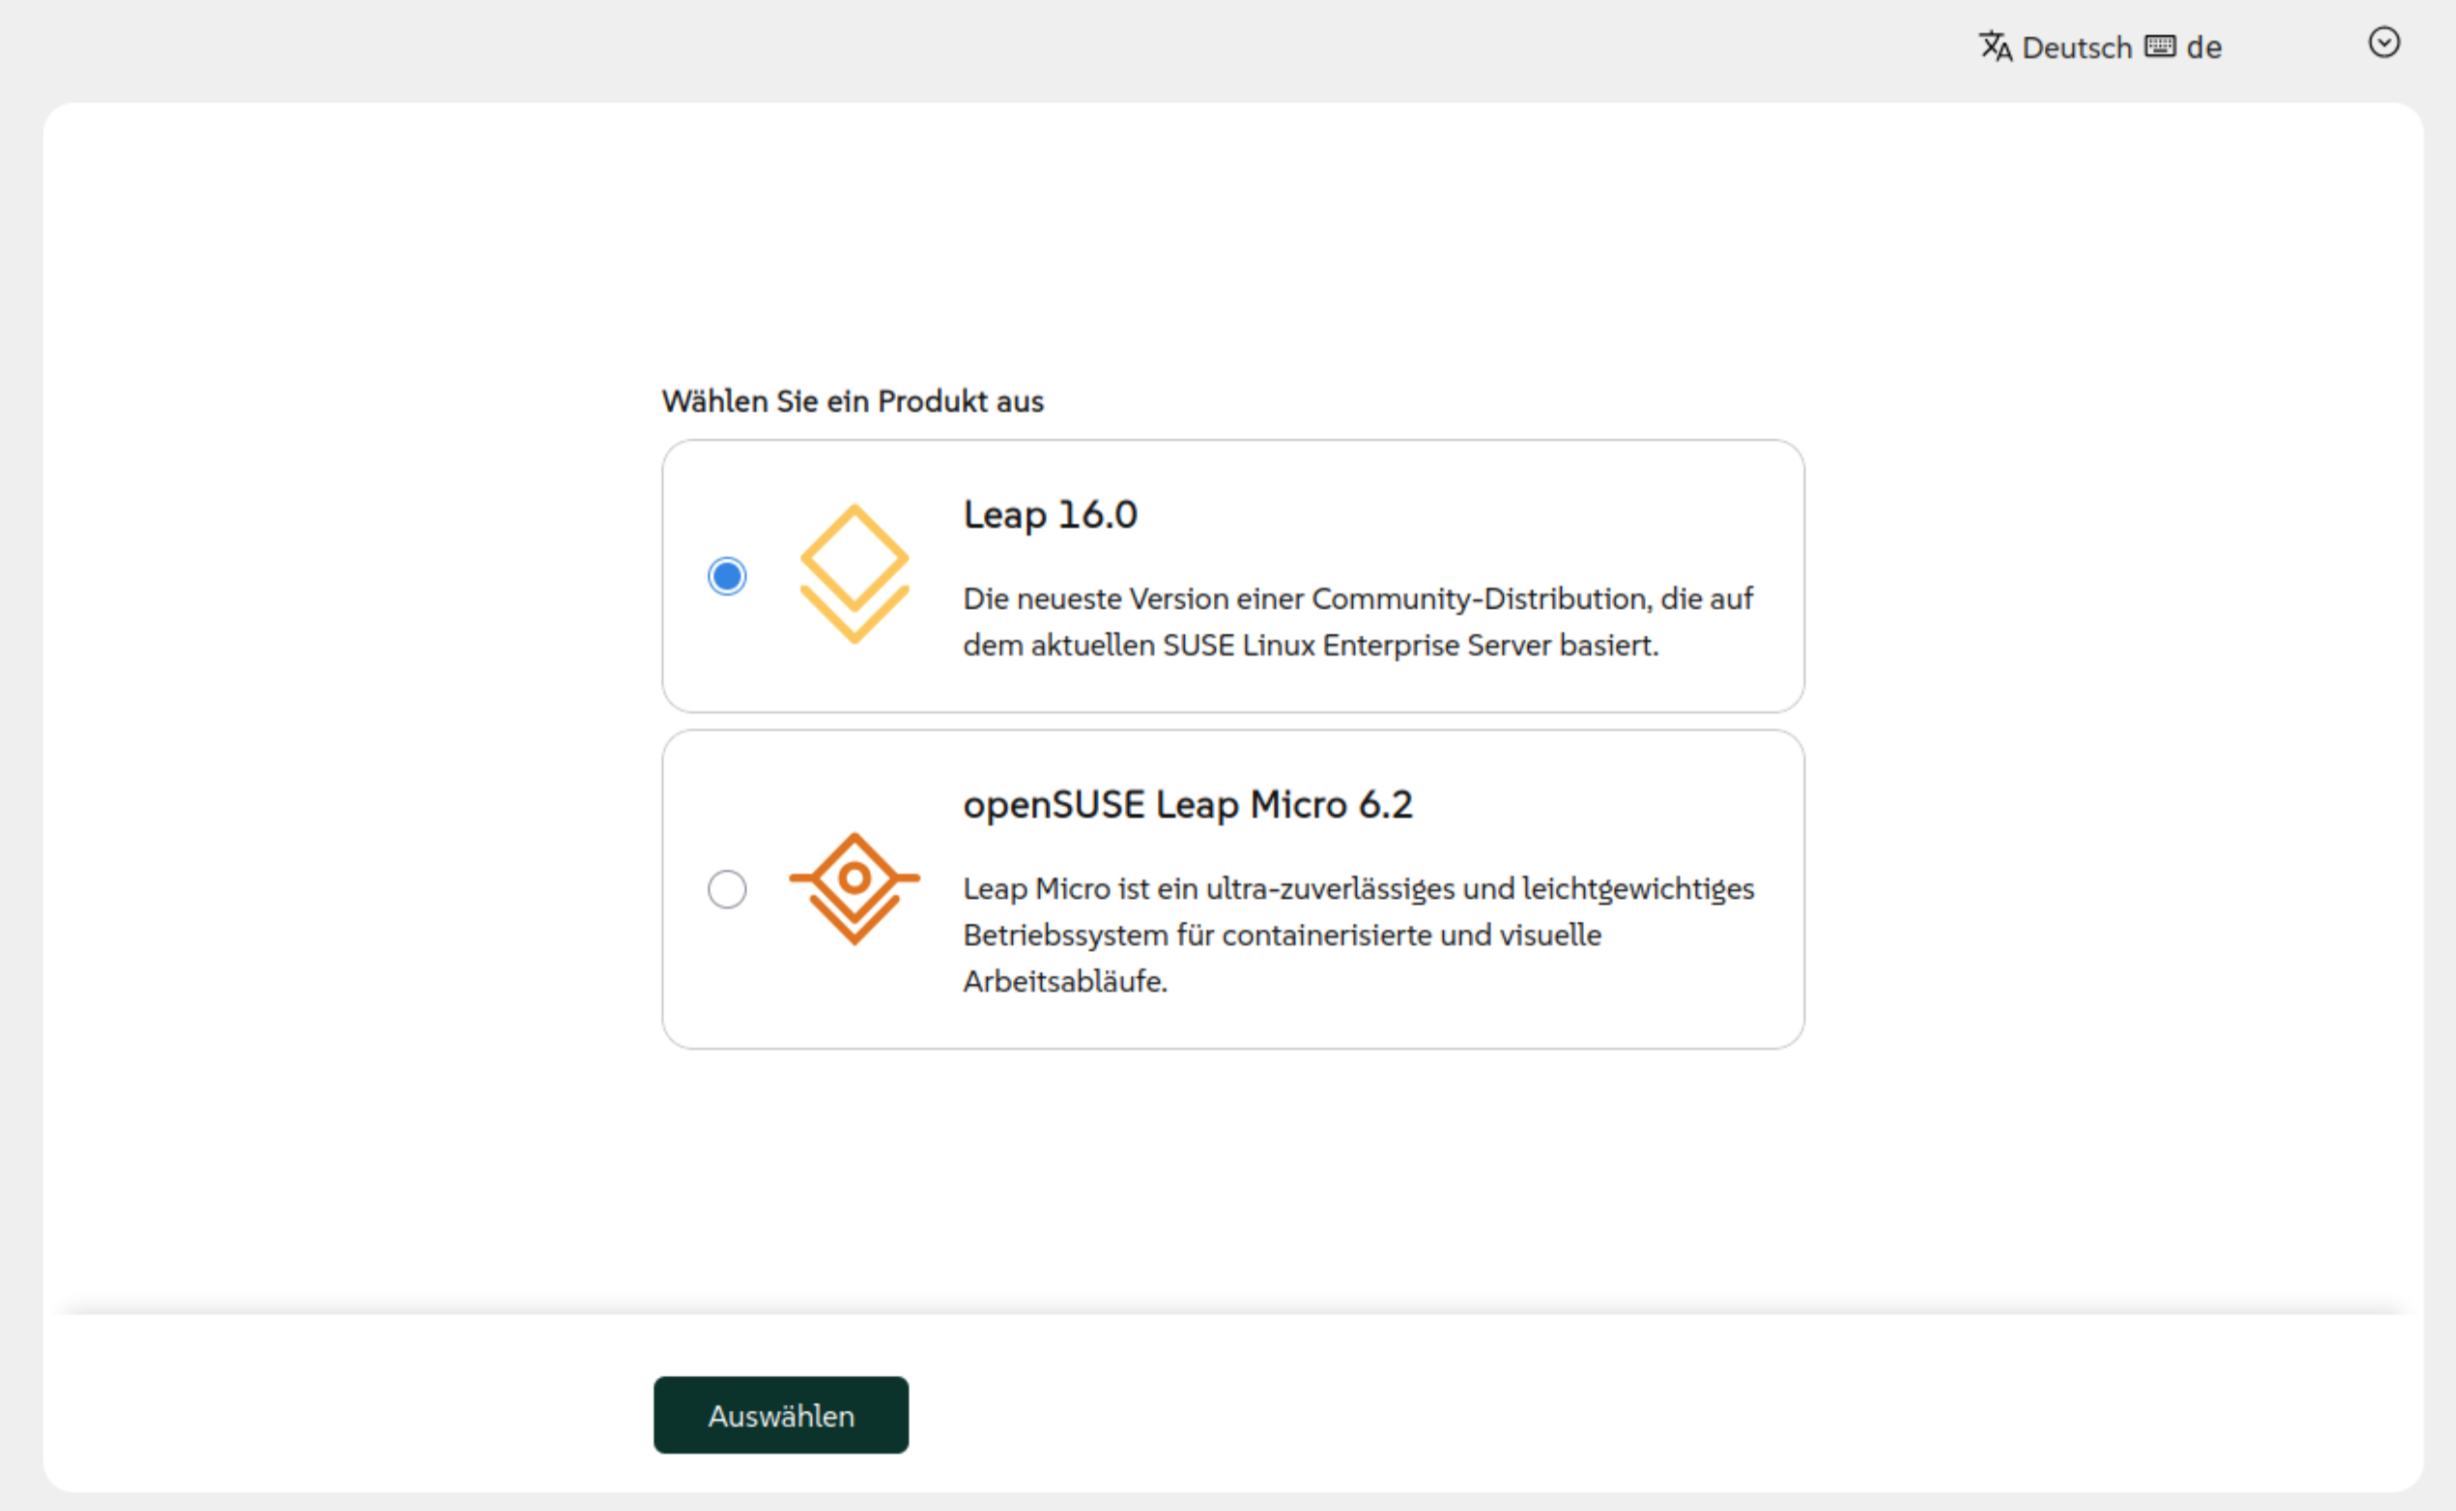
Im ersten Schritt stellen Sie rechts oben Sprache und Tastaturlayout für das Installationsprogramm ein und entscheiden Sie sich zwischen Leap 16 und Leap Micro 6.2. (Ich habe nur ersteres ausprobiert.)
Einstellung der Sprache des Setup-Programms (rechts oben) und Auswahl des Grundsystems
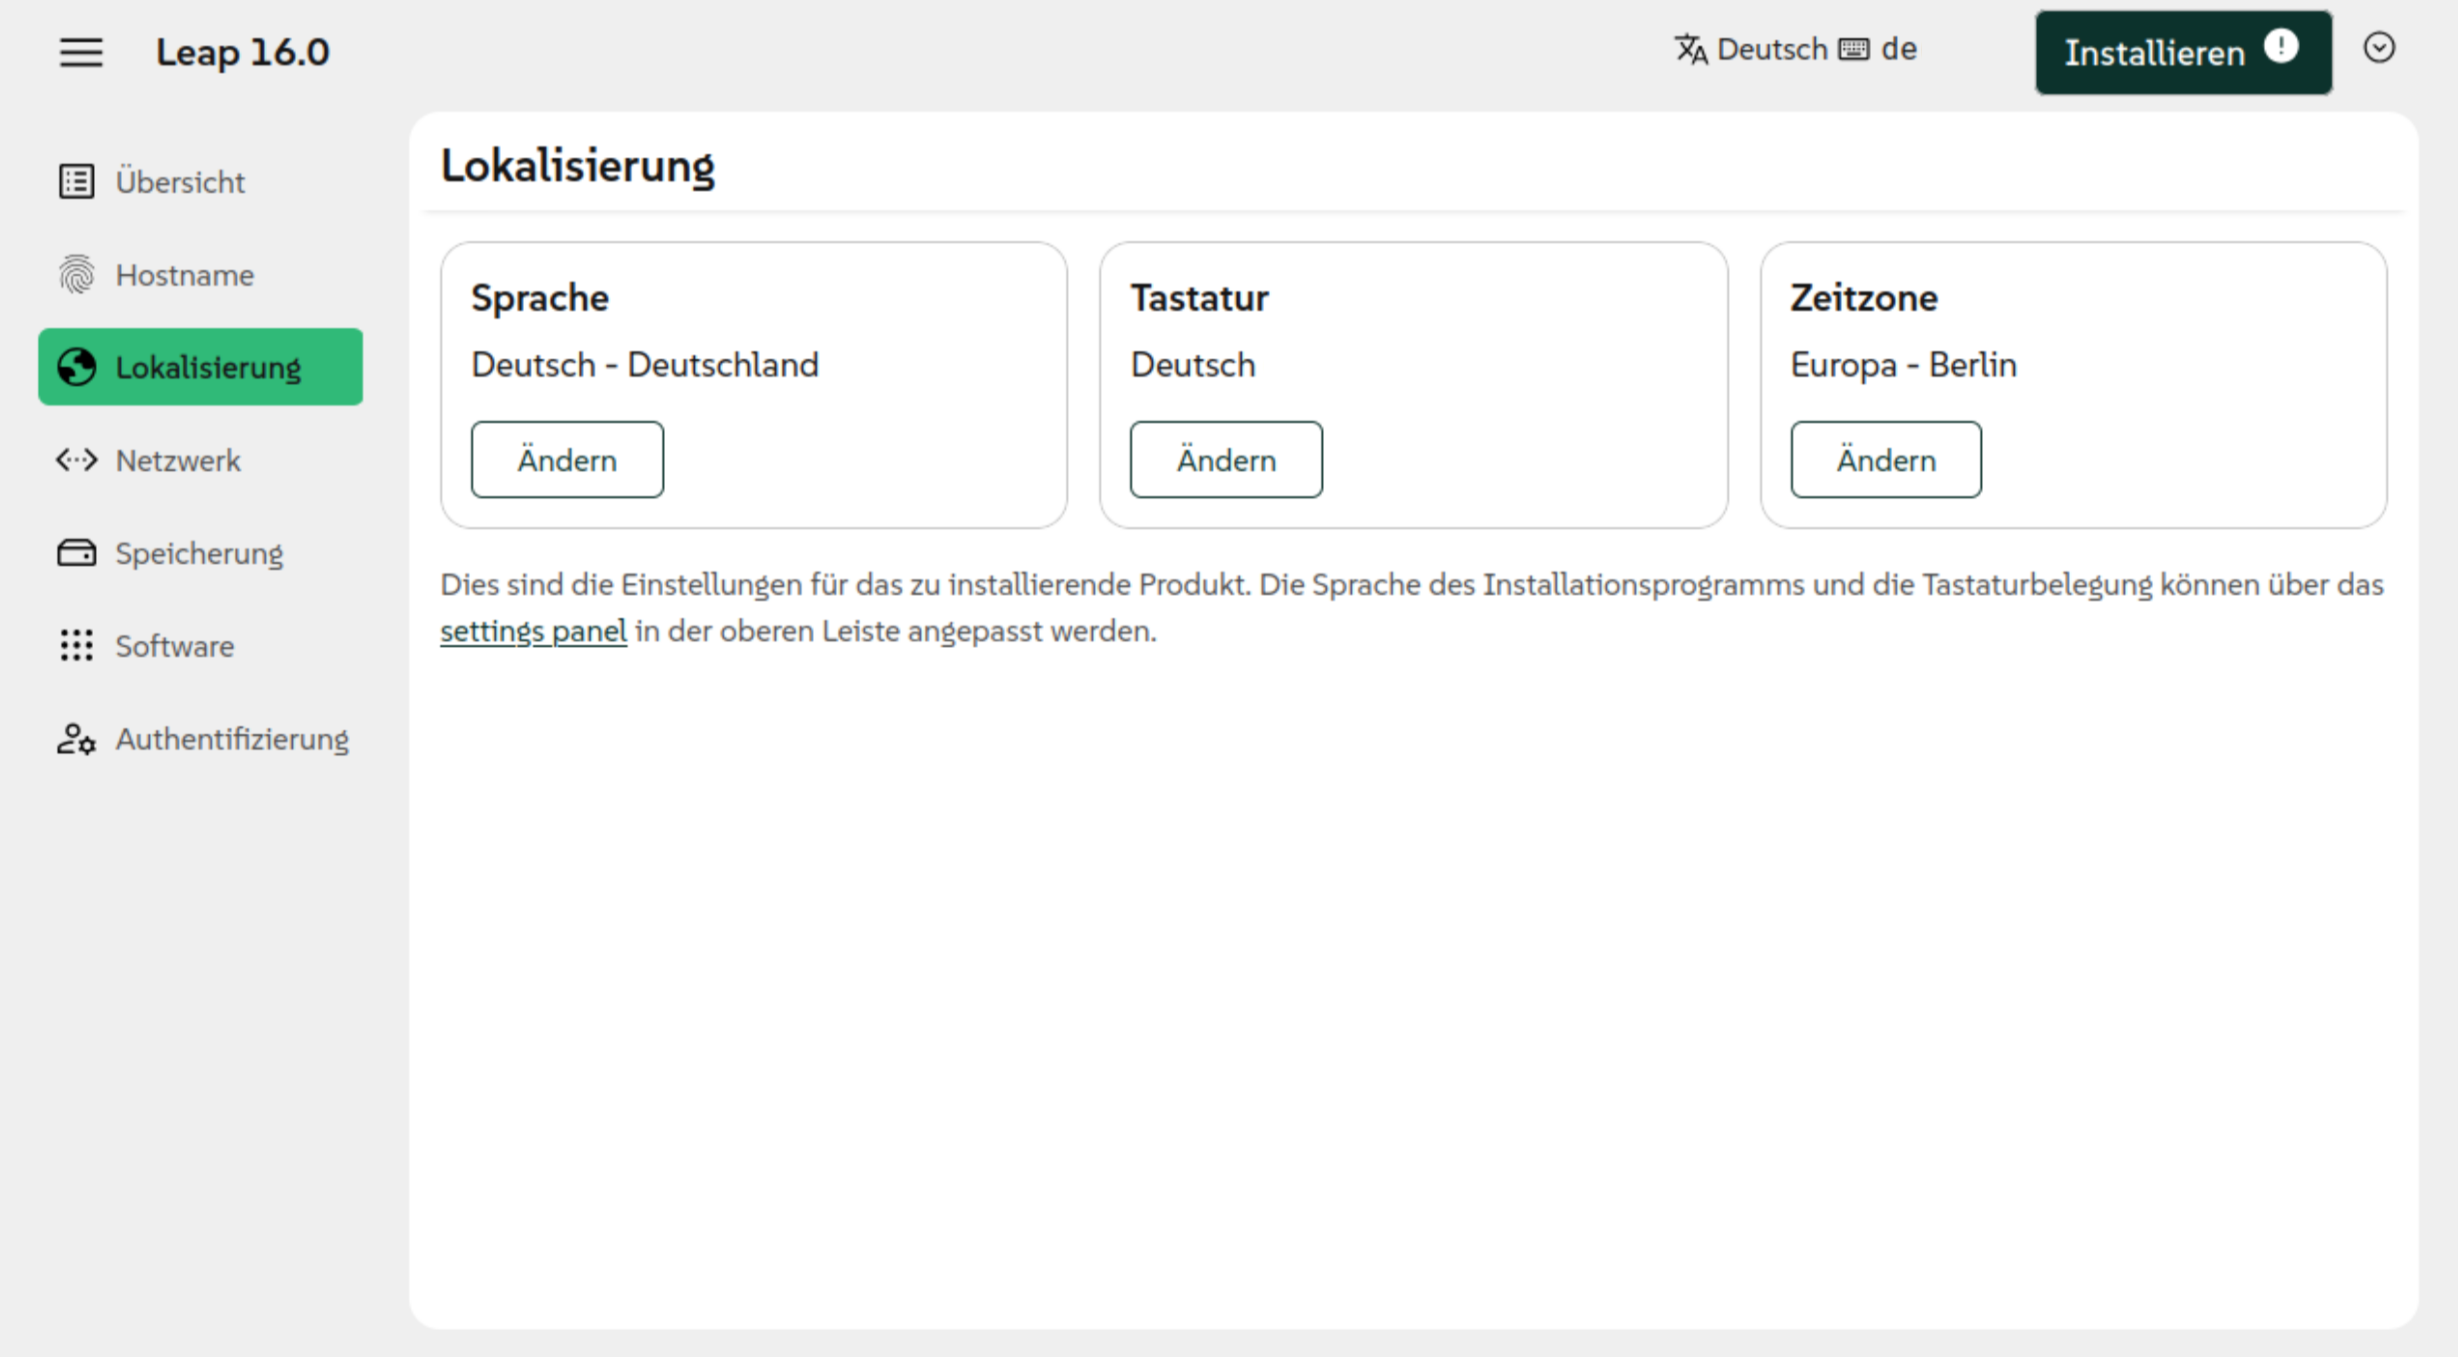
Jetzt beginnt die eigentliche Installation. Wenn Sie einen statischen Hostnamen wünschen, geben Sie den gewünschten Namen an. Unter Lokalisierung stellen Sie nochmals (!) Sprache, Tastatur und Zeitzone ein — dieses Mal für das zu installierende System. Eleganter wäre, wenn der Installer die bereits durchgeführten Einstellungen einfach übernehmen würde, aber sei’s drum.
Neuerliche Spracheinstellung, jetzt für das Zielsystem
Im Punkt Netzwerk können Sie eine WLAN-Konfiguration durchnehmen. Ethernet-Verbindungen mit DHCP werden automatisch hergestellt.
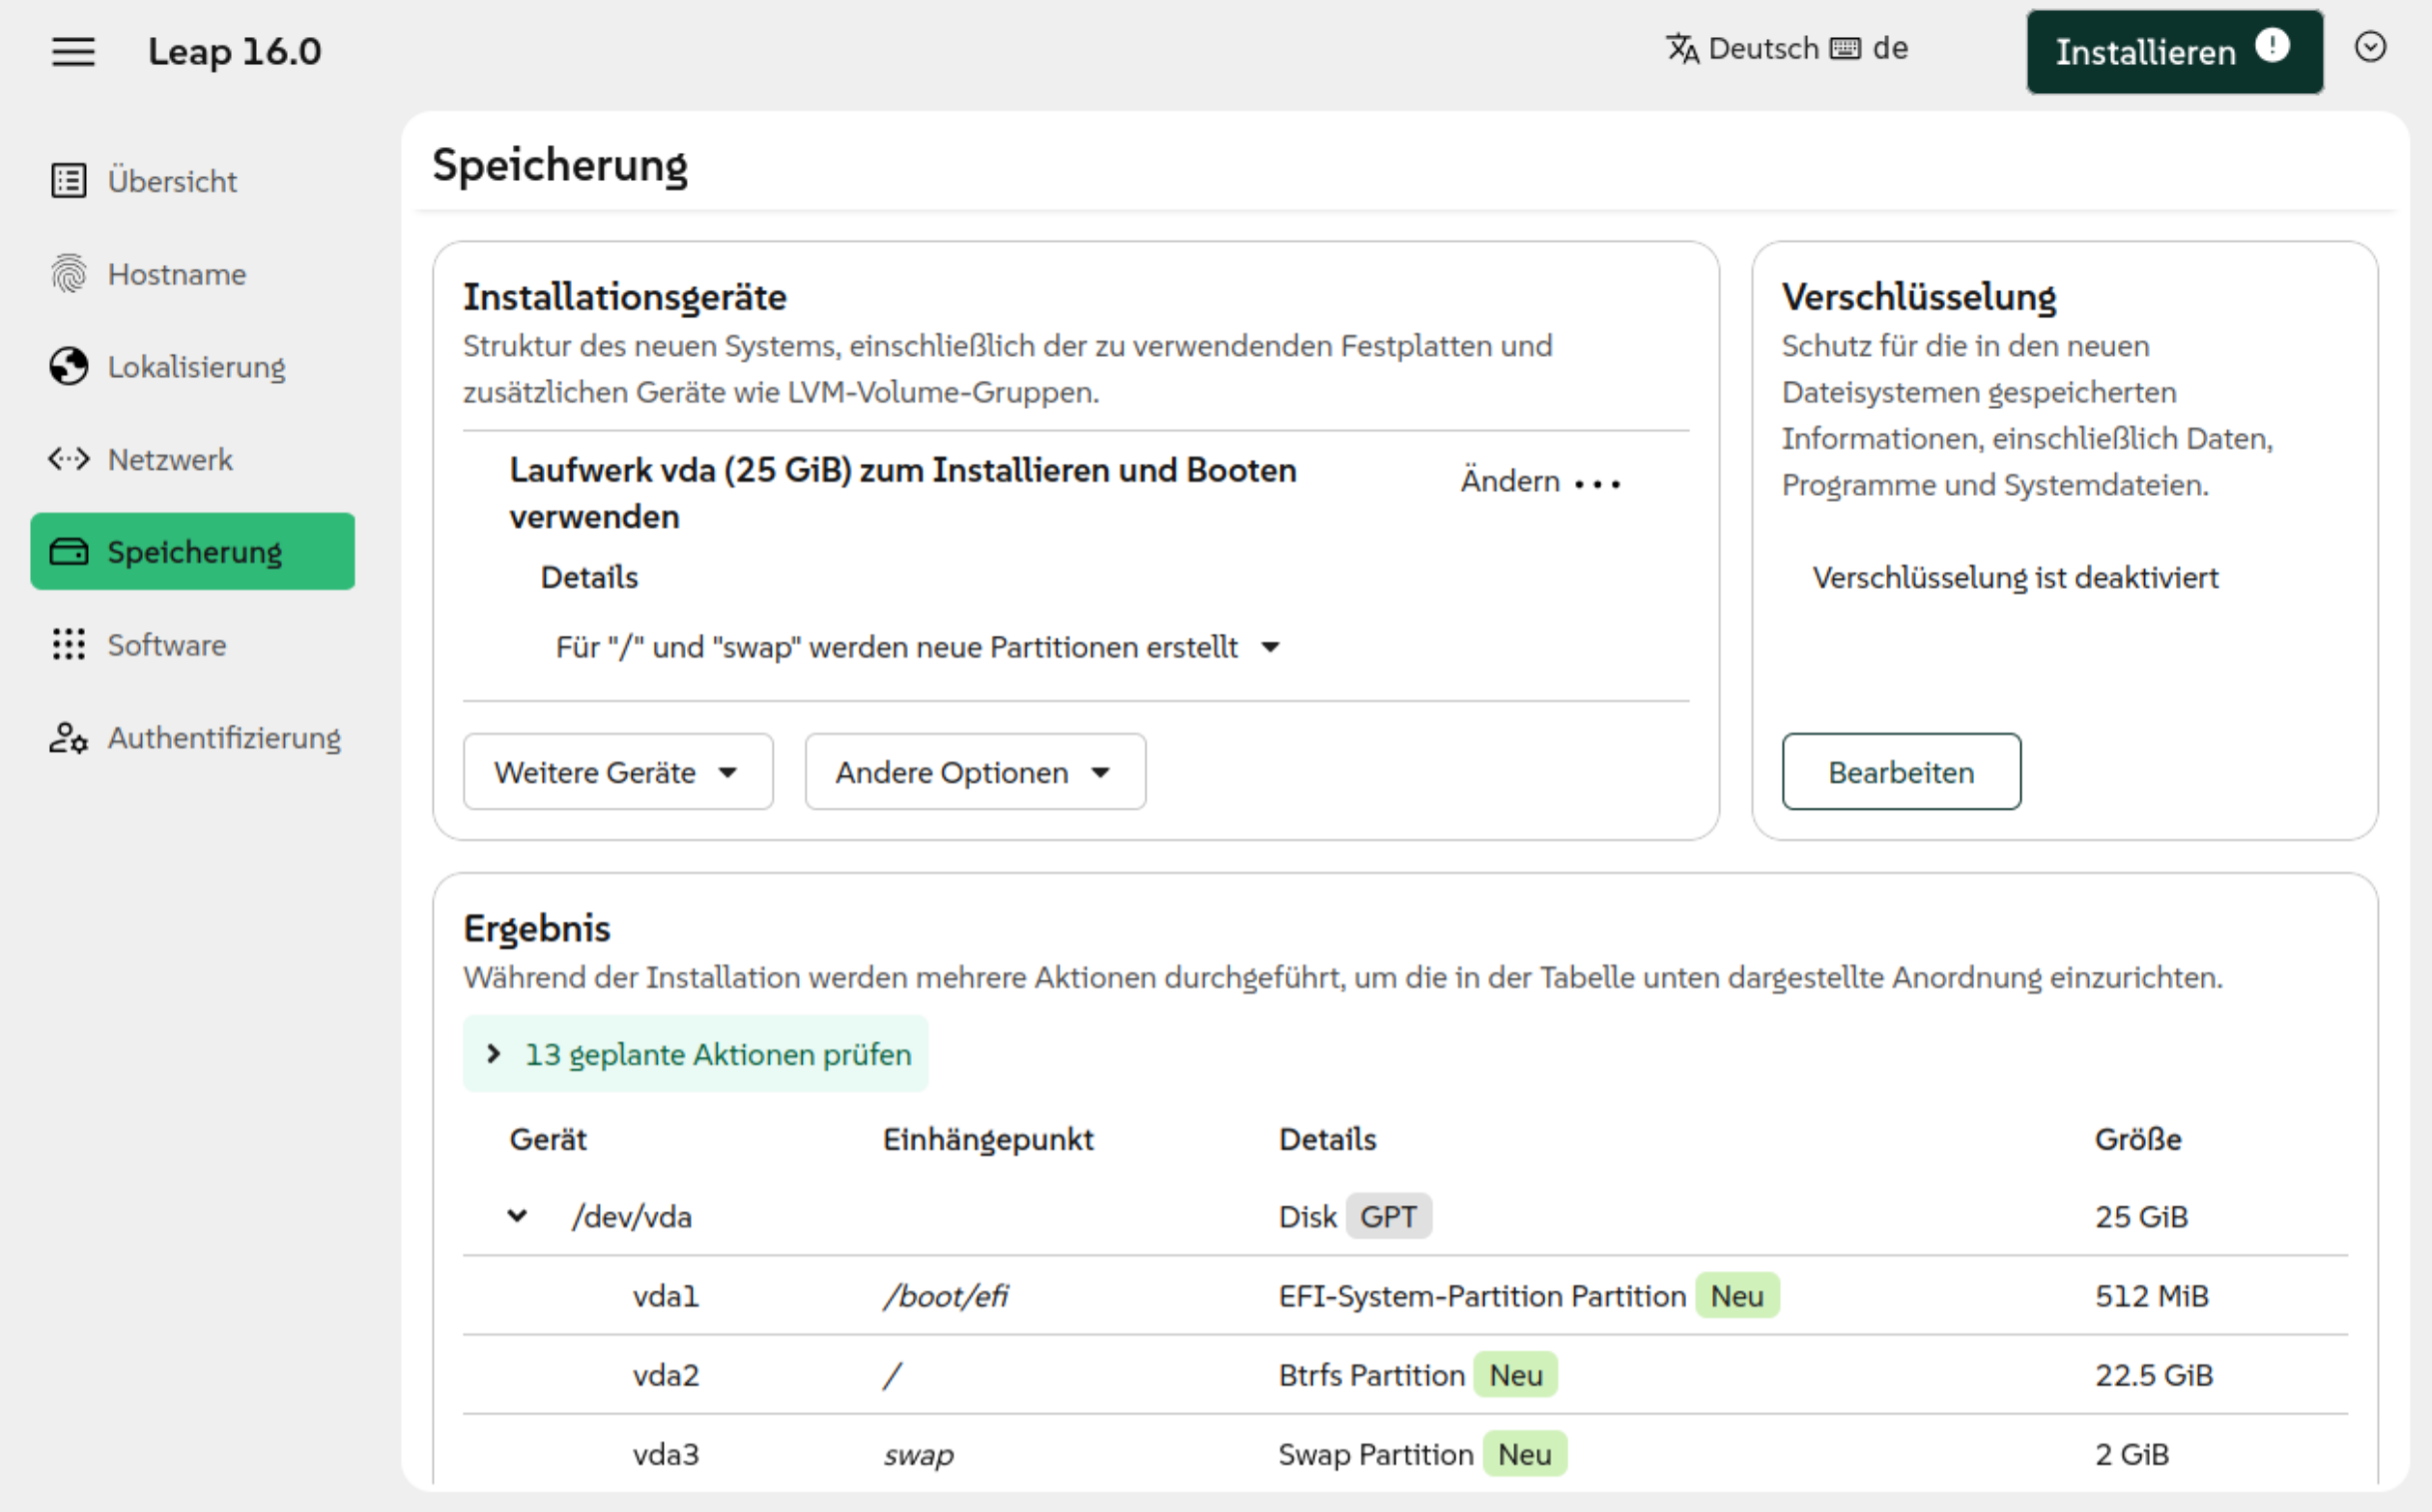
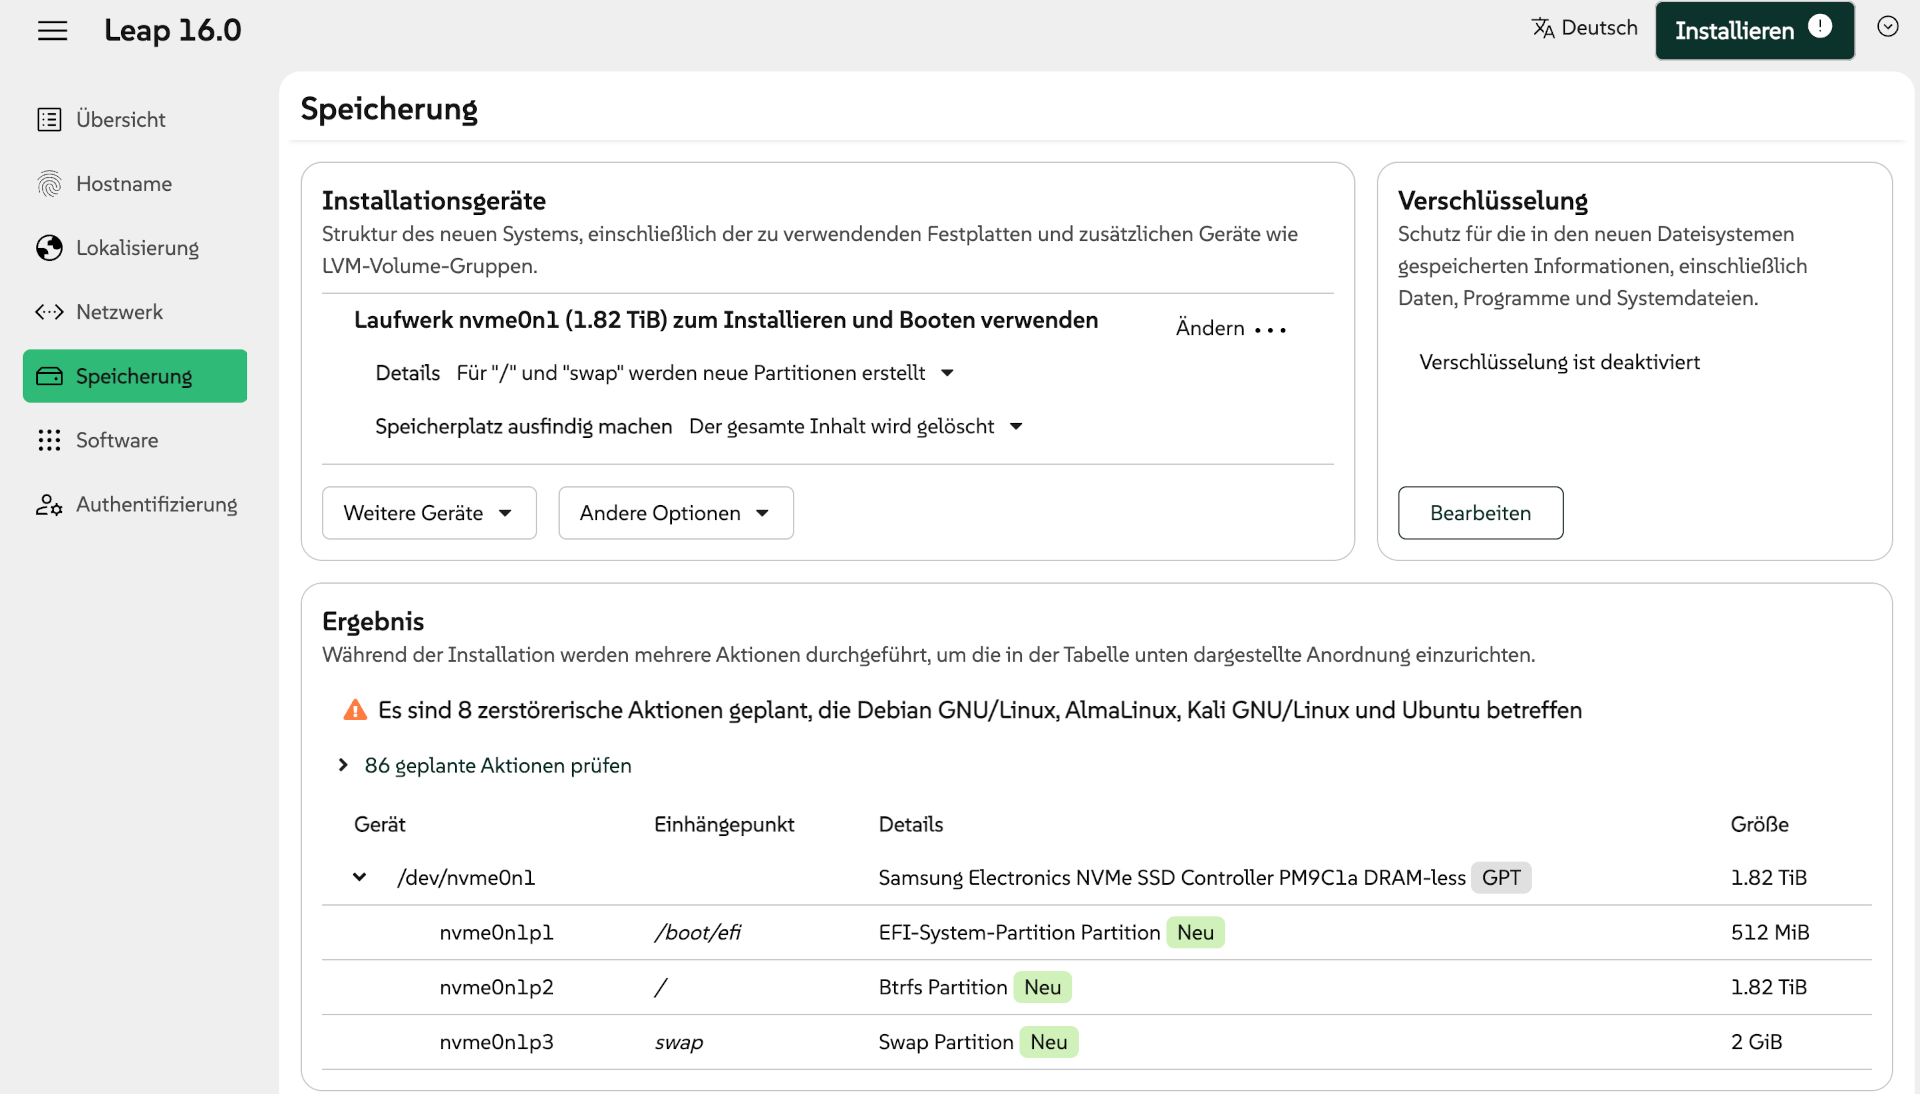
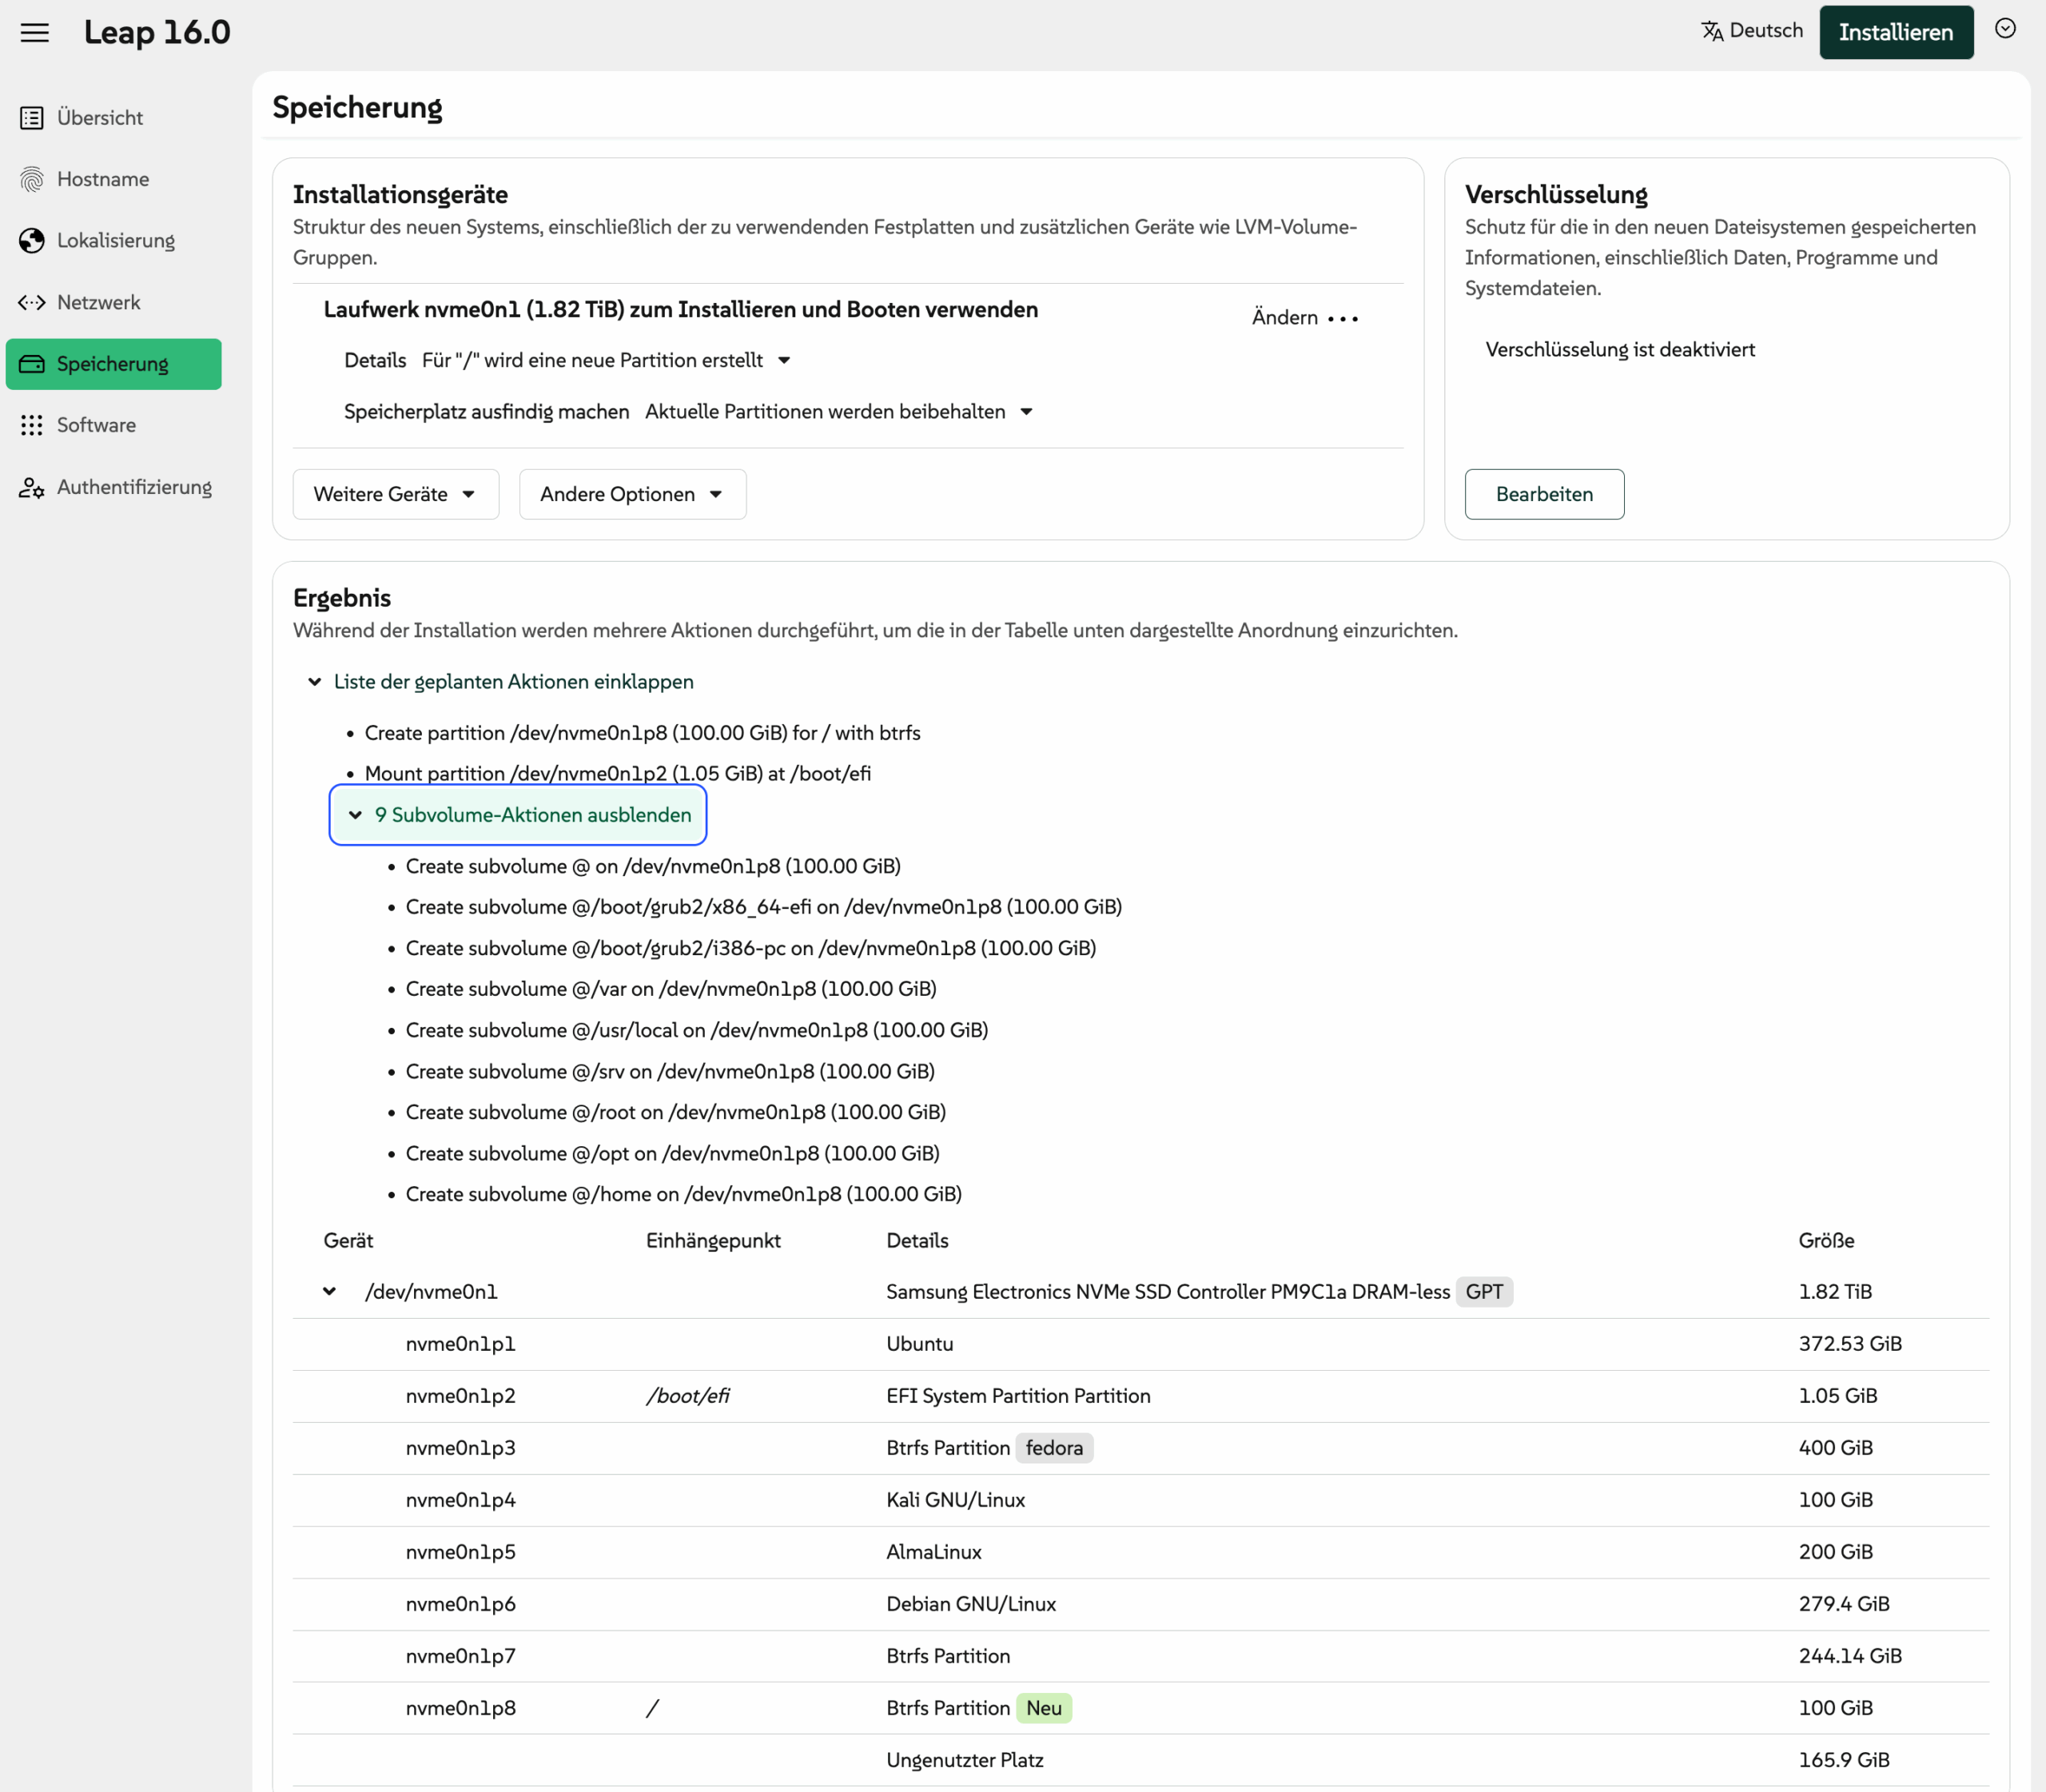
Damit kommen wir zur Partitionierung und zum Einrichten der Dateisystemeim Punkt Speicherung. Der Installer schlägt vor, drei Partitionen einzurichten: /boot/efi, eine Swap-Partition und eine Systempartition mit btrfs-Dateisystem und neu Subvolumes (/boot, /var, /root, /home usw.). Optional können Sie das Setup auf LVM umstellen (was im Zusammenspiel mit btrfs aber selten große Vorteile mit sich bringt) und eine Verschlüsselung aktivieren. Für Installationen in eine virtuelle Maschine oder auf einen Rechner, wo Sie einfach die gesamte SSD nutzen möchten, ist das Layout OK.
Wenig Auswahl bei der Partitionierung und Einrichtung der Dateisysteme
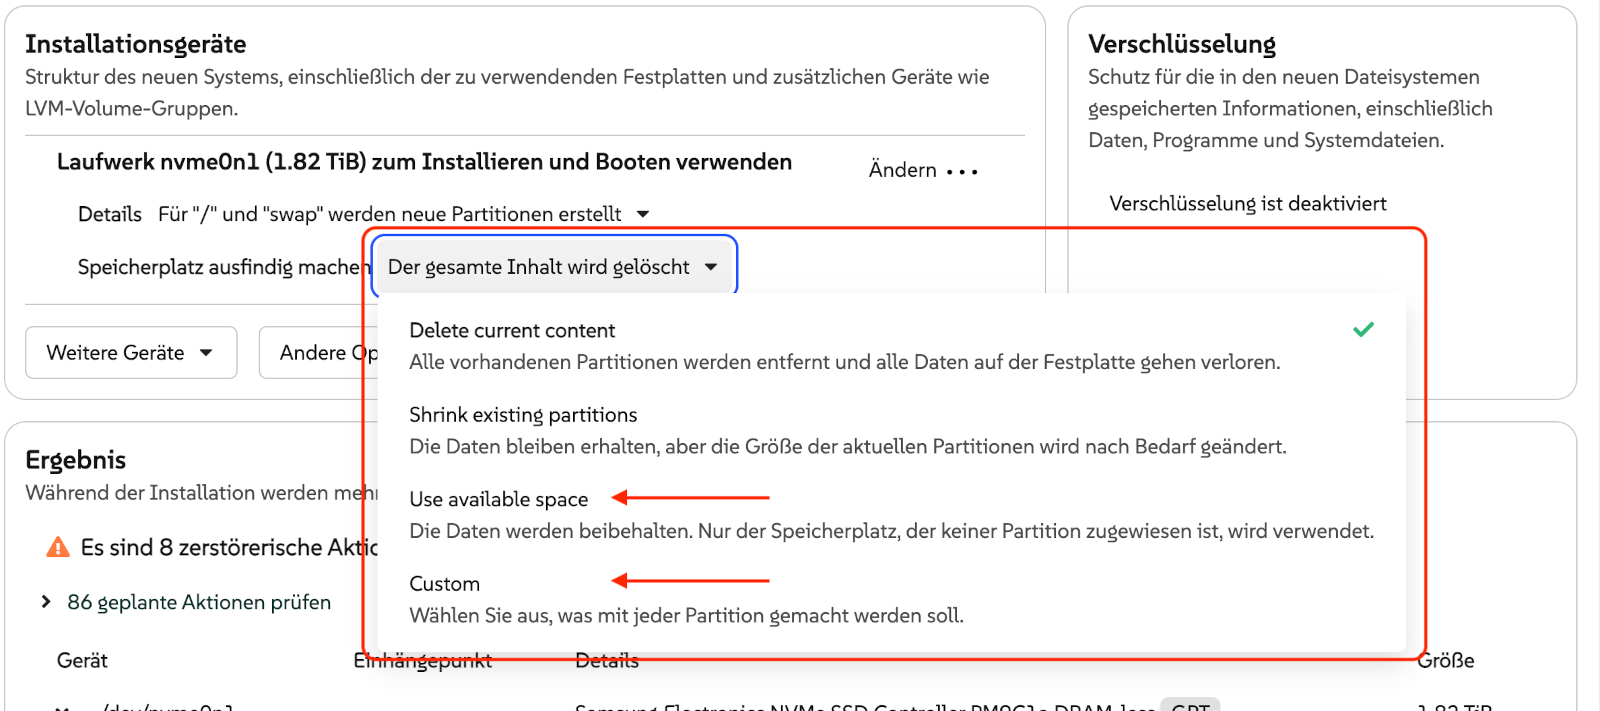
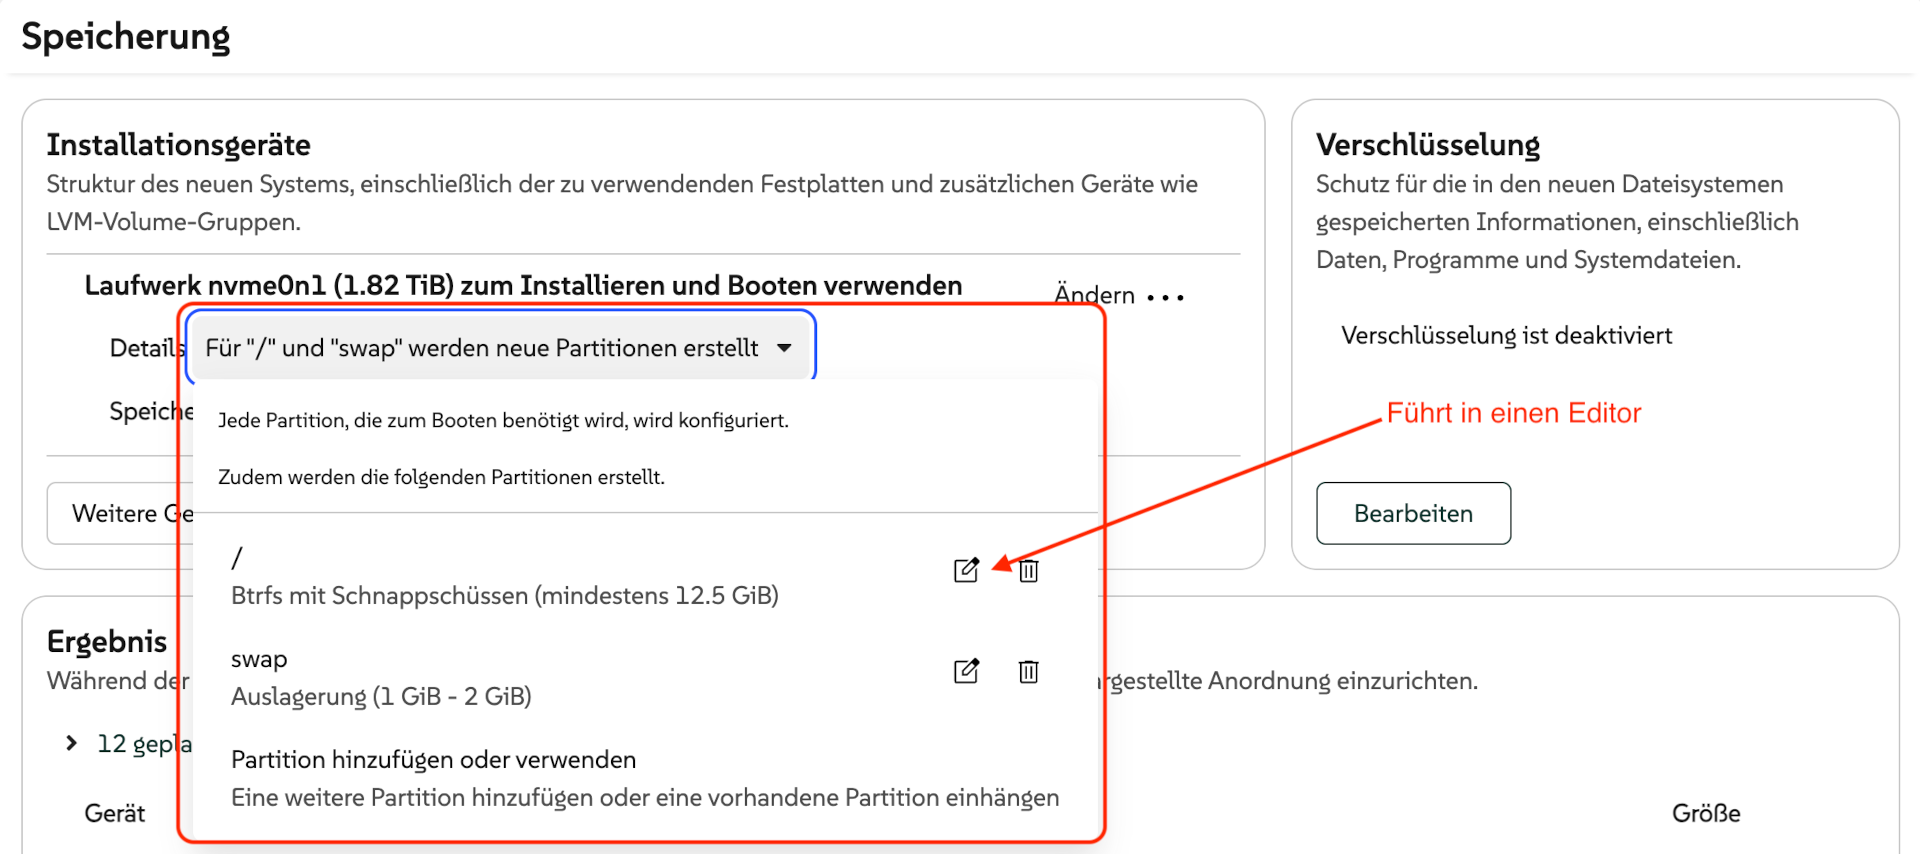
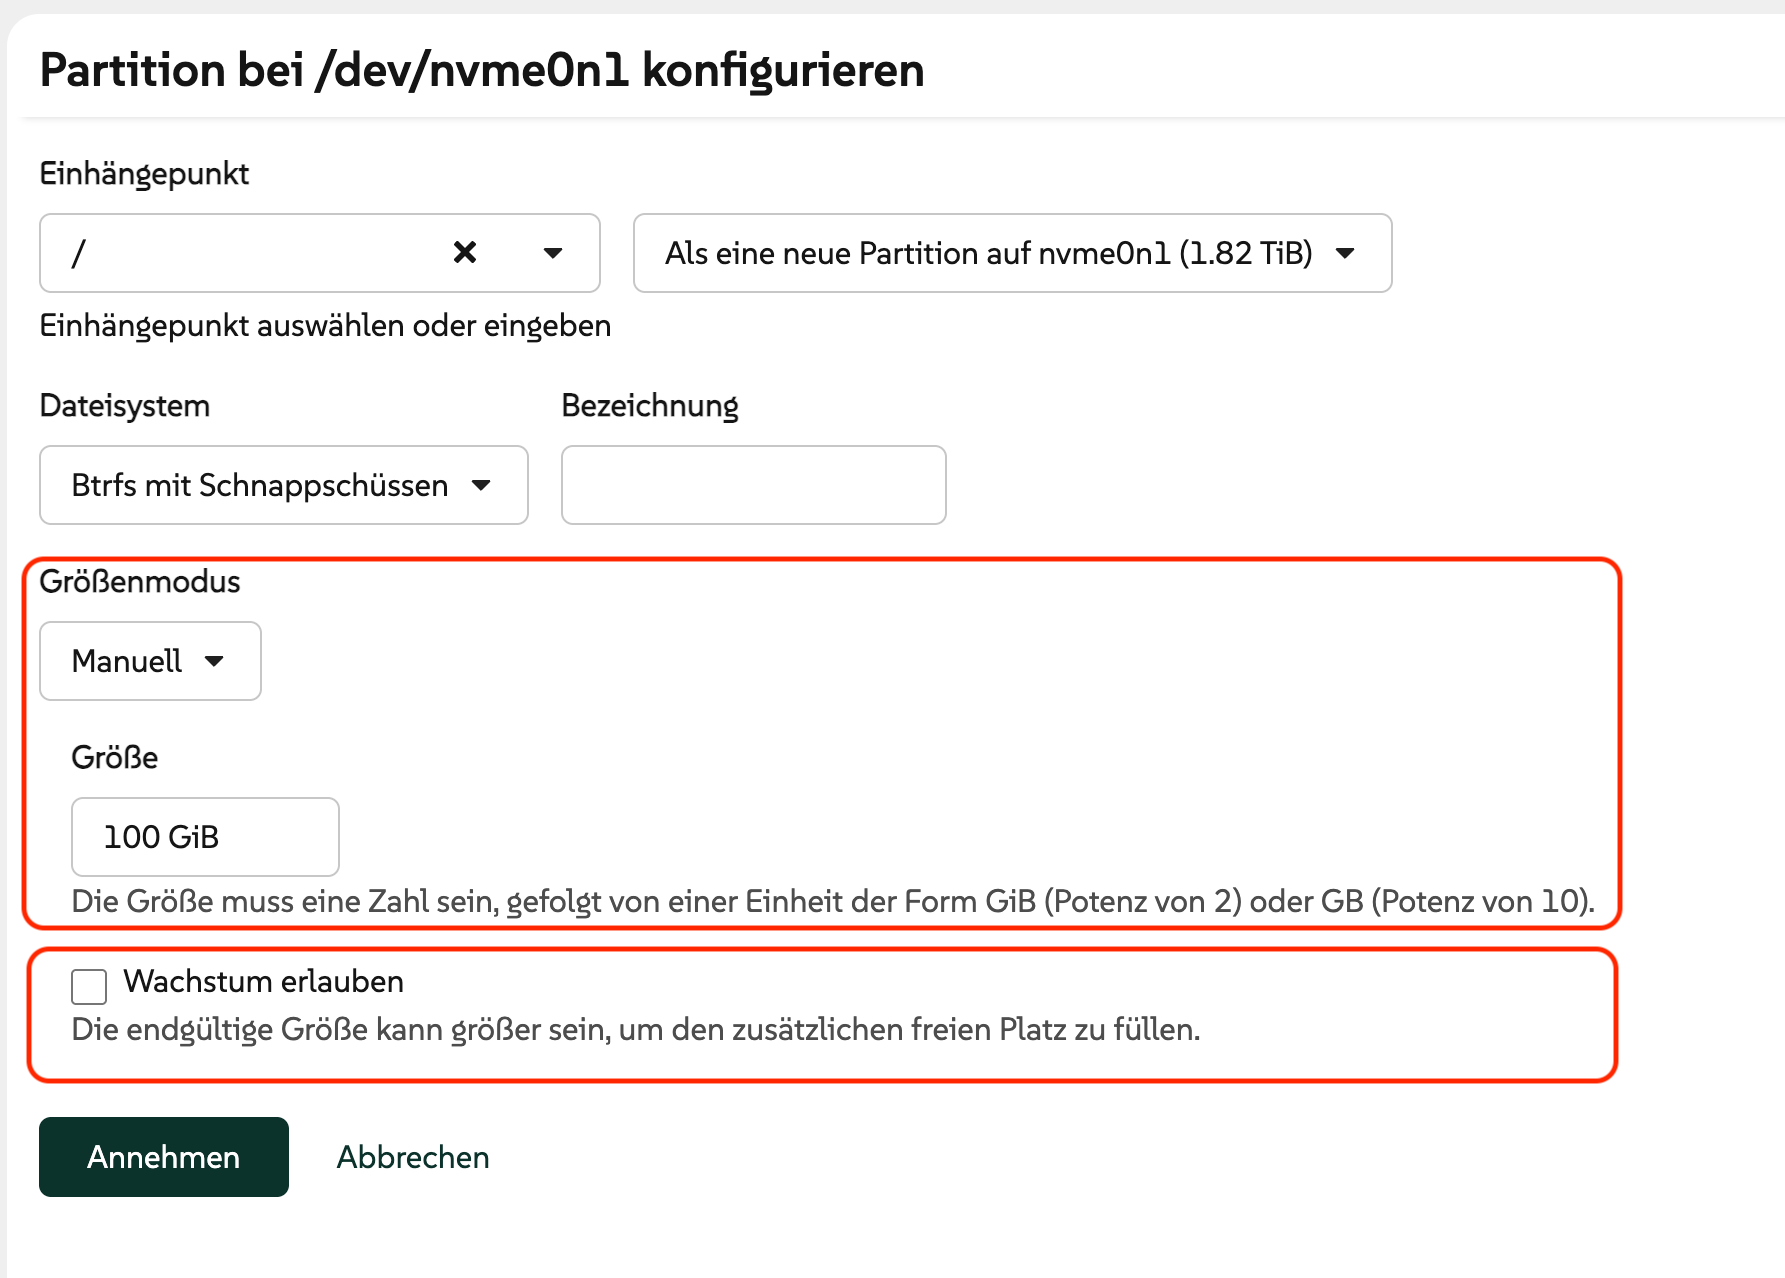
Auf »echter« Hardware schlägt das Setup-Programm vor, alle vorhandenen Partitionen des Datenträgers zu löschen und dann openSUSE zu installieren. VORSICHT!! Das Setup-Programm bietet die Möglichkeit, auf die Partitionierung Einfluss zu nehmen, die Menüs sind aber nicht ganz leicht zu erkennen (siehe die folgenden fünf Screenshots).
Vorsicht: Per Default löscht der Installer alle vorhandenen BetriebssystemeEine manuelle Partitionierung ist möglich, aber die Optionen sind gut verstecktWenn Sie einzelne Partitionen oder Dateisysteme ändern wollen, ist hier das entscheidende MenüDer Editor für eine Partition / ein DateisystemParallel-Installation von openSUSE zu diversen anderen Linux-Distributionen
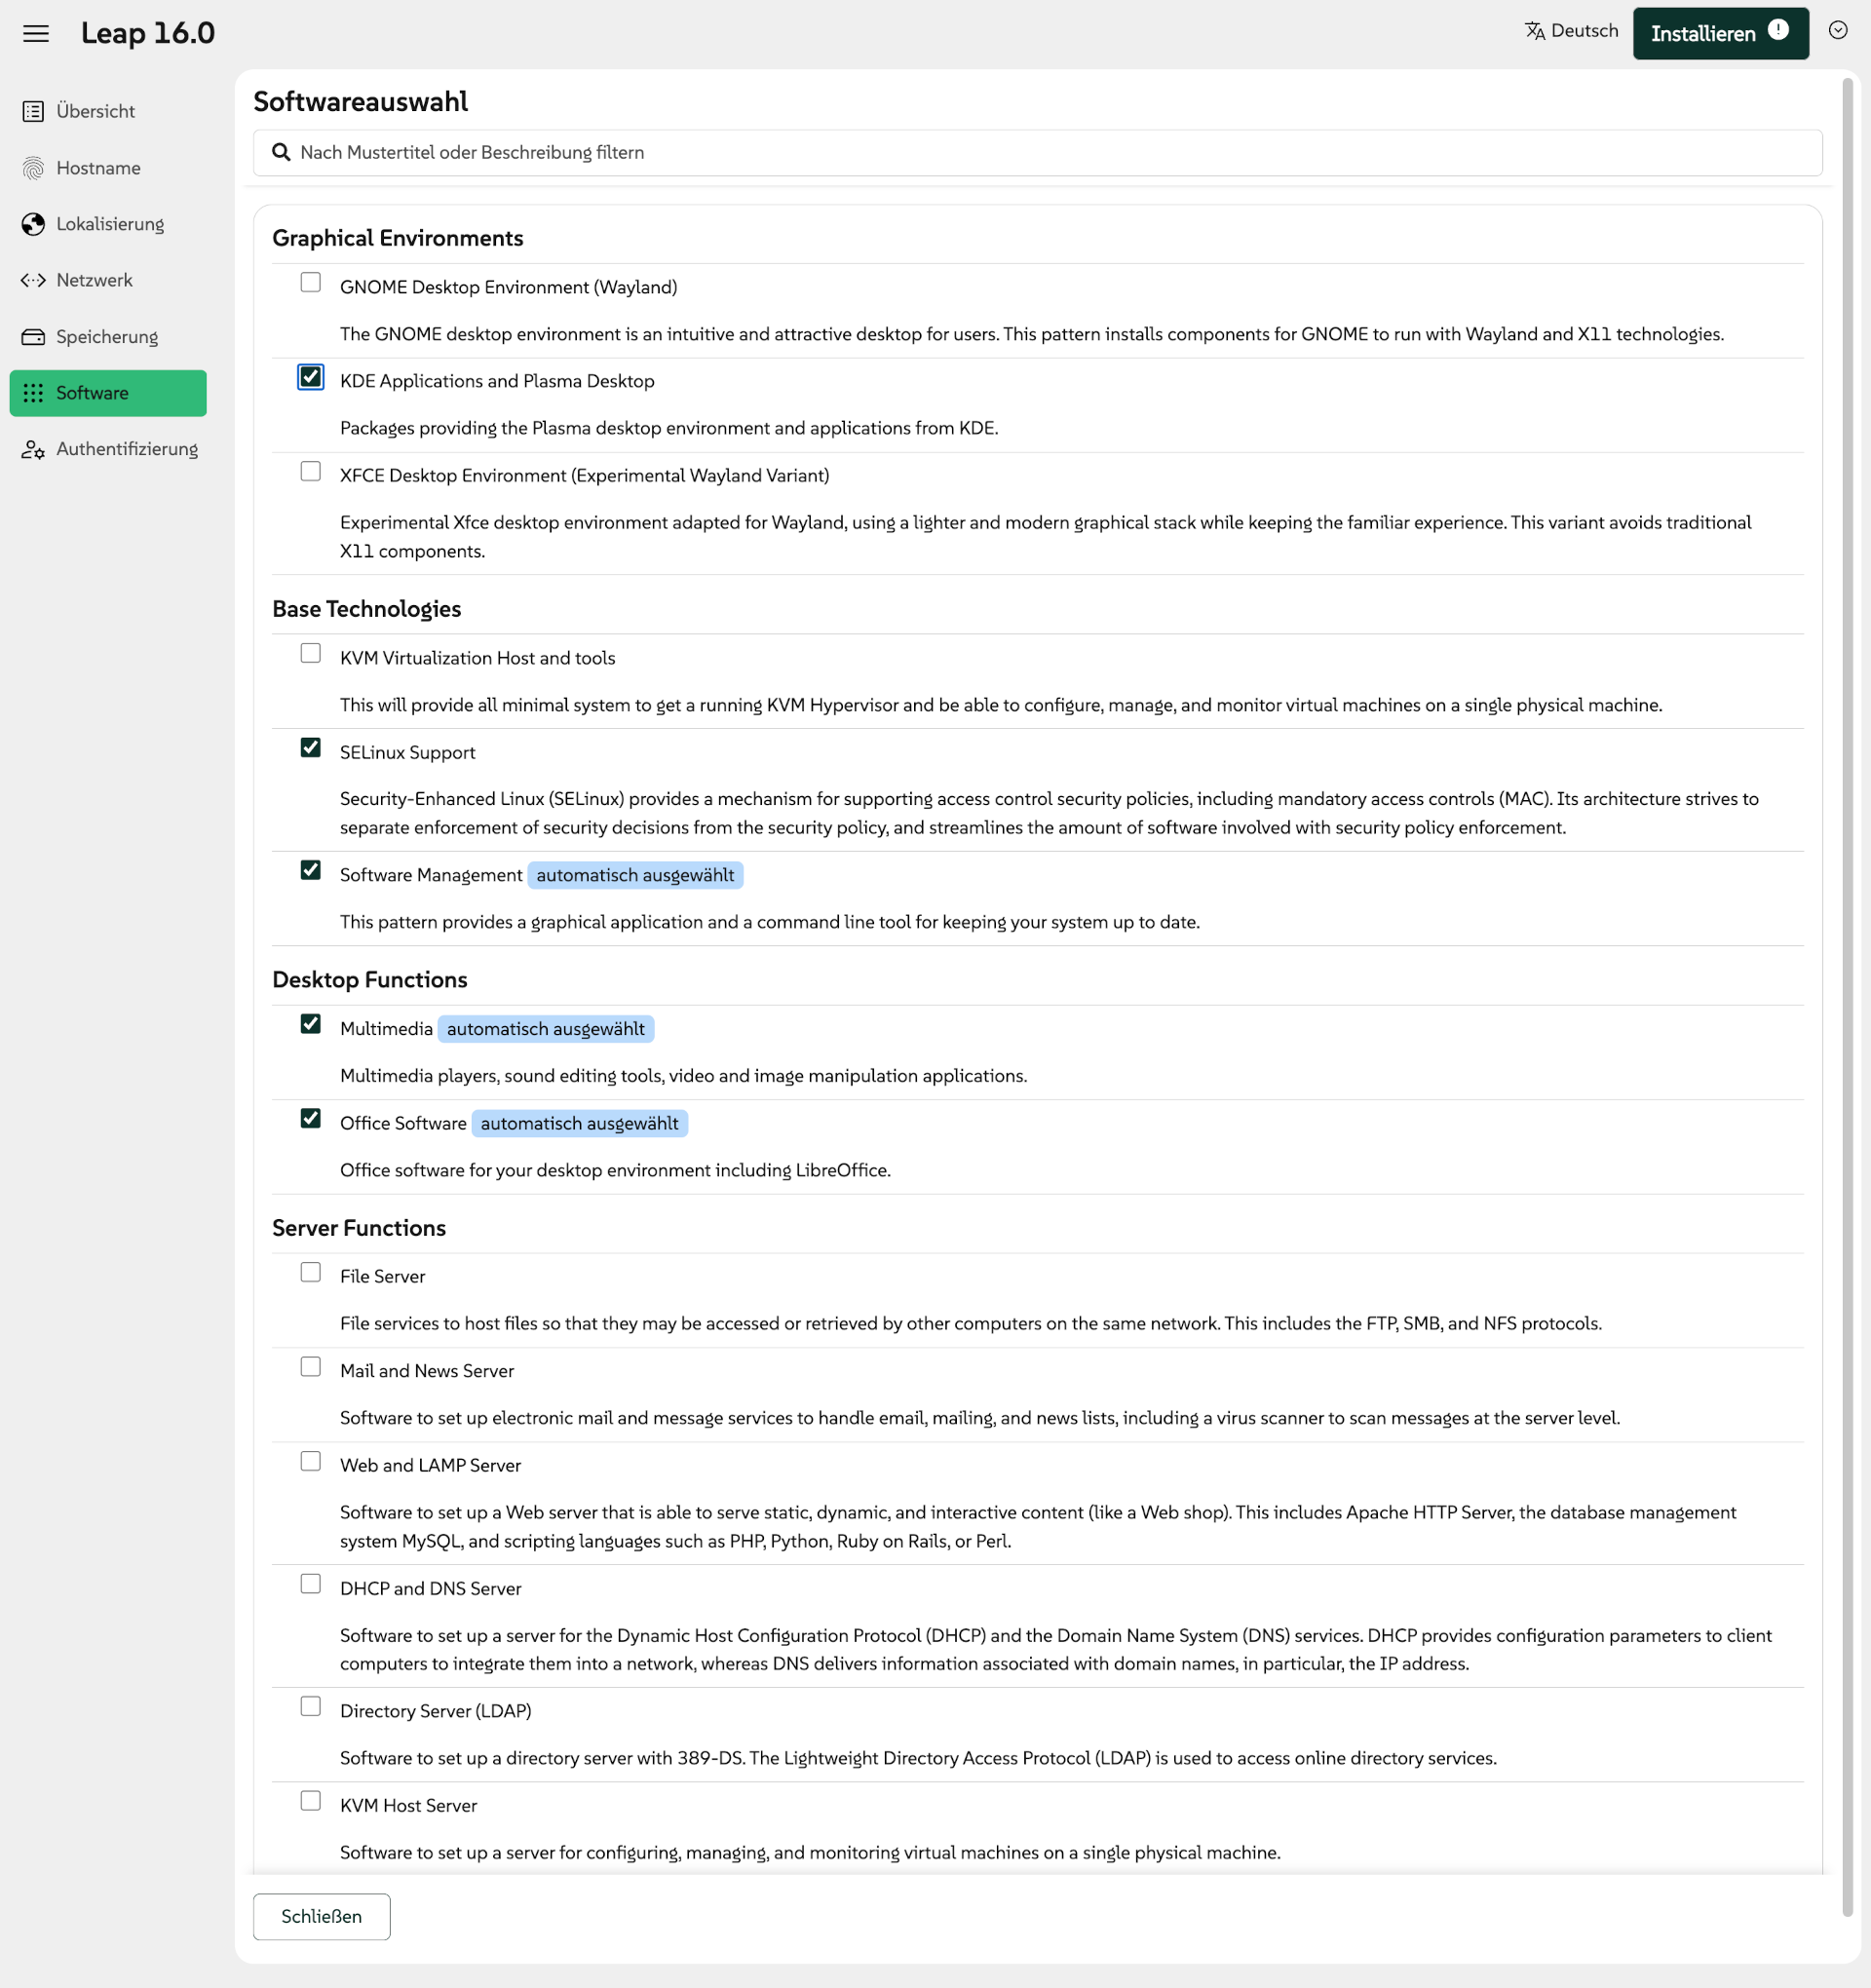
Aufpassen müssen Sie auch beim Punkt Software: Standardmäßig wird nur eine Minimalinstallation ohne Desktop-System durchgeführt! Sie müssen die Auswahl ändern und haben dann die Wahl zwischen Gnome, KDE und XFCE.
Bei der Software-Auswahl muss ein Desktop-System ausgewählt werden!
Zuletzt richten Sie einen Benutzer ein, der automatisch sudo-Rechte erhält. Installieren startet nun die Installation.
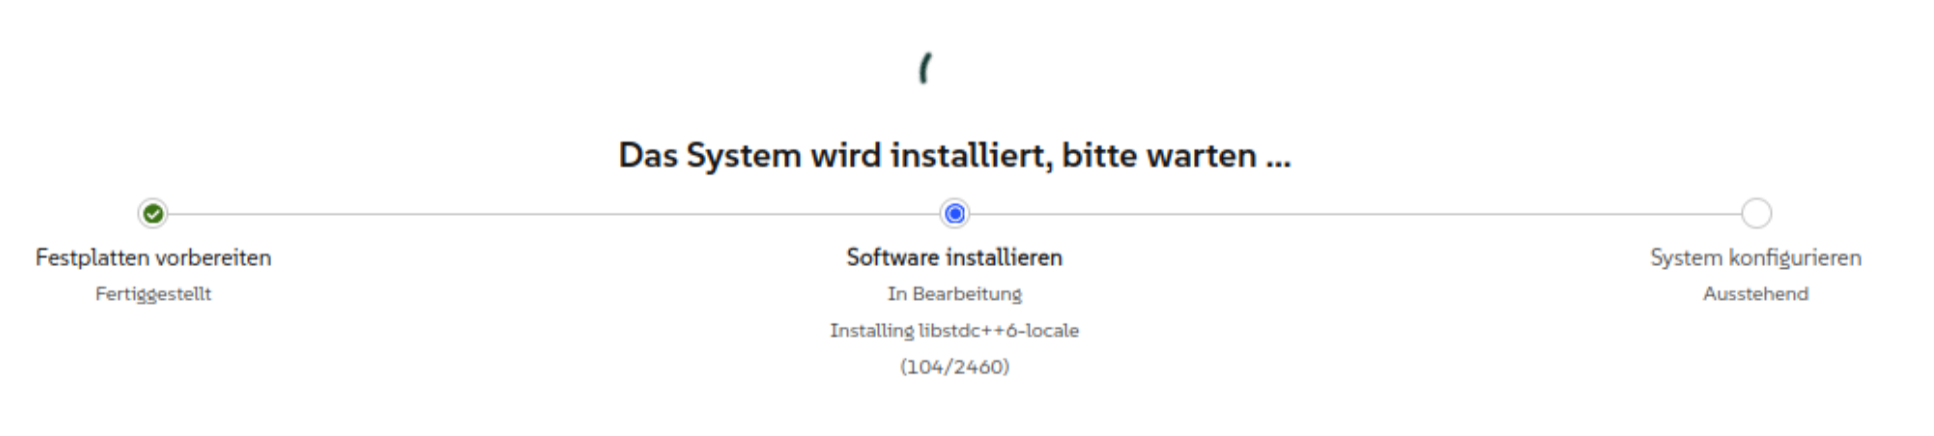
Jetzt läuft die Installation
Ich habe mehrere Installationen in VMs durchgeführt, eine »echte« auf meinen Mini-PC. Echte Fehler sind keine aufgetreten, aber intuitiv ist die Bedienung des neuen Installers wirklich nicht. Warum muss das Rad ununterbrochen neu erfunden werden, wenn soviele andere Linux-Probleme einer Lösung harren?
Software-Versionen und Paketverwaltung
Die Versionsnummern wichtiger Basispakete stimmen zum größten Teil mit jenen von Debian 13 überein.
Generell ist das Angebot in Leap 16 im Vergleich zu den Vorgängerversionen 15.n aber geschrumpft, worauf LinuxUser hinweist (32.400 Pakete im Vergleich zu 44.700). Für Desktop-Programme ist Flatpak die beste Alternative. Darüberhinaus wird sich weisen, wie groß das Angebot von Paketen sein wird, die in externen Repositories angeboten werden.
Für Multimedia-Pakete war in der Vergangenheit Packman zuständig. Es ist zu erwarten, dass es dort in Zukunft ein Leap-16-Repository geben wird. Aktuell ist das aber noch nicht der Fall.
Am Fundament der Paketverwaltung hat sich wenig geändert — dafür sind weiterhin rpm (Low-Level) und zypper (High-level) zuständig. Desktop-Programme können wahlweise mit Software (Gnome) oder Discover (KDE) installiert werden. Das allumfassende Paketverwaltungs-Modul innerhalb von YaST gibt es nicht mehr.
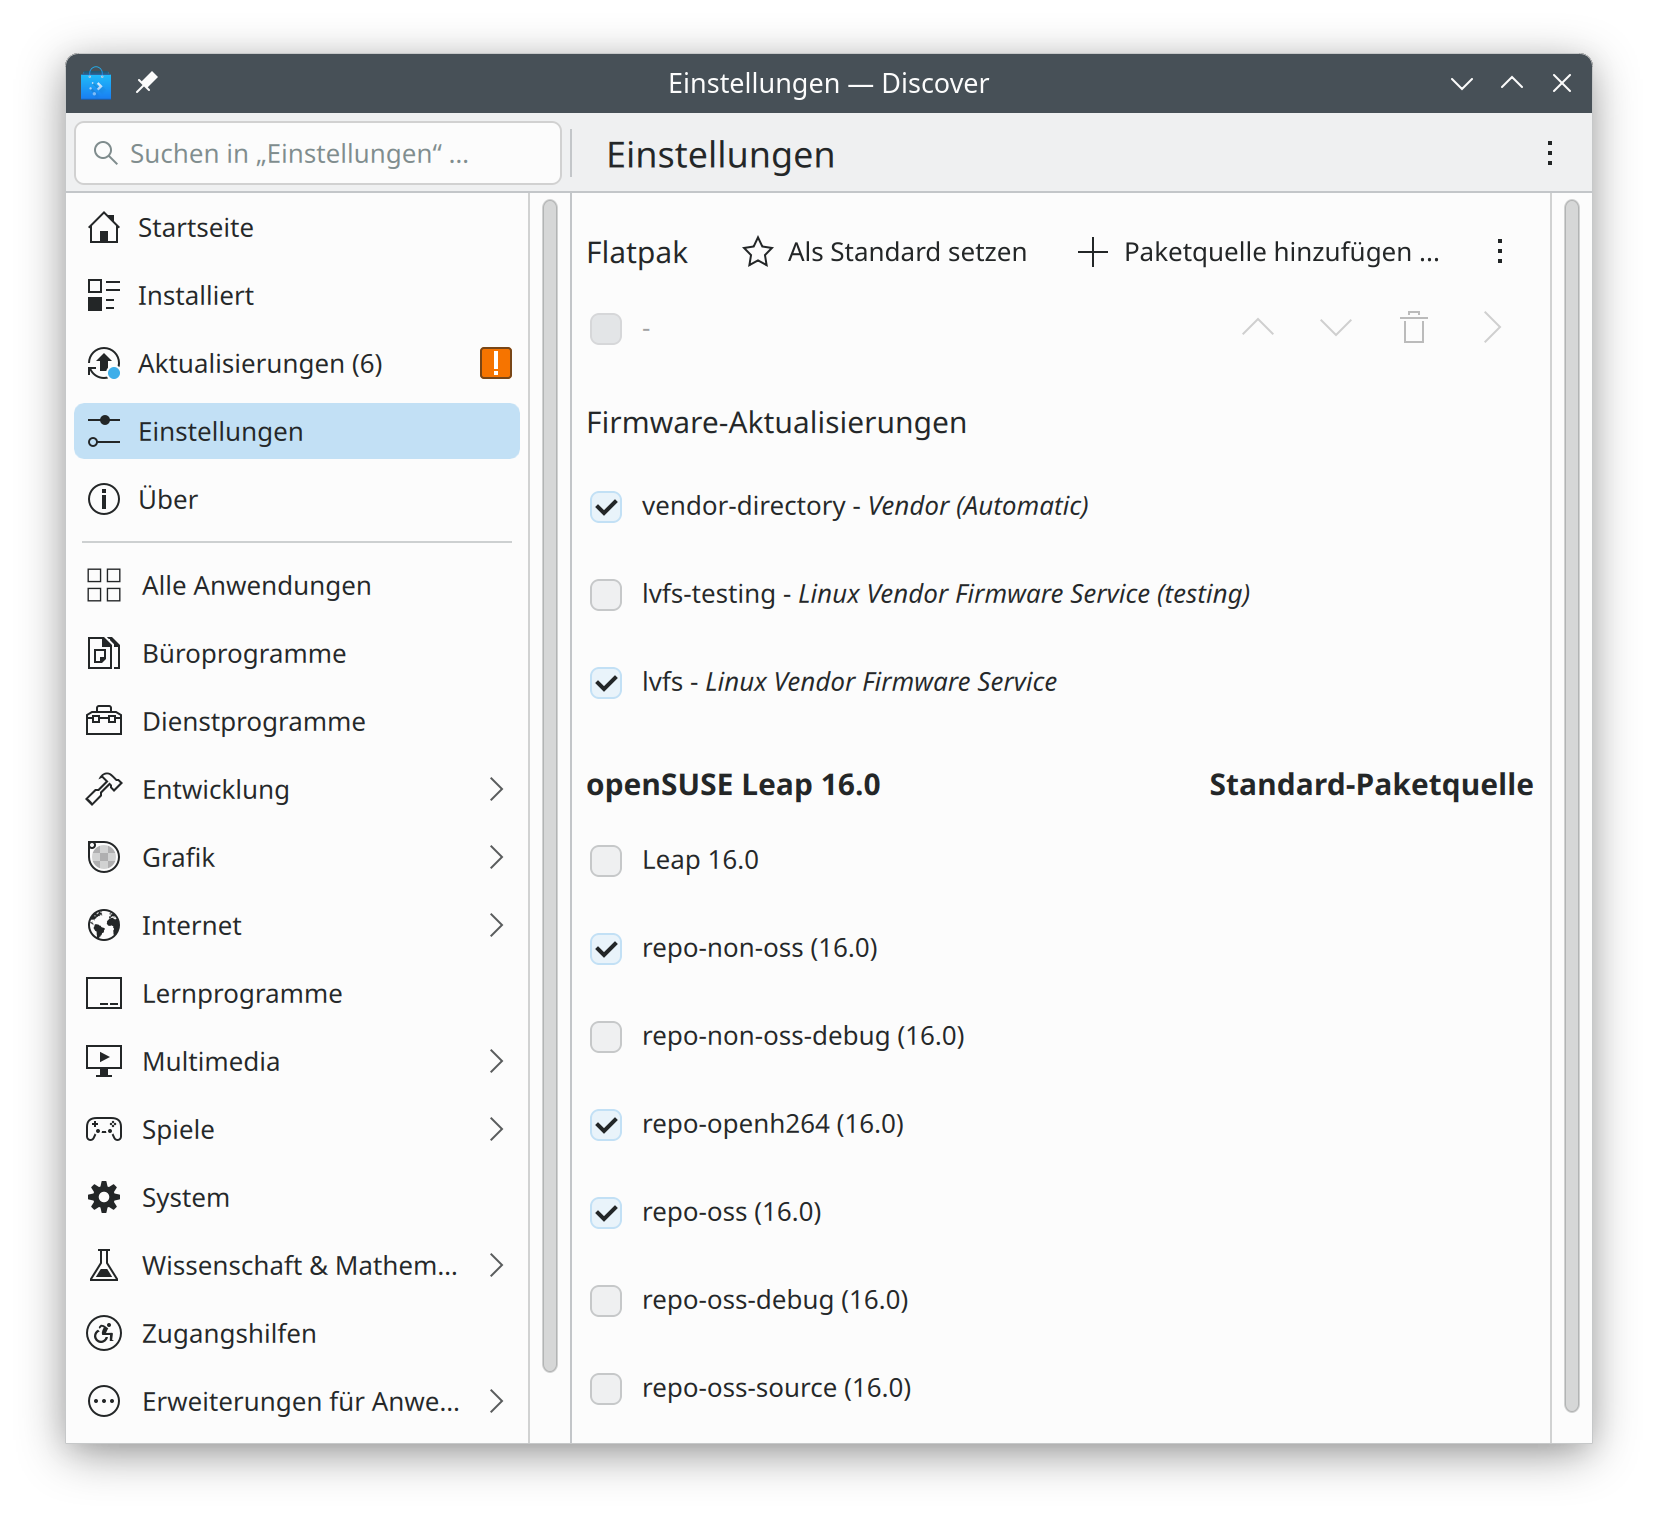
Standardmäßig sind nur die Repos repo-oss und repo-openh264 aktiv:
zypper repos

  Repository priorities are without effect. All enabled repositories share the same priority.

  # | Alias                       | Name                      | Enabled | GPG Check | Refresh
  --+-----------------------------+---------------------------+---------+-----------+--------
  1 | Leap                        | Leap 16.0                 | No      | ----      | ----
  2 | openSUSE:repo-non-oss       | repo-non-oss (16.0)       | No      | ----      | ----
  3 | openSUSE:repo-non-oss-debug | repo-non-oss-debug (16.0) | No      | ----      | ----
  4 | openSUSE:repo-openh264      | repo-openh264 (16.0)      | Yes     | (r ) Yes  | Yes
  5 | openSUSE:repo-oss           | repo-oss (16.0)           | Yes     | (r ) Yes  | Yes
  6 | openSUSE:repo-oss-debug     | repo-oss-debug (16.0)     | No      | ----      | ----
  7 | openSUSE:repo-oss-source    | repo-oss-source (16.0)    | No      | ----      | ----
Für Verwirrung — auch in Software und Discover — kann das inaktive Repo Leap 16.0 sorgen. Es bezieht sich aber nur auf das Installationsmedium und wird im weiteren Betrieb tatsächlich nicht mehr gebraucht.
Das non-oss-Repo enthält diverse proprietäre Programme:
Ich habe openSUSE sowohl mit Gnome als auch mit KDE installiert, aber die weiteren Tests dann in einem KDE-System durchgeführt. KDE verwendet sowohl in virtuellen Maschinen als auch auf echter Hardware X11. Das ist ein wenig enttäuschend, Fedora 42 läuft per default mit Wayland (Fedora 43 beta natürlich auch), und meine Erfahrungen damit waren ausgezeichnet.
Der Versuch, die Auflösung meines 4k-Monitors auf 1920×1080 zu reduzieren, scheiterte. Der Bildschirminhalt wird komplett falsch skaliert, oben und unter im Monitor bleibt ein schwarzer Streifen. Bei 2560×1600 kam gar kein Bild zustande. Diese Probleme hatte ich noch nie. Ich bin dann bei der 4k-Auflösung geblieben und habe die Skalierung verändert. Das funktioniert unter KDE glücklicherweise wunderbar.
Zur Paketverwaltung ist Discover vorgesehen. Prinzipiell funktioniert das Programm zufriedenstellend. Irritierend ist auch hier die (korrekt!) inaktive Paketquelle Leap 16.
Paketverwaltung mit Discover. Es irritiert, dass »Leap 16« nicht aktiv ist — aber diese Paketquelle ist nur für die Installation relevant, danach nicht mehr.
Bei der Systemadministration sind Sie auf die Module der KDE-Systemeinstellungen angewiesen. YaST steht nicht mehr zur Verfügung.
Wie schon erwähnt, entscheidet sich der Installer, wenn Sie nicht andere Optionen einstellen, für ein btrfs-Dateisystem mit vielen Subvolumes aber ohne Komprimierung.
Hinter den Kulissen gibt es eine Menge Neuerungen im Vergleich zu Version 15.n (siehe die Release Notes). Ganz kurz die wichtigsten Details:
Wie schon erwähnt: YaST gibt es nicht mehr. openSUSE empfiehlt, Cockpit zur Administration zu verwenden.
Per Default kommt SELinux zum Einsatz, AppArmor ist immerhin noch als Option verfügbar.
openSUSE 16 ist year-2038-safe.
openSUSE 16 soll bis 2031 jährlich mit neuen Versionen gepflegt werden. (Das wäre dann Version 16.6.) openSUSE 17 soll dann 2032 erscheinen. Warten wir ab, ob es dabei bleibt.
openSUSE 16 setzt bei x86-CPUs den V2-Level voraus. Konkret bedeutet das, dass die CPUs nicht älter als gut 15 Jahre sein dürfen (Details). 32-Bit-CPUs werden nicht mehr unterstützt.
Auf Rechnern mit NVIDIA-GPU werden die entsprechenden Paketquellen automatisch aktiviert und die proprietären Treiber installiert. Solche Systeme sollte jetzt out-of-the-box funktionieren. (Habe ich aber nicht getestet, mein Testrechner hat eine AMD-CPU/GPU.)
PulseAudio wurde durch PipeWire ersetzt.
Per Default darf root sich nicht via SSH anmelden. Verwenden Sie einen Account mit sudo-Rechten, oder ändern Sie ggfs. /etc/ssh/sshd_config.
libvirt + Docker: Wenn Sie Docker und libvirt (Qemu/KVM) einsetzen, funktioniert in den virtuellen Maschinen das Networking nicht mehr. Schuld ist Docker, das nicht in der Lage ist, sein Firewall-System auf nft umzustellen :-( Die Lösung ist gleich wie unter Fedora: Sie müssen das libvirt-Firewall-Backend zurück auf iptables setzen (Details).
nmap: Das populäre nmap-Tool hat die Lizenz geändert. openSUSE enthält die letzte Version unter der alten Lizenz.
Migrationstool
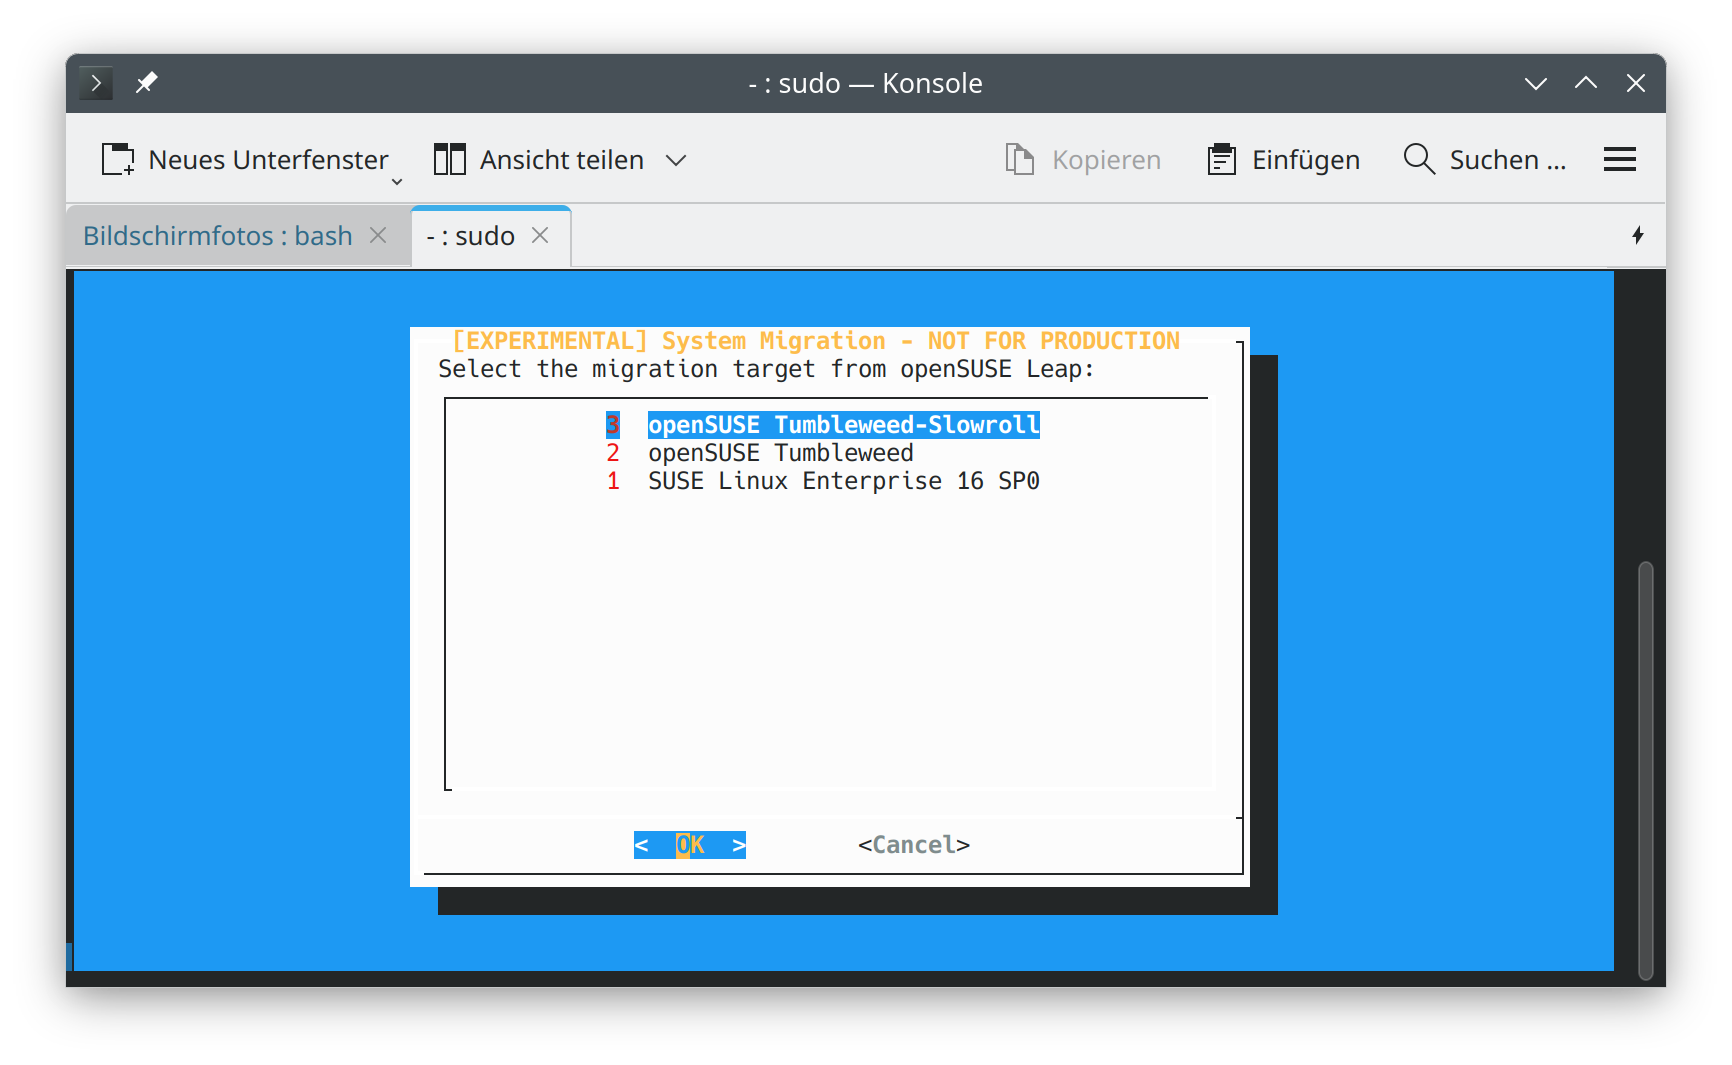
Es gibt ein neues Migrationstool, mit dem Sie einerseits openSUSE 15.6 auf Version 16.0 upgraden und andererseits einen Wechsel zwischen verschiedenen SUSE-Varianten (Leap, Tumblewheed, Slowroll, Enterprise) durchführen können. Ich habe das Programm allerdings nicht ausprobiert.
Das neue opensuse-migration-tool
SSH-Server und Firewall
Der SSH-Server wird standardmäßig installiert, läuft aber nicht. Abhilfe:
systemctl enable --now sshd
Als Firewall läuft standardmäßig das von Fedora und RHEL bekannte Programm firewalld. Standardmäßig sind nur die Ports für SSH und den DHCP-Client offen:
firewall-cmd --list-services

  dhcpv6-client ssh
Qemu/KVM-Zwischenablage
Wenn Sie openSUSE 16 in einer virtuellen Maschine mit Qemu ausführen, funktioniert die Zwischenablage nicht. Abhilfe: zypper install spice-vdagent, unter Gnome (Wayland!) zusätzlich zypper install wl-clipboard.
Fazit
In openSUSE 16 ist viel Zeit, Mühe und Liebe geflossen — und das Ergebnis kann sich wirklich sehen lassen. Die Frage ist allerdings, ob das reicht. Das Angebot am Distributionsmarkt ist überwältigend groß, und mir fällt es ehrlich schwer, eine klare Zielgruppe für openSUSE zu erkennen.
Den Mainstream decken Debian, Fedora und Ubuntu ab. Meine Empfehlung an Linux-Desktop-Einsteiger geht ganz stark in diese Richtung.
Server-seitig wieder Debian und Ubuntu plus RHEL und Klone.
Wer gerne immer Up-to-date ist: Arch Linux (oder ein Derivat).
CachyOS kitzelt maximale Performance aus dem Rechner, verbunden mit den Arch-Linux-Vorteilen und aktuell einem Hype-Faktor.
Linux Mint vielleicht für Einsteiger. (Ich war allerdings nie ein riesiger Mint-Fan und sehe wenig Vorteile im Vergleich zu Debian/Fedora/Ubuntu.)
Pop!_OS als Distribution für system76-Kunden. Und falls der COSMIC-Desktop je fertig + stabil wird, könnte die Distribution ein interessantes Angebot für technisch orientierte Anwender werden (Entwickler/Admins/Freaks).
Im Vergleich zu Debian/Fedora/Ubuntu ist in Leap 16 das Software-Angebot geringer. Die Aktualität vieler Pakete kann wiederum mit Fedora und Ubuntu nicht mithalten. Als ausgesprochen einsteigerfreundlich empfinde ich Leap auch nicht (schon gar nicht die Installation). YaST als Argument fällt weg. (Das Konfigurations-Tool wurde schon in den letzten Jahren nur noch sehr halbherzig gepflegt.) Der Dateisystem-Editor von openSUSE während der Installation war Weltklasse, aus meiner Sicht besser als bei allen anderen Distributionen. Er ist dem neuen Installationsprogramm zum Opfer gefallen.
Wer sollte sich also für openSUSE entscheiden, und warum? openSUSE 16 ist natürlich eine super Trainings-Umgebung für SLES 16. Aber ist das genug? Selbst innerhalb der SUSE-Welt empfand ich Tumblewheel (oder Slowroll) in den letzten Jahren deutlich spannender als Leap.
Raspberry Pi OS »Bookworm« verwendet bekanntlich auf den Modellen 4* und 5 standardmäßig Wayland. Dabei kam als sogenannter »Compositor« das Programm Wayfire zum Einsatz. (Der Compositor ist unter anderem dafür zuständig, Fenster am Bildschirm anzuzeigen und mit einem geeigneten Fensterrahmen zu dekorieren.)
Mit dem neuesten Update von Raspberry Pi OS ändern sich nun zwei Dinge:
Anstelle von Wayfire kommt ein anderer Compositor zum Einsatz, und zwar labwc (GitHub).
Wayland kommt auf allen Raspberry Pis zum Einsatz, auch auf älteren Modellen.
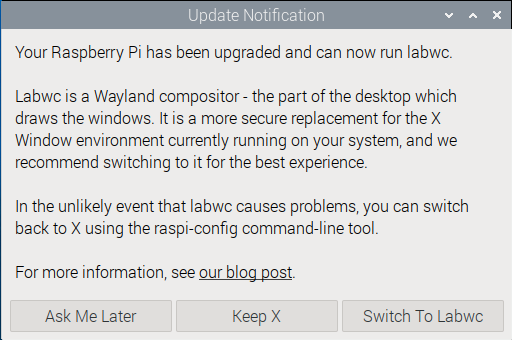
Wenn Sie auf Ihrem Raspberry Pi das nächste Update durchführen, werden Sie bei nächster Gelegenheit gefragt, ob Sie auf labwc umstellen möchten. Aktuell werden Sie keinen großen Unterschied feststellen — labwc sollte genau wie wayfire funktionieren (vielleicht ein klein wenig effizienter). Langfristig haben Sie keine große Wahl: Die Raspberry Pi Foundation hat angekündigt, dass sie sich in Zukunft auf labwc konzentrieren und wayfire nicht weiter pflegen wird. Nach der Auswahl wird Ihr Raspberry Pi sofort neu gestartet.
Sie haben die Wahl: Wollen Sie X verwenden oder Wayland mit labwc
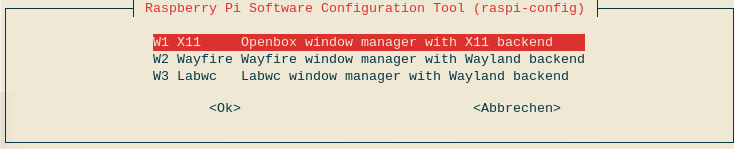
Alternativ können Sie die Einstellung auch mit sudo raspi-config durchführen. Unter Advanced Options / Wayland haben Sie die Wahl zwischen allen drei Optionen.
Einstellung des Grafiksystems in raspi-config
Bei meinen Tests stand nach dem Umstieg auf labwc nur noch das US-Tastatur-Layout zur Verfügung. Eine Neueinstellung in Raspberry Pi Configuration löste dieses Problem. Auch die Monitor-Konfiguration musste ich wiederholen. Dabei kommt auch ein neues Tool zum Einsatz(raindrop statt bisher arandr), das optisch aber nicht von seinem Vorgänger zu unterscheiden ist.
Ansonsten habe ich bei meinen Tests keinen großen Unterschied festgestellt. Alles funktioniert wie bisher.
Die Aufgabenstellung ist sehr speziell, und dementsprechend wird dieser Beitrag vermutlich nur wenig Leute interessieren. Aber egal: Ich habe mich drei Tage damit geärgert, vielleicht profitieren ein paar Leser von meinen Erfahrungen …
Die Zielsetzung ist bereits in der Überschrift beschrieben. Ich besitze einen Mini-PC mit AMD 8745H-CPU und 32 GiB RAM. Die CPU enthält auch eine integrierte GPU (Radeon 780M). Auf diesem Rechner wollte ich das momentan sehr beliebte Sprachmodell gpt-oss-20b ausführen. Dieses Sprachmodell ist ca. 11 GiB groß, umfasst 20 Milliarden Parameter in einer etwas exotischen Quantifizierung. (MXFP4 wurde erst 2024 standardisiert und bildet jeden Parameter mit nur 4 Bit ab. Die Besonderheit besteht darin, dass für unterschiedliche Teile des Modells unterschiedliche Skalierungsfaktoren verwendet werden, so dass die Parameter trotz der wenigen möglichen Werte einigermaßen exakt abgebildet werden können.)
Das Sprachmodell wird von der Firma OpenAI kostenlos angeboten. Die Firma gibt an, dass die 20b-Variante ähnlich gute Ergebnisse wie das bis 2024 eingesetzt kommerzielle Modell o3-mini liefert, und auch KI-Experte Simon Willison singt wahre Lobeshymnen auf das Modell.
PS: Ich habe alle Tests unter Fedora 42 durchgeführt.
Warum nicht Ollama?
Für alle, die nicht ganz tief in die lokale Ausführung von Sprachmodellen eintauchen wollen, ist Ollama zumeist die erste Wahl. Egal, ob unter Windows, Linux oder macOS, viele gängige Sprachmodelle können damit unkompliziert ausgeführt werden, in der Regel mit GPU-Unterstützung (macOS, Windows/Linux mit NVIDIA-GPU bzw. mit ausgewählten AMD-GPUs).
Bei meiner Hardware — und ganz allgemein bei Rechnern mit einer AMD-iGPU — ist Ollama aktuell aber NICHT die erste Wahl:
ROCm: Ollama setzt bei NVIDIA-GPUs auf das Framework CUDA (gut), bei AMD-GPUs auf das Framework ROCm (schlecht). Dieses Framework reicht alleine vermutlich als Grund, warum AMD so chancenlos gegen NVIDIA ist. Im konkreten Fall besteht das Problem darin, dass die iGPU 780M (interner ID gfx1103) offiziell nicht unterstützt wird. Die Empfehlung lautet, ROCm per Umgebungsvariable zu überzeugen, dass die eigene GPU kompatibel zu einem anderen Modell ist (HSA_OVERRIDE_GFX_VERSION=11.0.2). Tatsächlich können Sprachmodelle dann ausgeführt werden, aber bei jeder Instabilität (derer es VIELE gibt), stellt sich die Frage, ob nicht genau dieser Hack der Anfang aller Probleme ist.
Speicherverwaltung: Auch mit diesem Hack scheitert Ollama plus ROCm-Framework an der Speicherverwaltung. Bei AMD-iGPUs gibt es zwei Speicherbereiche: fix per BIOS allozierten VRAM sowie dynamisch zwischen CPU + GPU geteiltem GTT-Speicher. (Physikalisch ist der Speicher immer im RAM, den sich CPU und GPU teilen. Es geht hier ausschließlich um die Speicherverwaltung durch den Kernel + Grafiktreiber.)
Ollama alloziert zwar den GTT-Speicher, aber maximal so viel, wie VRAM zur Verfügung steht. Diese (Un)Logik ist am besten anhand von zwei Beispielen zu verstehen. Auf meinem Testrechner habe ich 32 GiB RAM. Standardmäßig reserviert das BIOS 2 GiB VRAM. Der Kernel markiert dann 14 GiB als GTT. (Das kann bei Bedarf mit den Kerneloptionen amdttm.pages_limit und amdttm.page_pool_size verändert werden.) Obwohl mehr als genug Speicher zur Verfügung steht, sieht Ollama eine Grenze von 2 GiB und kann nur winzige LLMs per GPU ausführen.
Nun habe ich im BIOS das VRAM auf 16 GiB erhöht. Ollama verwendet nun 16 GiB als Grenze (gut), nutzt aber nicht das VRAM, sondern den GTT-Speicher (schlecht). Wenn ich nun ein 8 GiB großes LLM mit Ollama ausführen, dann bleiben fast 16 GiB VRAM ungenutzt! Ollama verwendet 8 GiB GTT-Speicher, und für Ihr Linux-System bleiben gerade einmal 8 GiB RAM übrig. Es ist zum aus der Haut fahren! Im Internet gibt es diverse Fehlerberichte zu diesem Problem und sogar einen schon recht alten Pull-Request mit einem Vorschlag zur Behebung des Problems. Eine Lösung ist aber nicht Sicht.
Ich habe mich mehrere Tage mit Ollama geärgert. Schade um die Zeit. (Laut Internet-Berichten gelten die hier beschriebenen Probleme auch für die gehypte Strix-Halo-CPU.)
Next Stop: llama.cpp
Etwas Internet-Recherche liefert den Tipp, anstelle von Ollama das zugrundeliegende Framework llama.cpp eben direkt zu verwenden. Ollama greift zwar selbst auf llama.cpp zurück, aber die direkte Verwendung von llama.cpp bietet andere GPU-Optionen. Dieser Low-Level-Ansatz ist vor allem bei der Modellauswahl etwas umständlicher. Zwei Vorteile können den Zusatzaufwand aber rechtfertigen:
Die neuste Version von llama.cpp unterstützt oft ganz neue Modelle, mit denen Ollama noch nicht zurechtkommt.
llama.cpp kann die GPU auf vielfältigere Weise nutzen als Ollama. Je nach Hardware und Treiber kann so eventuell eine höhere Geschwindigkeit erzielt bzw. der GPU-Speicher besser genutzt werden, um größere Modelle auszuführen.
Die GitHub-Projektseite beschreibt mehrere Installationsvarianten: Sie können llama.cpp selbst kompilieren, den Paketmanager nix verwenden, als Docker-Container ausführen oder fertige Binärpakete herunterladen (https://github.com/ggml-org/llama.cpp/releases). Ich habe den einfachsten Weg beschritten und mich für die letzte Option entschieden. Der Linux-Download enthält genau die llama.cpp-Variante, die für mich am interessantesten war — jene mit Vulkan-Unterstützung. (Vulkan ist eine 3D-Grafikbibliothek, die von den meisten GPU-Treibern unter Linux durch das Mesa-Projekt gut unterstützt wird.) Die Linux-Version von llama.cpp wird anscheinend unter Ubuntu kompiliert und getestet, dementsprechend heißt der Download-Name llama-<version>-bin-ubuntu-vulkan-x86.zip. Trotz dieser Ubuntu-Affinität ließen sich die Dateien bei meinen Tests aber problemlos unter Fedora 42 verwenden.
Nach dem Download packen Sie die ZIP-Datei aus. Die resultierenden Dateien landen im Unterverzeichnis build/bin. Es bleibt Ihnen überlassen, ob Sie die diversen llama-xxx-Kommandos direkt in diesem Verzeichnis ausführen, das Verzeichnis zu PATH hinzufügen oder seinen Inhalt in ein anderes Verzeichnis kopieren (z.B. nach /usr/local/bin).
cd Downloads
unzip llama-b6409-bin-ubuntu-vulkan-x64.zip
cd build/bin
./llama-cli --version

  loaded RPC backend from ./build/bin/libggml-rpc.so
  ggml_vulkan: Found 1 Vulkan devices:
  ggml_vulkan: 0 = AMD Radeon 780M Graphics (RADV PHOENIX) (radv) ...
  loaded Vulkan backend from ./build/bin/libggml-vulkan.so
  loaded CPU backend from ./build/bin/libggml-cpu-icelake.so
  version: 6409 (d413dca0)
  built with cc (Ubuntu 11.4.0-1ubuntu1~22.04.2) for x86_64-linux-gnu
Für die GPU-Unterstützung ist entscheidend, dass auf Ihrem Rechner die Bibliotheken für die 3D-Bibliothek Vulkan installiert sind. Davon überzeugen Sie sich am einfachsten mit vulkaninfo aus dem Paket vulkan-tools. Das Kommando liefert fast 4000 Zeilen Detailinformationen. Mit einem Blick in die ersten Zeilen stellen Sie fest, ob Ihre GPU unterstützt wird.
Um llama.cpp auszuprobieren, brauchen Sie ein Modell. Bereits für Ollama heruntergeladene Modelle sind leider ungeeignet. llama.cpp erwartet Modelle als GGUF-Dateien (GPT-Generated Unified Format). Um die Ergebnisse mit anderen Tools leicht vergleichen zu können, verwende ich als ersten Testkandidat immer Llama 3. Eine llama-taugliche GGUF-Variante von Llama 3.1 mit 8 Milliarden Parametern finden Sie auf der HuggingFace-Website unter dem Namen bartowski/Meta-Llama-3.1-8B-Instruct-GGUF:Q4_K_M.
Das folgende Kommando lädt das Modell von HuggingFace herunter (Option -hf), speichert es im Verzeichnis .cache/llama.cpp, lädt es, führt den als Parameter -p angegebenen Prompt aus und beendet die Ausführung dann. In diesem und allen weiteren Beispielen gehe ich davon aus, dass sich die llama-Kommandos in einem PATH-Verzeichnis befinden. Alle Ausgaben sind aus Platzgründen stark gekürzt.
llama-cli -hf bartowski/Meta-Llama-3.1-8B-Instruct-GGUF:Q4_K_M \
  -p 'bash/Linux: explain the usage of rsync over ssh'

  ... (diverse Debugging-Ausgaben)
  Running in interactive mode.
  - Press Ctrl+C to interject at any time.
  - Press Return to return control to the AI.
  - To return control without starting a new line, end your input with '/'.
  - If you want to submit another line, end your input with '\'.
  - Not using system message. To change it, set a different value via -sys PROMPT

> bash/Linux: explain the usage of rsync over ssh

  rsync is a powerful command-line utility that enables you to
  synchronize files and directories between two locations. Here's
  a breakdown of how to use rsync over ssh: ...

> <Strg>+<D>

         load time =  2231.02 ms
  prompt eval time =   922.83 ms /  43 tokens (46.60 tokens per second)
         eval time = 31458.46 ms / 525 runs   (16.69 tokens per second)
Sie können llama-cli mit diversen Optionen beeinflussen, z.B. um verschiedene Rechenparameter einzustellen, die Länge der Antwort zu limitieren, den Systemprompt zu verändern usw. Eine Referenz gibt llama-cli --help. Deutlich lesefreundlicher ist die folgende Seite:
Mit llama-bench können Sie diverse Benchmark-Tests durchführen. Im einfachsten Fall übergeben Sie nur das Modell in der HuggingFace-Notation — dann ermittelt das Kommando die Token-Geschwindigkeit für das Einlesen des Prompts (Prompt Processing = pp) und die Generierung der Antwort (Token Generation = tg). Allerdings kennt llama-bench die Option -hf nicht; vielmehr müssen Sie mit -m den Pfad zur Modelldatei übergeben:
llama-bench -m ~/.cache/llama.cpp/bartowski_Meta-Llama-3.1-8B-Instruct-GGUF_Meta-Llama-3.1-8B-Instruct-Q4_K_M.gguf

  model                         size     test   token/s (Tabelle gekürzt ...)
  -----------------------  ---------  -------  --------
  llama 8B Q4_K - Medium    4.58 GiB    pp512    204.03
  llama 8B Q4_K - Medium    4.58 GiB    tg128     17.04
Auf meinem Rechner erreicht llama.cpp mit Vulkan nahezu eine identische Token-Rate wie Ollama mit ROCm (aber ohne die vielen Nachteile dieser AMD-Bibliothek).
AMD-Optimierung
Bei meinen Tests auf dem schon erwähnten Mini-PC mit AMD 8745H-CPU mit der iGPU 780M und 32 GiB RAM funktionierte llama.cpp mit Vulkan viel unkomplizierter als Ollama mit ROCm. Ich habe die VRAM-Zuordnung der GPU wieder zurück auf den Defaultwert von 2 GiB gestellt. Per Default steht llama.cpp auf meinem Rechner dann ca. der halbe Arbeitsspeicher (2 GiB VRAM plus ca. 14 GiB GTT) zur Verfügung. Vulkan kann diesen Speicher ohne merkwürdige Hacks mit Umgebungsvariablen korrekt allozieren. Das reicht ohne jedes Tuning zur Ausführung des Modells gpt-20b aus (siehe den folgenden Abschnitt). So soll es sein!
Wenn Sie noch mehr Speicher für die LLM-Ausführung reservieren wollen, müssen Sie die Kerneloptionen pages_limit und pages_pool_size des AMDGPU-Treibers verändern. Wenn Sie 20 GiB GGT-Speicher nutzen wollen, müssen Sie für beide Optionen den Wert 5242880 angeben (Anzahl der 4-kByte-Blöcke):
Danach aktualisieren Sie die Initrd-Dateien und führen einen Neustart durch:
sudo update-initramfs -u                   # Debian und Ubuntu
sudo dracut --regenerate-all --force       # Fedora, RHEL, SUSE

sudo reboot

sudo dmesg | grep "amdgpu.*memory"

  amdgpu: 2048M of VRAM memory ready   (<-- laut BIOS-Einstellung)
  amdgpu: 20480M of GTT memory ready   (<-- laut /etc/modprobe.d/amd.conf)
Modellauswahl
Mit llama.cpp können Sie grundsätzlich jedes Modell im GPT-Generated Unified Format (GGUF) ausführen. Auf der Website von HuggingFace stehen Tausende Modelle zur Wahl:
Die Herausforderung besteht darin, für die eigenen Zwecke relevante Modelle zu finden. Generell ist es eine gute Idee, besonders populäre Modelle vorzuziehen. Außerdem werden Sie rasch feststellen, welche Modellgrößen für Ihre Hardware passen. Die höhere Qualität großer Modelle bringt nichts, wenn die Geschwindigkeit gegen Null sinkt.
gpt-oss-20b
Eine llama.cpp-kompatible Version finden hat ggml-org auf HuggingFace gespeichert. Sofern ca. 15 GiB freier VRAM zur Verfügung stehen (unter AMD: VRAM + GTT), führt llama.cpp das Modell problemlos und beachtlich schnell aus. Beachten Sie, dass es sich hier um ein »Reasoning-Modell« handelt, das zuerst über das Problem nachdenkt und diesen Denkprozess auch darstellt. Danach wird daraus das deutlich kompaktere Ergebnis präsentiert.
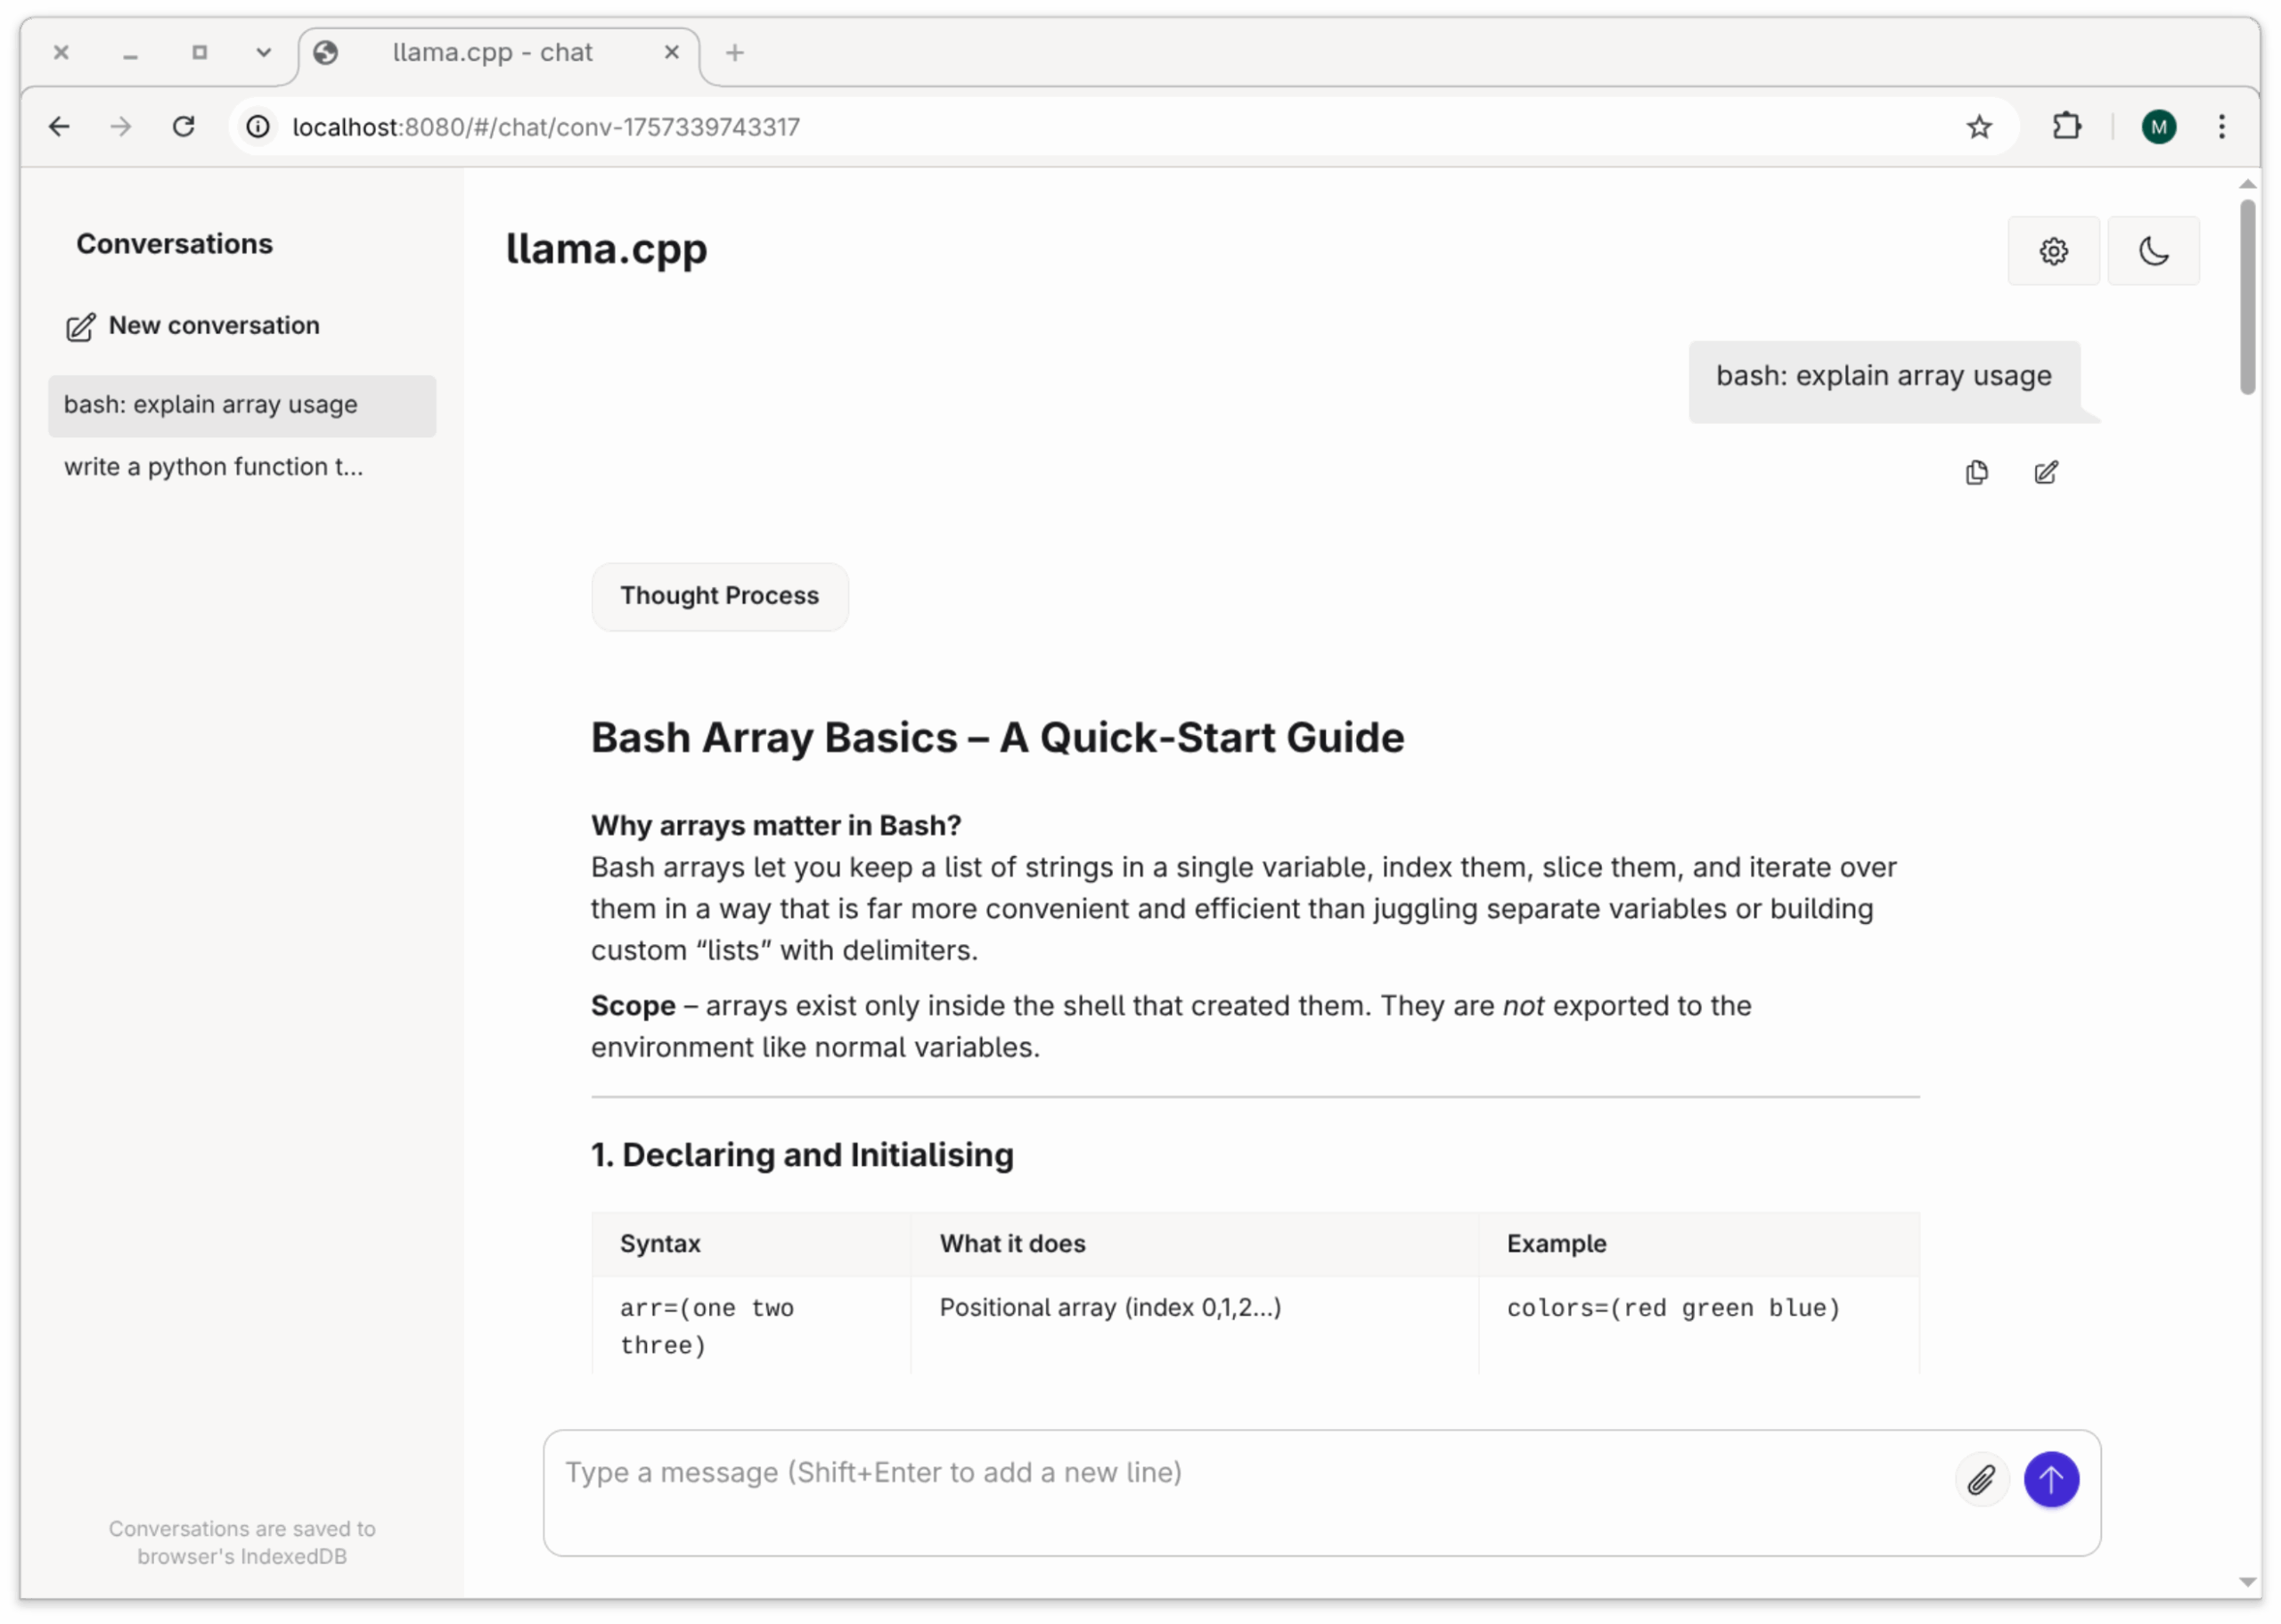
Die Kommandos llama-cli und llama-bench dienen in erster Linie zum Testen und Debuggen. Sobald Sie sich einmal überzeugt haben, dass llama.cpp grundsätzlich funktioniert, werden Sie das Programm vermutlich im Server-Betrieb einsetzen. Das entsprechende Kommando lautet llama-server und ist grundsätzlich wie llama-cli aufzurufen. Falls Sie llama-server unter einem anderen Account als llama-cli aufrufen, aber schon heruntergeladene Modelle weiterverwenden wollen, übergeben Sie deren Pfad mit der Option -m:
llama-server -c 0 -fa on --jinja -m /home/kofler/.cache/llama.cpp/ggml-org_gpt-oss-20b-GGUF_gpt-oss-20b-mxfp4.gguf
Sie können nun unter http://localhost:8080 auf einen Webserver zugreifen und das gestartete Modell komfortabel bedienen. Im Unterschied zu Ollama hält llama.cpp das Modell dauerhaft im Arbeitsspeicher. Das Modell kann immer nur eine Anfrage beantworten. Die Verarbeitung mehrere paralleler Prompts erlaubt --parallel <n>.
Die Web-Oberfläche von llama-server
Es ist unmöglich, mit einem Server mehrere Modelle parallel anzubieten. Vielmehr müssen Sie mehrere Instanzen von llama-server ausführen und jedem Dienst mit --port 8081, --port 8082 usw. eine eigene Port-Nummer zuweisen. (Das setzt voraus, dass Sie genug Video-Speicher für alle Modelle zugleich haben!)
Falls auch andere Rechner Server-Zugang erhalten sollen, übergeben Sie mit --host einen Hostnamen oder eine IP-Nummer im lokalen Netzwerk. Mit --api-key oder --api-key-file können Sie den Server-Zugang mit einem Schlüssel absichern. Mehr Details zu den genannten Optionen sowie eine schier endlose Auflistung weiterer Optionen finden Sie hier:
Jetzt habe ich drei Tage versucht, gpt-oss per GPU auszuführen. Hat sich das gelohnt? Na ja. Mit -ngl 0 kann die Token Generation (also das Erzeugen der Antwort per Sprachmodell) von der GPU auf die CPU verlagert werden. Das ist natürlich langsamer — aber erstaunlicherweise nur um 25%.
Warum ist der Unterschied nicht größer? Weil die 780M keine besonders mächtige GPU ist und weil die Speicherbandbreite der iGPU viel kleiner ist als bei einer dezidierten GPU mit »echtem« VRAM.
Zur Einordnung noch zwei Vergleichszahlen: MacBook Pro M3: 42 Token/s (mit GPU) versus 39 Token/s (nur CPU)
Seit vielen Jahren verwende ich Let’s Encrypt-Zertifikate für meine Webserver. Zum Ausstellen der Zertifikate habe ich in den Anfangszeiten das Kommando certbot genutzt. Weil die Installation dieses Python-Scripts aber oft Probleme bereitete, bin ich schon vor vielen Jahren auf das Shell-Script acme.sh umgestiegen (siehe https://github.com/acmesh-official/acme.sh).
Kürzlich bin ich auf einen Sonderfall gestoßen, bei dem acme.sh nicht auf Anhieb funktioniert. Die Kurzfassung: Ich verwende Apache als Proxy für eine REST-API, die in einem Docker-Container läuft. Bei der Zertifikatausstellung/-erneuerung ist Apache (der auf dem Rechner auch als regulärer Webserver läuft) im Weg; die REST-API liefert wiederum keine statischen Dateien aus. Die Domain-Verifizierung scheitert. Abhilfe schafft eine etwas umständliche Apache-Konfiguration.
Ausgangspunkt
Ausgangspunkt ist also ein »gewöhnlicher« Apache-Webserver. Dieser soll nun zusätzlich eine REST-API ausliefern, die in einem Docker-Container läuft (localhost:8880). Die erste Konfiguration sah ziemlich simpel aus:
Das Problem besteht darin, dass acme.sh zwar diverse Domain-Verifizierungsverfahren kennt, aber keines so richtig zu meiner Konfiguration passt:
acme.sh ... --webroot scheitert, weil die API eine reine API ist und keine statischen Dateien ausliefert.
acme.sh ... --standalone scheitert, weil der bereits laufende Webserver Port 80 blockiert.
acme.sh ... --apache scheitert mit could not resolve api.example.com.well-known.
Die Lösung
Die Lösung besteht darin, die Apache-Proxy-Konfiguration dahingehend zu ändern, dass zusätzlich in einem Verzeichnis statische Dateien ausgeliefert werden dürfen. Dazu habe ich das neue Verzeichnis /var/www/acme-challenge eingerichtet:
Danach habe ich die Konfigurationsdatei für Apache umgebaut, so dass Anfragen an api.example.com/.well-known/acme-challenge mit statischen Dateien aus dem Verzeichnis /var/www/acme-challenge/.well-known/acme-challenge bedient werden:
# Apache-Konfiguration wie bisher
<VirtualHost *:443>
    ServerName api.example.com

    # SSL
    SSLEngine on
    SSLCertificateFile    /etc/acme-letsencrypt/api.example.com.pem
    SSLCertificateKeyFile /etc/acme-letsencrypt/api.example.com.key

    # Proxy: localhost:8880 <-> api.example.com
    ProxyPreserveHost On
    ProxyPass         / http://localhost:8880/
    ProxyPassReverse  / http://localhost:8880/

    # Logging Konfiguration ...
</VirtualHost>

# geändert: HTTP auf HTTPS umleiten, aber nicht
# für well-known-Verzeichnis
<VirtualHost *:80>
    ServerName api.example.com

    # Handle ACME challenges locally
    Alias /.well-known/acme-challenge /var/www/acme-challenge/.well-known/acme-challenge
    <Directory /var/www/acme-challenge/.well-known/acme-challenge>
        Require all granted
    </Directory>

    # Redirect everything EXCEPT ACME challenges to HTTPS
    RewriteEngine On
    RewriteCond %{REQUEST_URI} !^/.well-known/acme-challenge/
    RewriteRule ^(.*)$ https://api.example.com$1 [R=301,L]
</VirtualHost>
Nach diesen Vorbereitungsarbeiten und mit systemctl reload apache2 gelingt nun endlich das Zertifikaterstellen und -erneuern mit dem --webroot-Verfahren. Dabei richtet acme.sh vorübergehend die Datei /var/www/acme-challenge/.well-known/acme-challenge/xxx ein und testet dann via HTTP (Port 80), ob die Datei gelesen werden kann.
Eine noch elegantere Lösung besteht darin, den Docker-Container mit Traefik zu kombinieren (siehe https://traefik.io/traefik/). Bei korrekter Konfiguration kümmert sich Traefik um alles, nicht nur um die Proxy-Funktionen sondern sogar um das Zertifikatsmanagment. Aber diese Lösung kommt nur in Frage, wenn auf dem Host nicht schon (wie in meinem Fall) ein Webserver läuft, der die Ports 80 und 443 blockiert.
Rund um die Integration von KI-Tools in Xcode hat sich Apple bisher nicht mit Ruhm bekleckert (siehe auch meinen Blog-Artikel zu Xcode 26.1 und 26.2). Aber mit Version 26.3 ist Xcode endlich doch im KI-Zeitalter angekommen. Der Schlüssel zum Erfolg: die Einhaltung offener Standards.
KI funktioniert in Xcode 26.3, weil Apple mit mcpbridge einen MCP-Server mit ca. 20 Tools für Xcode implementiert hat. Damit können Sprachmodelle direkt mit Xcode kommunizieren, Code ändern, auf aktuelle Apple-spezifische Dokumentation zugreifen, Apps ausprobieren und Fehler beheben.
KI-unterstützte App-Entwicklung in Xcode
Konfiguration
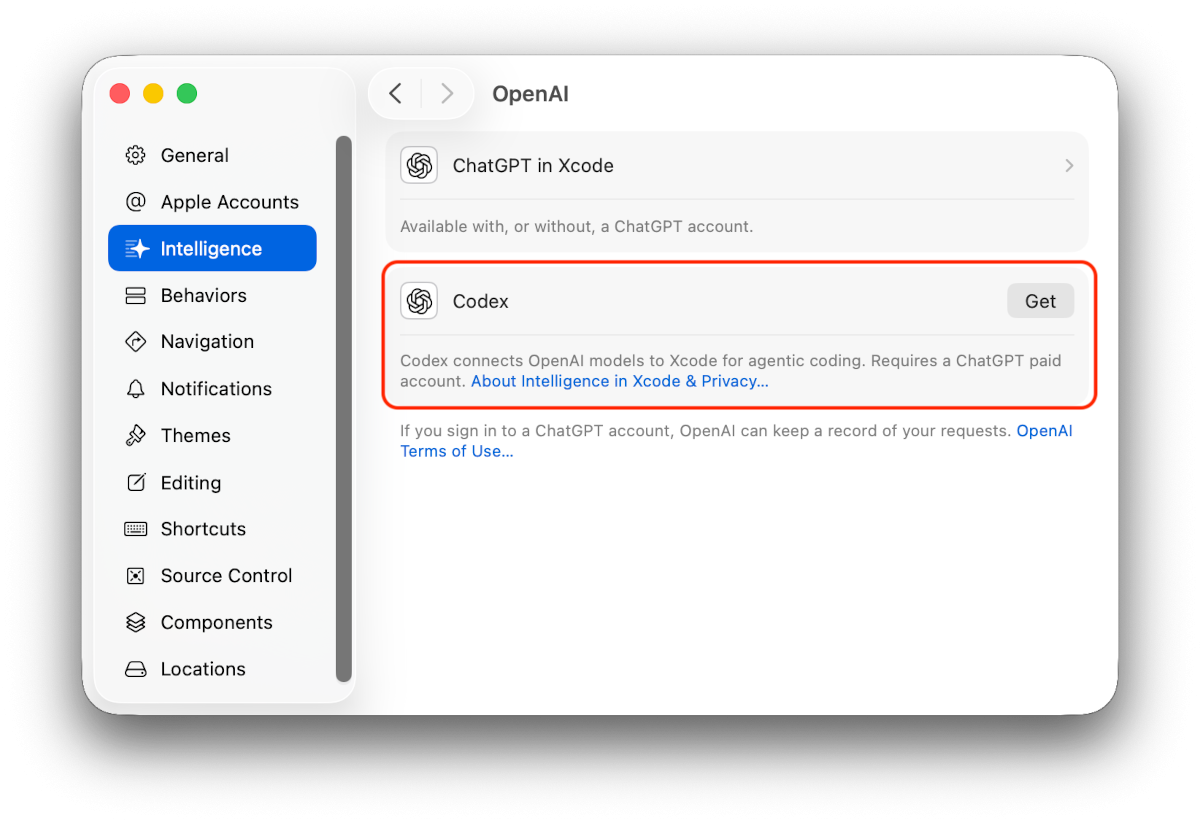
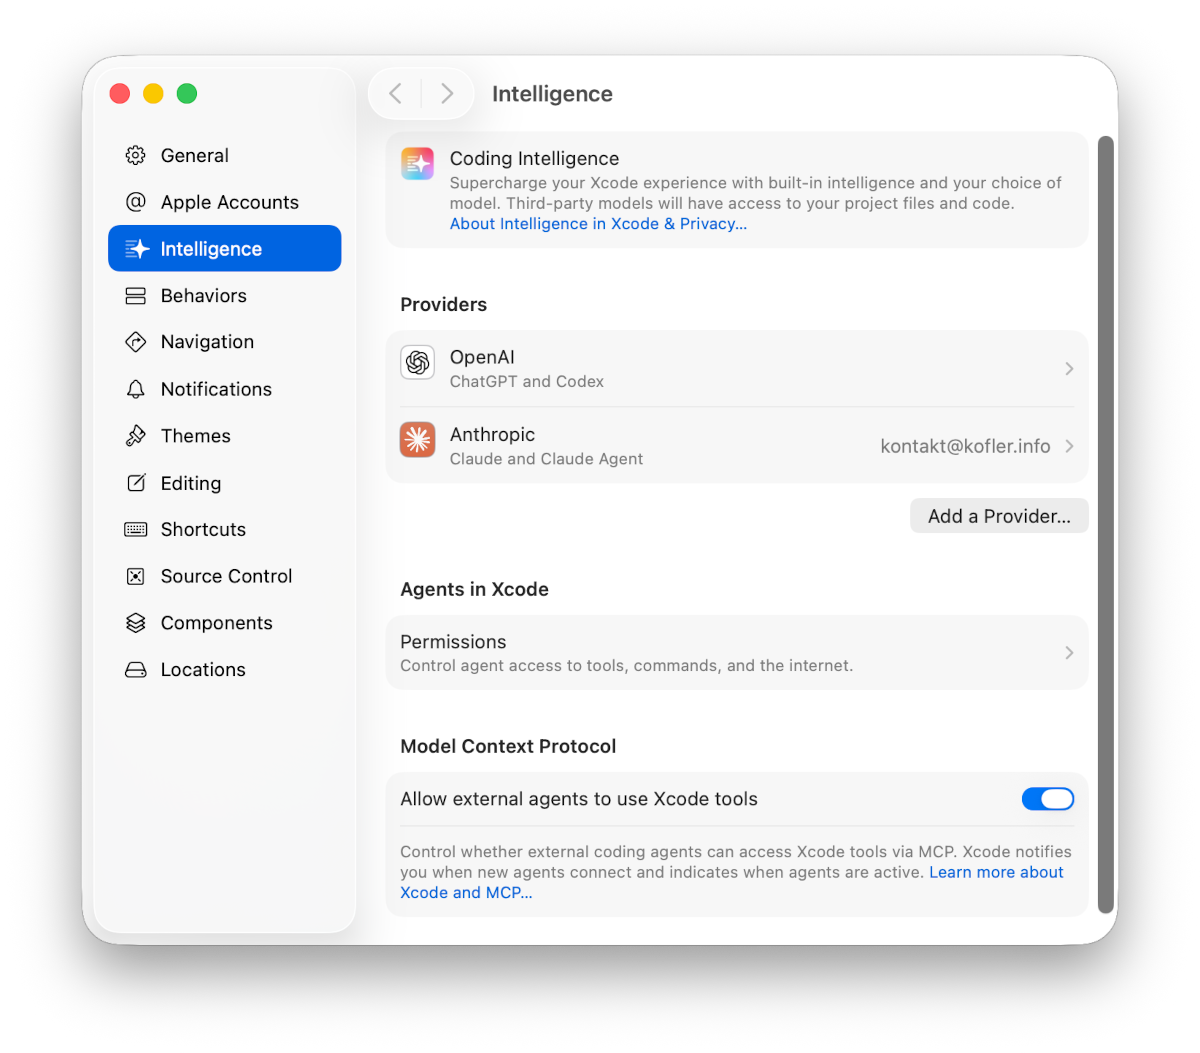
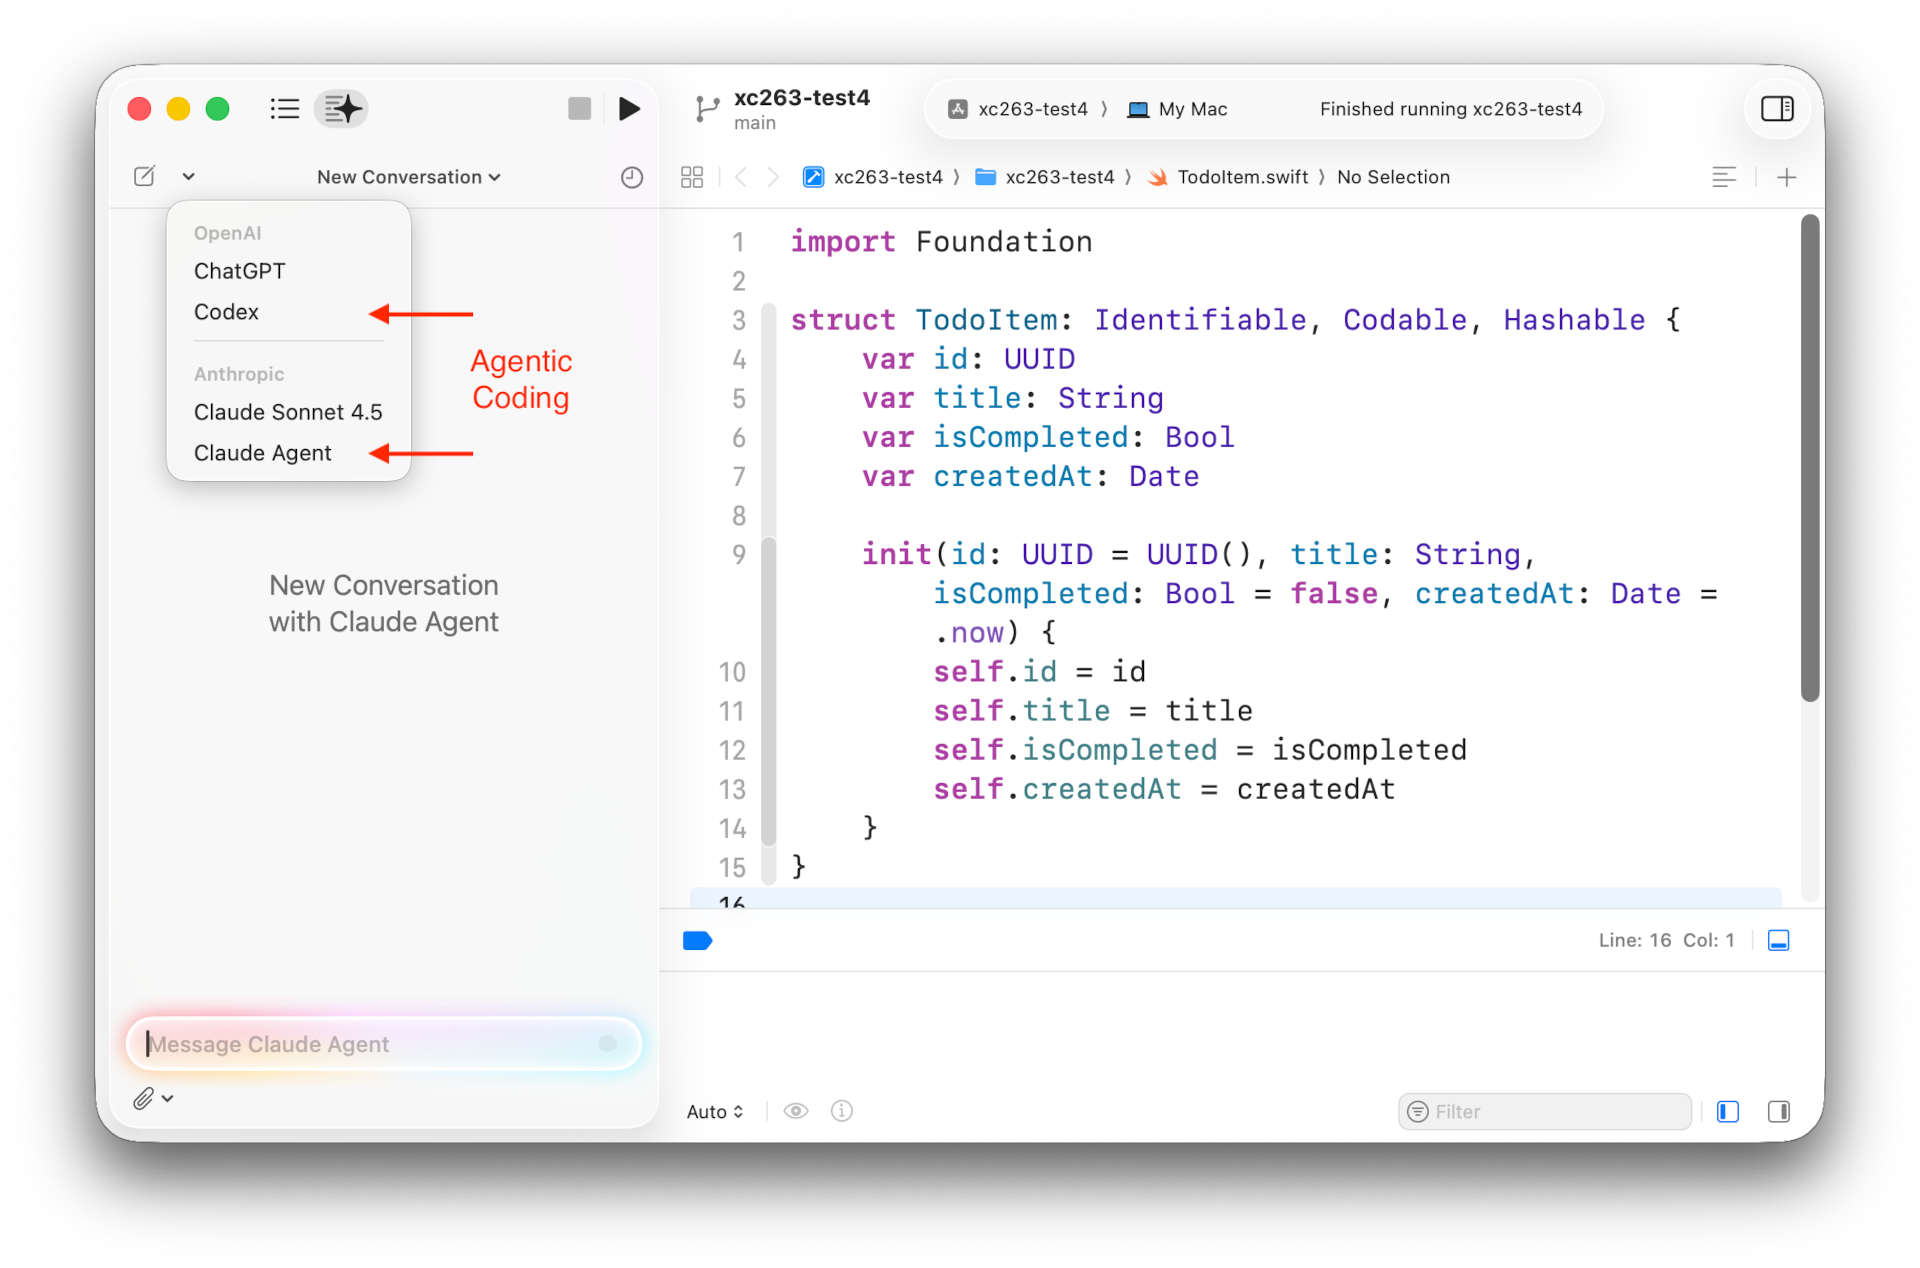
Der Konfigurationsdialog Intelligence sieht simpel aus, stiftet in Wirklichkeit aber Verwirrung. Auf den ersten Blick könnte man meinen, es gäbe zwei vordefinierte KI-Provider: OpenAI mit ChatGPT und Codex auf der einen Seite, Anthropic mit Claude auf der anderen Seite. Es sind aber VIER!
ChatGPT: simple KI-Unterstützung, in begrenztem Ausmaß kostenlos
OpenAI Codex: Agentic Coding mit Codex
Claude: simple KI-Unterstützung
Claude Agent: Agentic Coding mit Claude (vergleichbar mit der CLI Claude Code)
Ich gehe im Folgenden davon aus, dass Sie ein ChatGPT- oder Claude-Abo haben und dieses für Xcode nutzen möchten. Dazu installieren Sie zuerst das entsprechende Zusatzprogramm OpenAI Codex bzw. Claude Agent (Button Get). Ärgerlicherweise scheint die KI-Integration auch ohne diese Zusatzinstallation zu funktionieren — aber dann landen Sie bei den eingeschränkten Varianten ChatGPT oder Claude, die nur mittelmäßig funktionieren, keine Skill-Unterstützung aufweisen usw.
Für Agentic Coding müssen die Zusatzkomponenten »Codex« bzw. »Claude Agent« installiert werden!
Im nächsten Schritt müssen Sie die Verbindung zum jeweiligen KI-Konto herstellen. Die Authentifizierung erfolgt in einem Webbrowser-Fenster. Die konfigurierten KI-Tools bekommen automatisch Zugang zu den MCP-Diensten von Xcode.
KI-Konfiguration in Xcode
Es besteht auch die Möglichkeit, andere externe sowie lokale KI-Provider zu nutzen. Am interessantesten wäre sicherlich Google Gemini, aber ich habe aus Zeitgründen von Tests abgesehen. (Freie, lokale Modelle sind nach meinen Erfahrungen mit anderen IDEs eher ungeeignet. Sie sind für Agentic Coding nicht leistungsfähig genug. Außerdem basieren sie meist auf relativ altem Trainingsmaterial, was bei Swift/SwiftUI besonders ungünstig ist.)
Die Option Allow external agents to use Xcode tools ist nur dann relevant, wenn Sie ein externes (nicht in Xcode eingebettetes) KI-Tool verwenden, z.B. Claude Code oder Codex. Diese externen Tools können dann den in Xcode integrierten MCP-Server nutzen und z.B. Apps ausführen, davon Screenshots erstellen und auf diese Weise UI-Fehler erkennen/beheben.
In der KI-Seitenleiste wählen Sie den gewünschten, zuvor konfigurierten KI-Dienst aus. Alle Agentic Coding Funktionen gibt es aber nur mit Codex oder Claude Agent!
Auswahl zwischen den vorweg konfigurierten Diensten in der KI-Seitenleiste. Agentic Coding setzt »Codex« oder »Claude Agent« voraus!
Erster Versuch (ChatGPT)
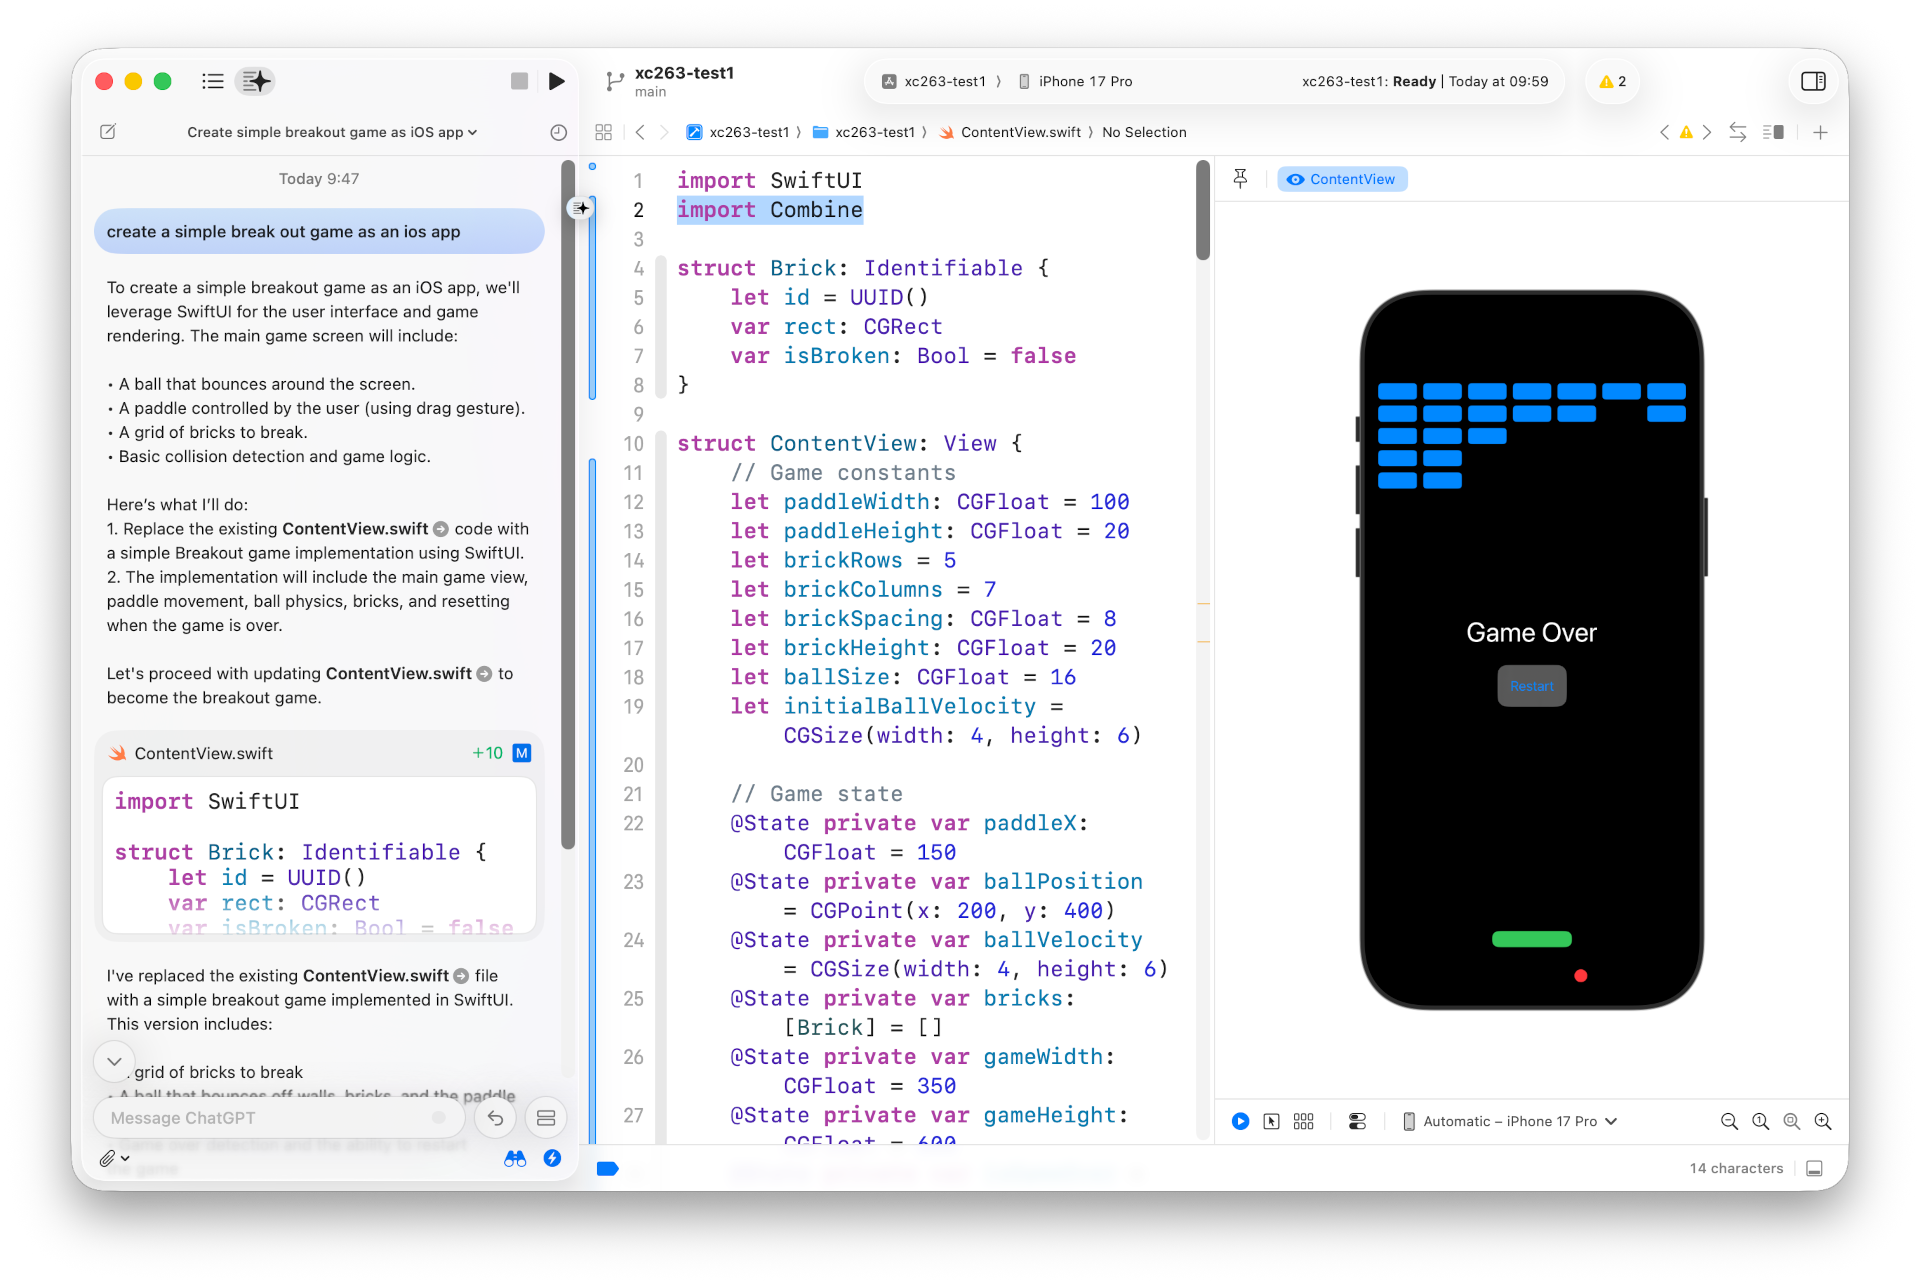
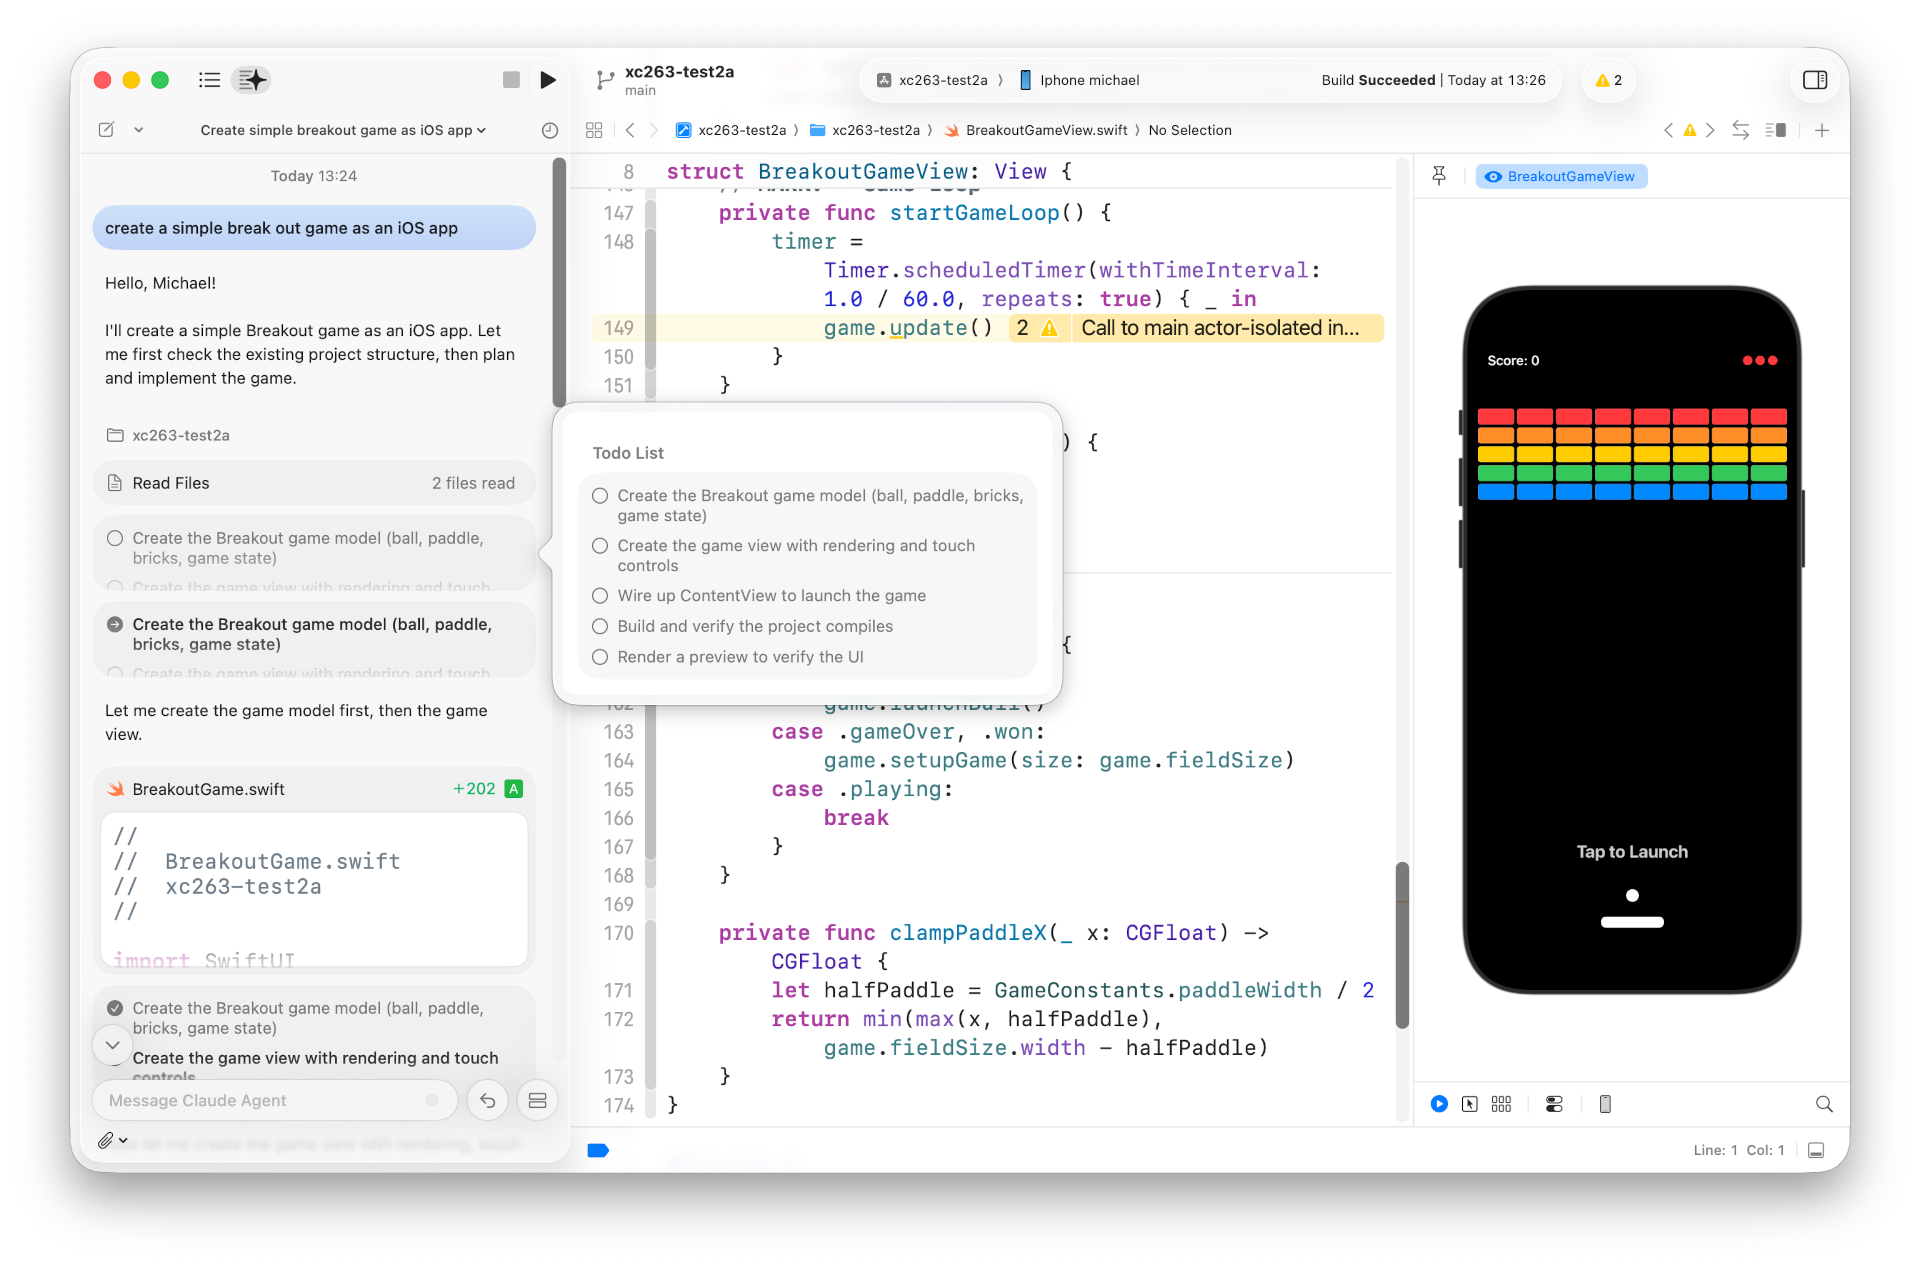
Als ersten Versuch habe ich mit dem Modell ChatGPT (ohne OpenAI-Konto) eine minimale Variante des Break-Out-Spiels als iOS-App entwickelt (siehe die erste Abbildung dieses Artikels).
Prompt: create a simple break out game as an iOS app
Zwei Minuten später war die App fertig. 170 Zeilen Code, alle in ContentView.swift. Xcode zeigte allerdings einen Build-Error an und wies auch gleich auf die Ursache hin: Es fehlte import Combine, worum ich mich selbst kümmerte. Danach war die App prinzipiell verwendbar.
Einerseits ist das Ergebnis beeindruckend, andererseits ist die Code-Qualität aber nicht großartig: Xcode bemängelte zwei onChange-Aufrufe, deren Syntax veraltet ist. Aber auch davon losgelöst ist der Code nicht effizient. Die Spielelemente sind alle in SwiftUI abgebildet (kein SpriteKit). Das ist die einfachste Lösung, aber die Implementierung ist langsam. Das Spiel wird stotternd langsam, sobald das Paddel mit der Maus verschoben wird.
Ich habe mit ein paar Folge-Prompts versucht, das Spiel zu verbessern:
Prompt: the onChange() modifiers are deprecated; please fix
Prompt: ok. it works, but it is extremely slow if I move the paddle. (As long as there is no user input, speed is OK)
Das KI-Tool ersetzte zuerst onChange durch task (OK) und baute dann @GestureState ein, um die Geschwindigkeit zu verbessern (ohne Erfolg).
Zweiter Versuch (Claude Agent)
Für den zweiten Versuch habe ich zuerst den Claude Agent heruntergeladen und mit meinem Claude-Konto verknüpft. Gleicher Prompt, also:
Prompt: create a simple break out game as an iOS app
Der erste Unterschied zum vorigen Beispiel besteht darin, dass der Claude Agent über das Problem zuerst nachdenkt und eine To-do-Liste erstellt. Diese arbeitete er dann Punkt für Punkt ab.
Der Code fällt mit ca. 350 Zeilen deutlich umfangreicher aus. Er ist in den beiden neuen Dateien BreakOutGame.swift und BreakOutGameView.swift deutlich besser organisiert. Der Code trennt zwischen Datenmodell und View. (Auf eine vollständige Realisierung des MVVM-Musters hat der Claude Agent aber verzichtet.) Der Code funktioniert auf Anhieb und ist frei von offensichtlich veralteten Funktionen. Auch die Performance ist deutlich besser.
Noch ein Break-Out-Spiel, diesmal generiert vom Claude Agent
Xcode kritisiert allerdings zwei Main-actor-Isolation-Probleme (Warnungen, keine Errors).
Prompt: there are two main actor isolation warnings; fix them
Claude gelingt es auf Anhieb, die Probleme zu beheben (Respekt!).
Eine weitere Analyse des Codes ergibt: Der Code ist OK, aber nicht ausgezeichnet. Der SwiftUI-Pro-Skill (mehr dazu in einem zweiten Blog-Artikel) kritisiert z.B. die Verwendung eines Timers für den GameLoop und schlägt stattdessen TimeLineView(.animation) vor.
Beispiel 3: Vorhandenen Code bearbeiten/erweitern (Claude Agent)
Im dritten Beispiel habe ich das einigermaßen komplexe Cart-Projekt aus meinem Swift-Buch geladen (siehe Kapitel 25). In ca. 2000 Zeilen Code, die über ein Dutzend Dateien verteilt sind, realisiert die App die Verwaltung einer Einkaufsliste, die mittels eines Backends (REST-API) über mehrere Familienmitglieder synchronisiert wird.
Mein erster Prompt sah so aus:
Prompt: /init
Dieses Claude-Code-typische Kommando analysiert die Code-Basis und erstellt die Datei CLAUDE.md mit einer Zusammenfassung über die Organisation des Codes. Damit tut sich der Claude Agent bei weiteren Aufrufen leichter, sich im Code zu orientieren, und muss diesen Schritt nicht wiederholen. Die Datei landet direkt im Projektverzeichnis und ist deswegen im Projektnavigator (der eine Ebene tiefer ansetzt) unsichtbar.
Der Claude Agent lädt diese Datei bei zukünftigen Sessions automatisch. In der Regel ist es zweckmäßig, die Datei durchzulesen und bei Bedarf eigene Erweiterungen durchzuführen. Ich habe bei diesem Test aber darauf verzichtet.
Als Nächstes habe ich in den Projekteinstellungen Default Actor Isolation = MainActor eingestellt (siehe auch den Blog-Artikel Swift 6.2 und Xcode 26.1).
Prompt: This app now uses Default Actor Isolation = MainActor. Remove no longer necessary main actor attributes.
Es gibt nur eine Stelle im Code. Claude Agent findet sie und entfernt das nun überflüssige Attribut.
In der Praxis haben sich die Synchronisationseinstellungen der App als zu groß herausgestellt. Die App speichert Änderungen alle 40 Sekunden. Wenn lokal nichts geändert wird, werden Remote-Änderungen sogar nur alle 10 Minuten durchgeführt. Der folgende Prompt führt direkt zum Ziel, obwohl ich Claude keinerlei Informationen gebe, wo sich die relevanten Einstellungen befinden.
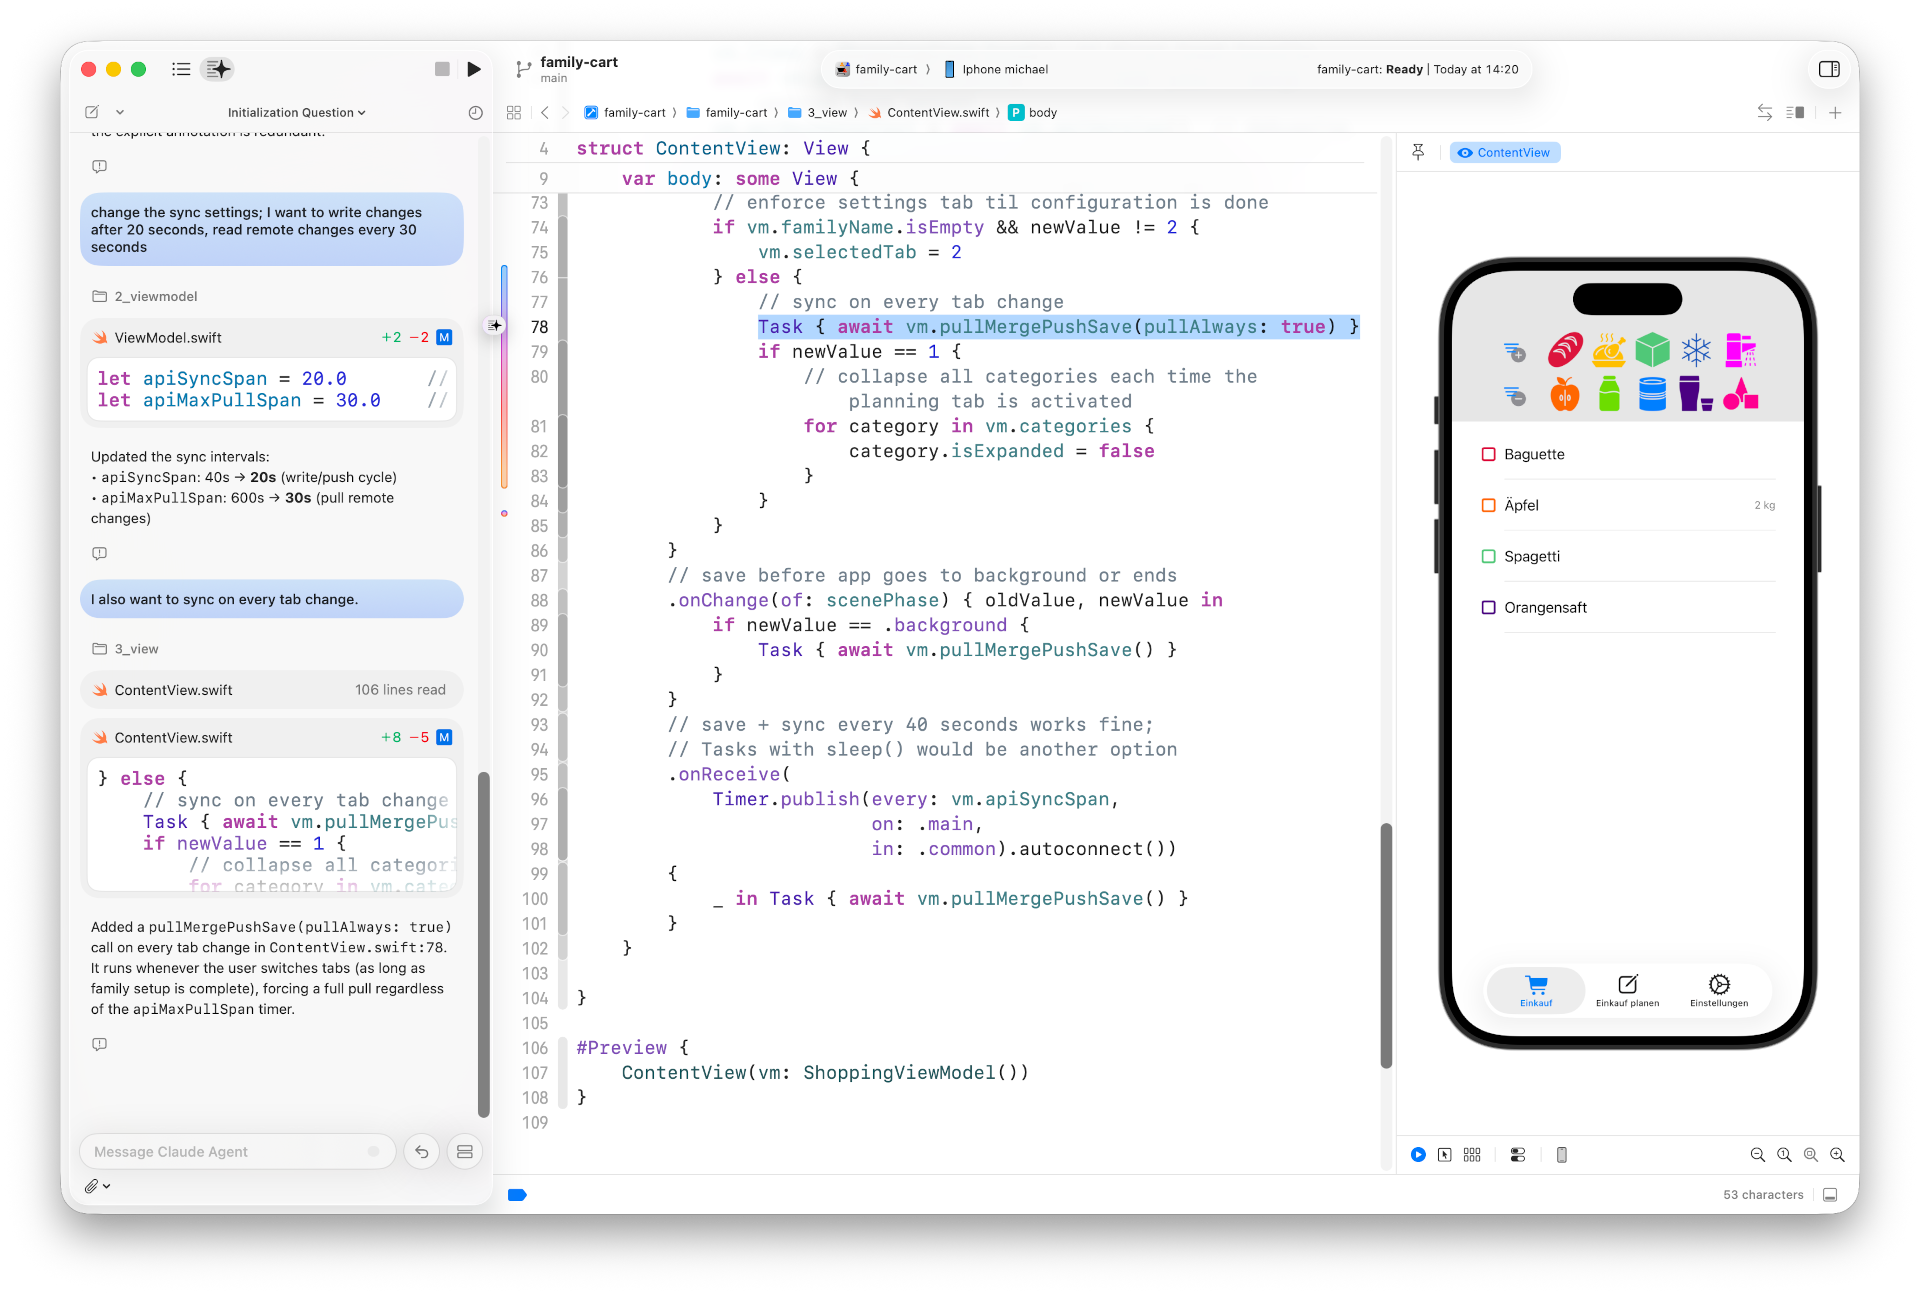
Prompt: change the sync settings; I want to write changes after 20 seconds, read remote changes every 30 seconds
Die UI der App ist in einer TabView über drei Tabs verteilt. Ich möchte, dass die App auch bei jedem Tab-Wechsel eine Synchronisation durchführt. Wiederum findet der Claude Agent sofort die richtige Stelle im Code und baut dort einen asynchronen Aufruf der Sync-Methode ein.
Prompt: I also want to sync on every tab change.
Claude Agent führt mühelos Änderungen in dem einigermaßen komplexen Projekt durch
Prompt: I want the app to also sync when it is disabled (switch to another app). There is already code for this, but it does not work reliable.
Claude Agent verbessert den Code entsprechend.
Prompt: update the version to 1.0.2
Prompt: ok. can you also update it in the target settings?
Hier kommt Claude an seine Grenzen. Er findet zwar eine Zeichenkette im Code, die er von 1.0.1 auf 1.0.2 ändert. Aber die Xcode-Einstellungen Target / Identity / Bundle Identifier kann es nicht ändern und bittet darum, diesen Schritt selbst zu erledigen.
Meine relativ einfachen Prompts verschleiern, wie weit Agentic Coding geht. Paul Hudson geht in seinem YouTube-Video aufs Ganze und beginnt mit einem Prompt, um eine Schach-Spiel-App zu programmieren. Eine viertel Stunde später ist die App soweit fertig, dass ein erstes Spiel möglich ist. Derartige Mammut-Prompts sind aber selten zweckmäßig. Gehen Sie Schritt für Schritt vor (wobei ein Schritt durchaus die Implementierung eines neuen Features sein kann), testen Sie die App, führen Sie einen Commit durch!
Xcode vs. Claude Code
Apple hat sich mit der Integration von KI-Tools in Xcode viel Zeit gelassen. Außerhalb des Apple-Universums hat sich mehr bewegt. Der aus meiner Sicht gerade spannendste Weg zur Programmierung von Swift-Apps ist heute das Command Line Interface (CLI) Claude Code.
Die Vorgehensweise sieht so aus: Sie erzeugen/laden mit Xcode Ihr Projekt. Gleichzeitig öffnen Sie ein Terminal, wechseln in das Projektverzeichnis und starten dort Claude Code. Durch Prompts weisen Sie Claude Code an, welche Funktionen es entwickeln soll. Xcode bleibt offen, Sie verwenden die IDE aber nicht (oder nur in Ausnahmefällen) zum Programmieren, sondern dazu, den von Claude Code produzierten Code zu lesen und die resultierende App zu testen bzw. auszuprobieren.
Diese Vorgehensweise ist ungewohnt, aber effizient. Manche Entwickler sind der Ansicht, der größte Vorteil moderner KI-Tools bestünde darin, dass Xcode nicht oder zumindest nur noch am Rande benötigt wird.
Im Vergleich zu den integrierten KI-Tools in Xcode bietet Claude Code diverse Zusatzfunktionen. Enorm hilfreich ist die Möglichkeit, Skills und MCP-Server zu nutzen. Das für mich wichtigste Feature ist aber der Planungsmodus (Ein-/Ausschalten mit Shift+Tab): Er gibt Ihnen die Möglichkeit, ein neues Feature in Ruhe zu planen, ohne den Code dabei anzurühren. Erst wenn Sie mit dem von Claude Code präsentiertem Plan vollständig zufrieden sind, beginnen Sie mit der Realisierung.
Erfreulicherweise unterstützt Xcode ab Version 26.3 auch externe KI-Tools und stellt diesen via MCP dieselben Funktionen wie internen KI-Tools zur Verfügung. Dazu müssen Sie in den Xcode-Einstellungen Intelligence / Allow external agents to use Xcode tools aktivieren. Die Kommandos, um den Xcode-Server in Claude Code bzw. in Codex einmalig einzurichten, sehen so aus (Dokumentation von Apple):
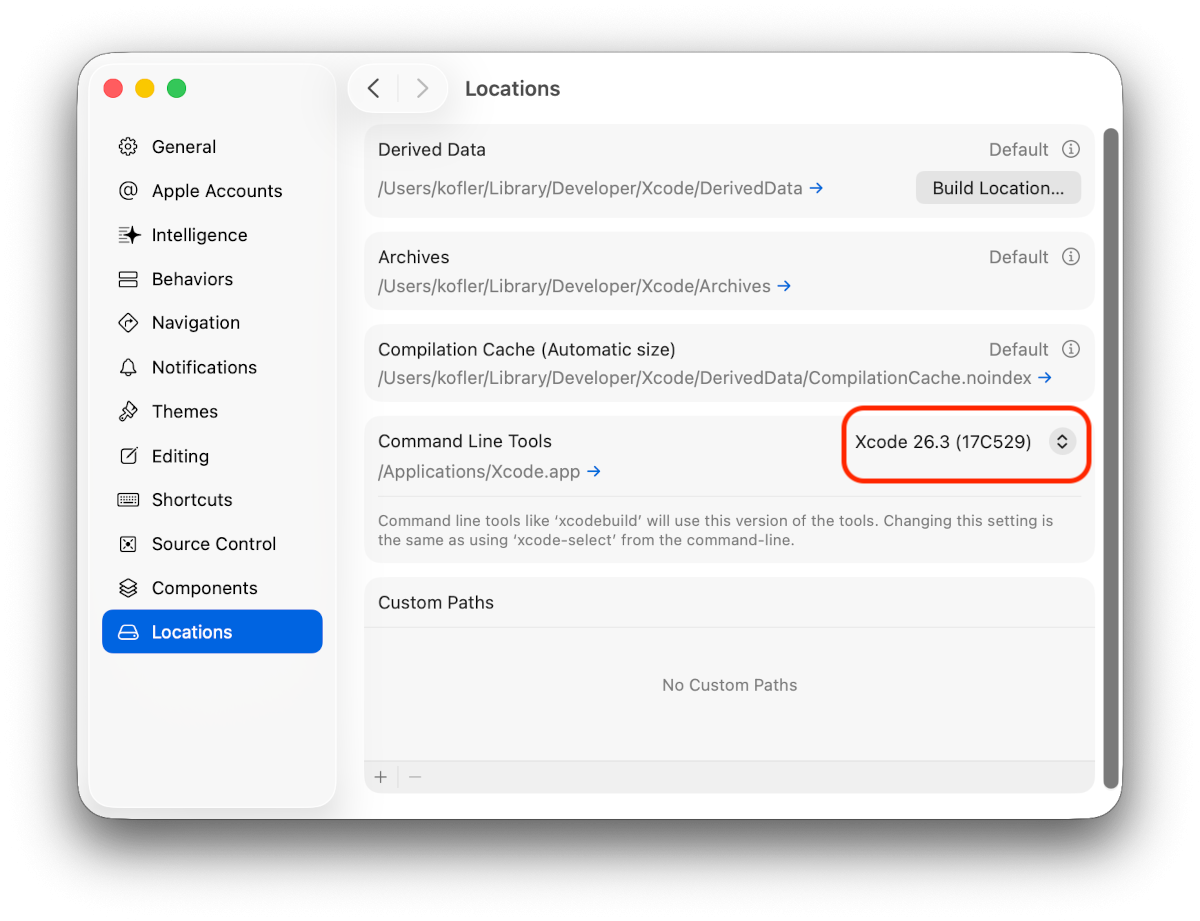
Damit der Aufruf von mcpbridge funktioniert, muss in den Xcode-Einstellungen unter Locations die richtige Xcode-Version eingestellt sein. Bei mir war der Eintrag ursprünglich leer (keine Ahnung warum), der MCP-Aufruf scheiterte deswegen.
Achten Sie auf die richtige Einstellung der Option »Command Line Tools«!
Wenn Claude Code oder ein anderes externes KI-Tool MCP-Funktionen nutzen will, müssen Sie das vorher bewilligen.
Bestätigung des MCP-Verbindungsaufbaus
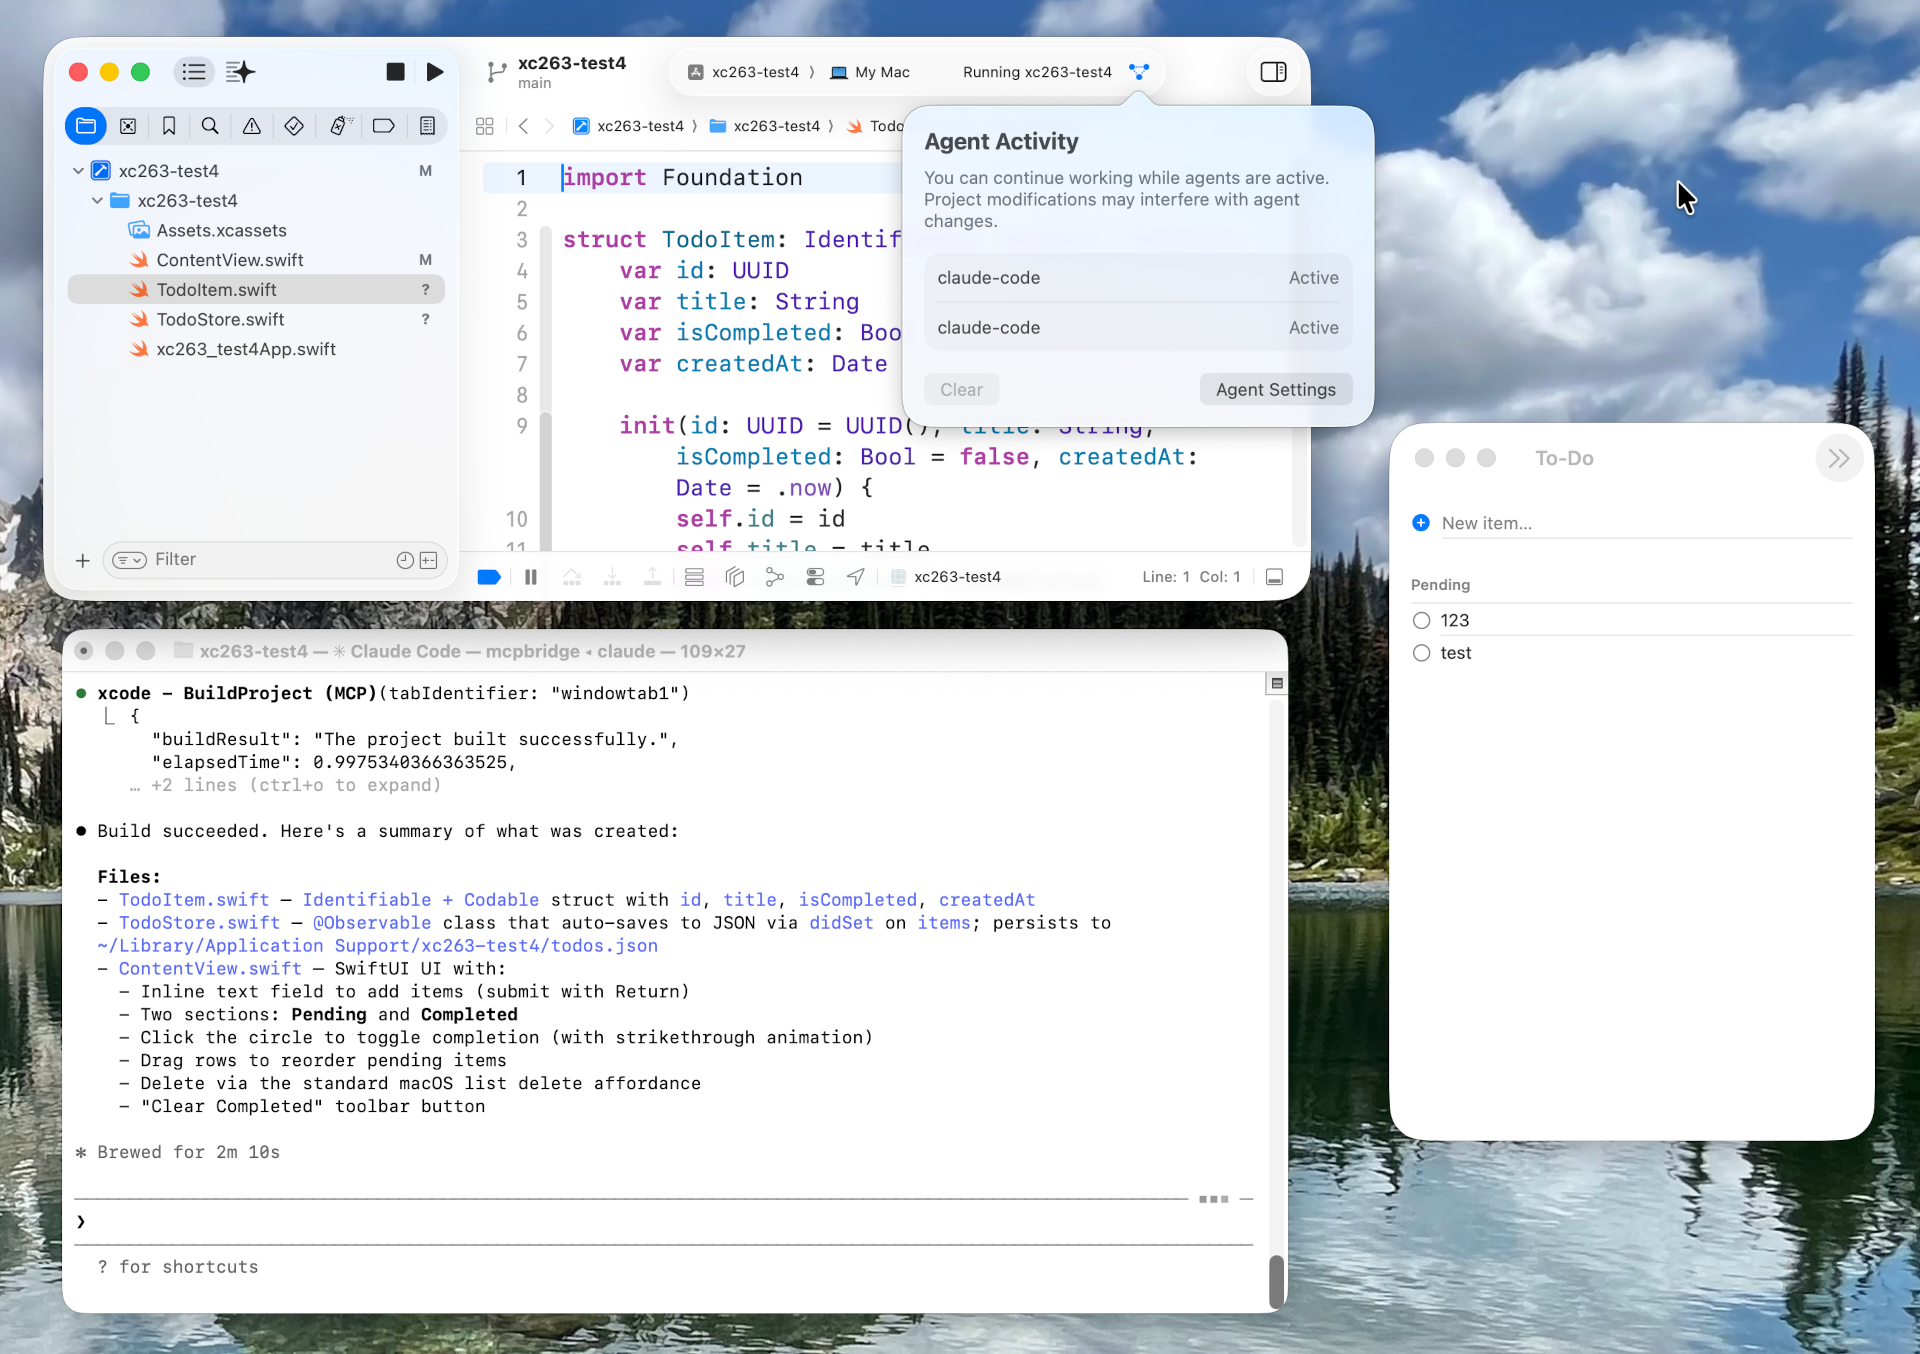
Sind alle Voraussetzungen erfüllt, schreiben Sie die Prompts in Claude Code und verwenden Xcode nur noch, um den Code anzusehen bzw. Ihre App zu testen.
Claude Code im Terminal unten hat eine Todo-App programmiert. Claude Code nutzt MCP, um Xcode-Funktionen aufzurufen.
Sonstiges
Auch Xcode 26.3 verwendet Swift 5 per Default. Wenn Sie Swift 6 wünschen, müssen Sie die Build Settings ändern. (Update 31.3.2026: Auch Xcode 26.4 bleibt bei Swift 5.)
Der in Xcode 26 eliminierte Attribute Inspector ist nicht zurückgekommen. Das gilt auch für diverse andere UI-Elemente (z.B. die Refactor-Kommandos Extract Subview oder Embed in Xxx), die es früher in Xcode gab und die mit Version 26 verschwunden sind.
Die aktuelle Swift-Version lautet — unverändert seit September 2025 — 6.2. (Genau genommen sind wir bei 6.2.4, aber es gibt seit einem halben Jahr keine nennenswerten Neuerungen.)
https://www.youtube.com/live/sc6pvW6vQzA (zweistündiges Video von Paul Hudson, zwar mit einigem Leerlauf, aber dennoch empfehlenswert; behandelt auch Claude Code)
Seit über 30 Jahren nutze ich Linux, und knapp 25 Jahre davon war die bash meine Shell. Ein eigener Prompt, der das aktuelle Verzeichnis farbig anzeigte, was das Maß der Dinge :-)
Mein Umstieg auf die zsh hatte mit Git zu tun: Die zsh in Kombination mit der Erweiterung Oh my zsh gibt im Prompt direktes Feedback über den Zustand des Repositories (aktiver Zweig, offene Änderungen). Außerdem agiert die zsh in vielen Details »intelligenter« (ein viel strapazierter Begriff, ich weiß) als die bash. Es macht ein wenig Arbeit, bis alles so funktioniert wie es soll, aber ich war glücklich mit meinem Setup.
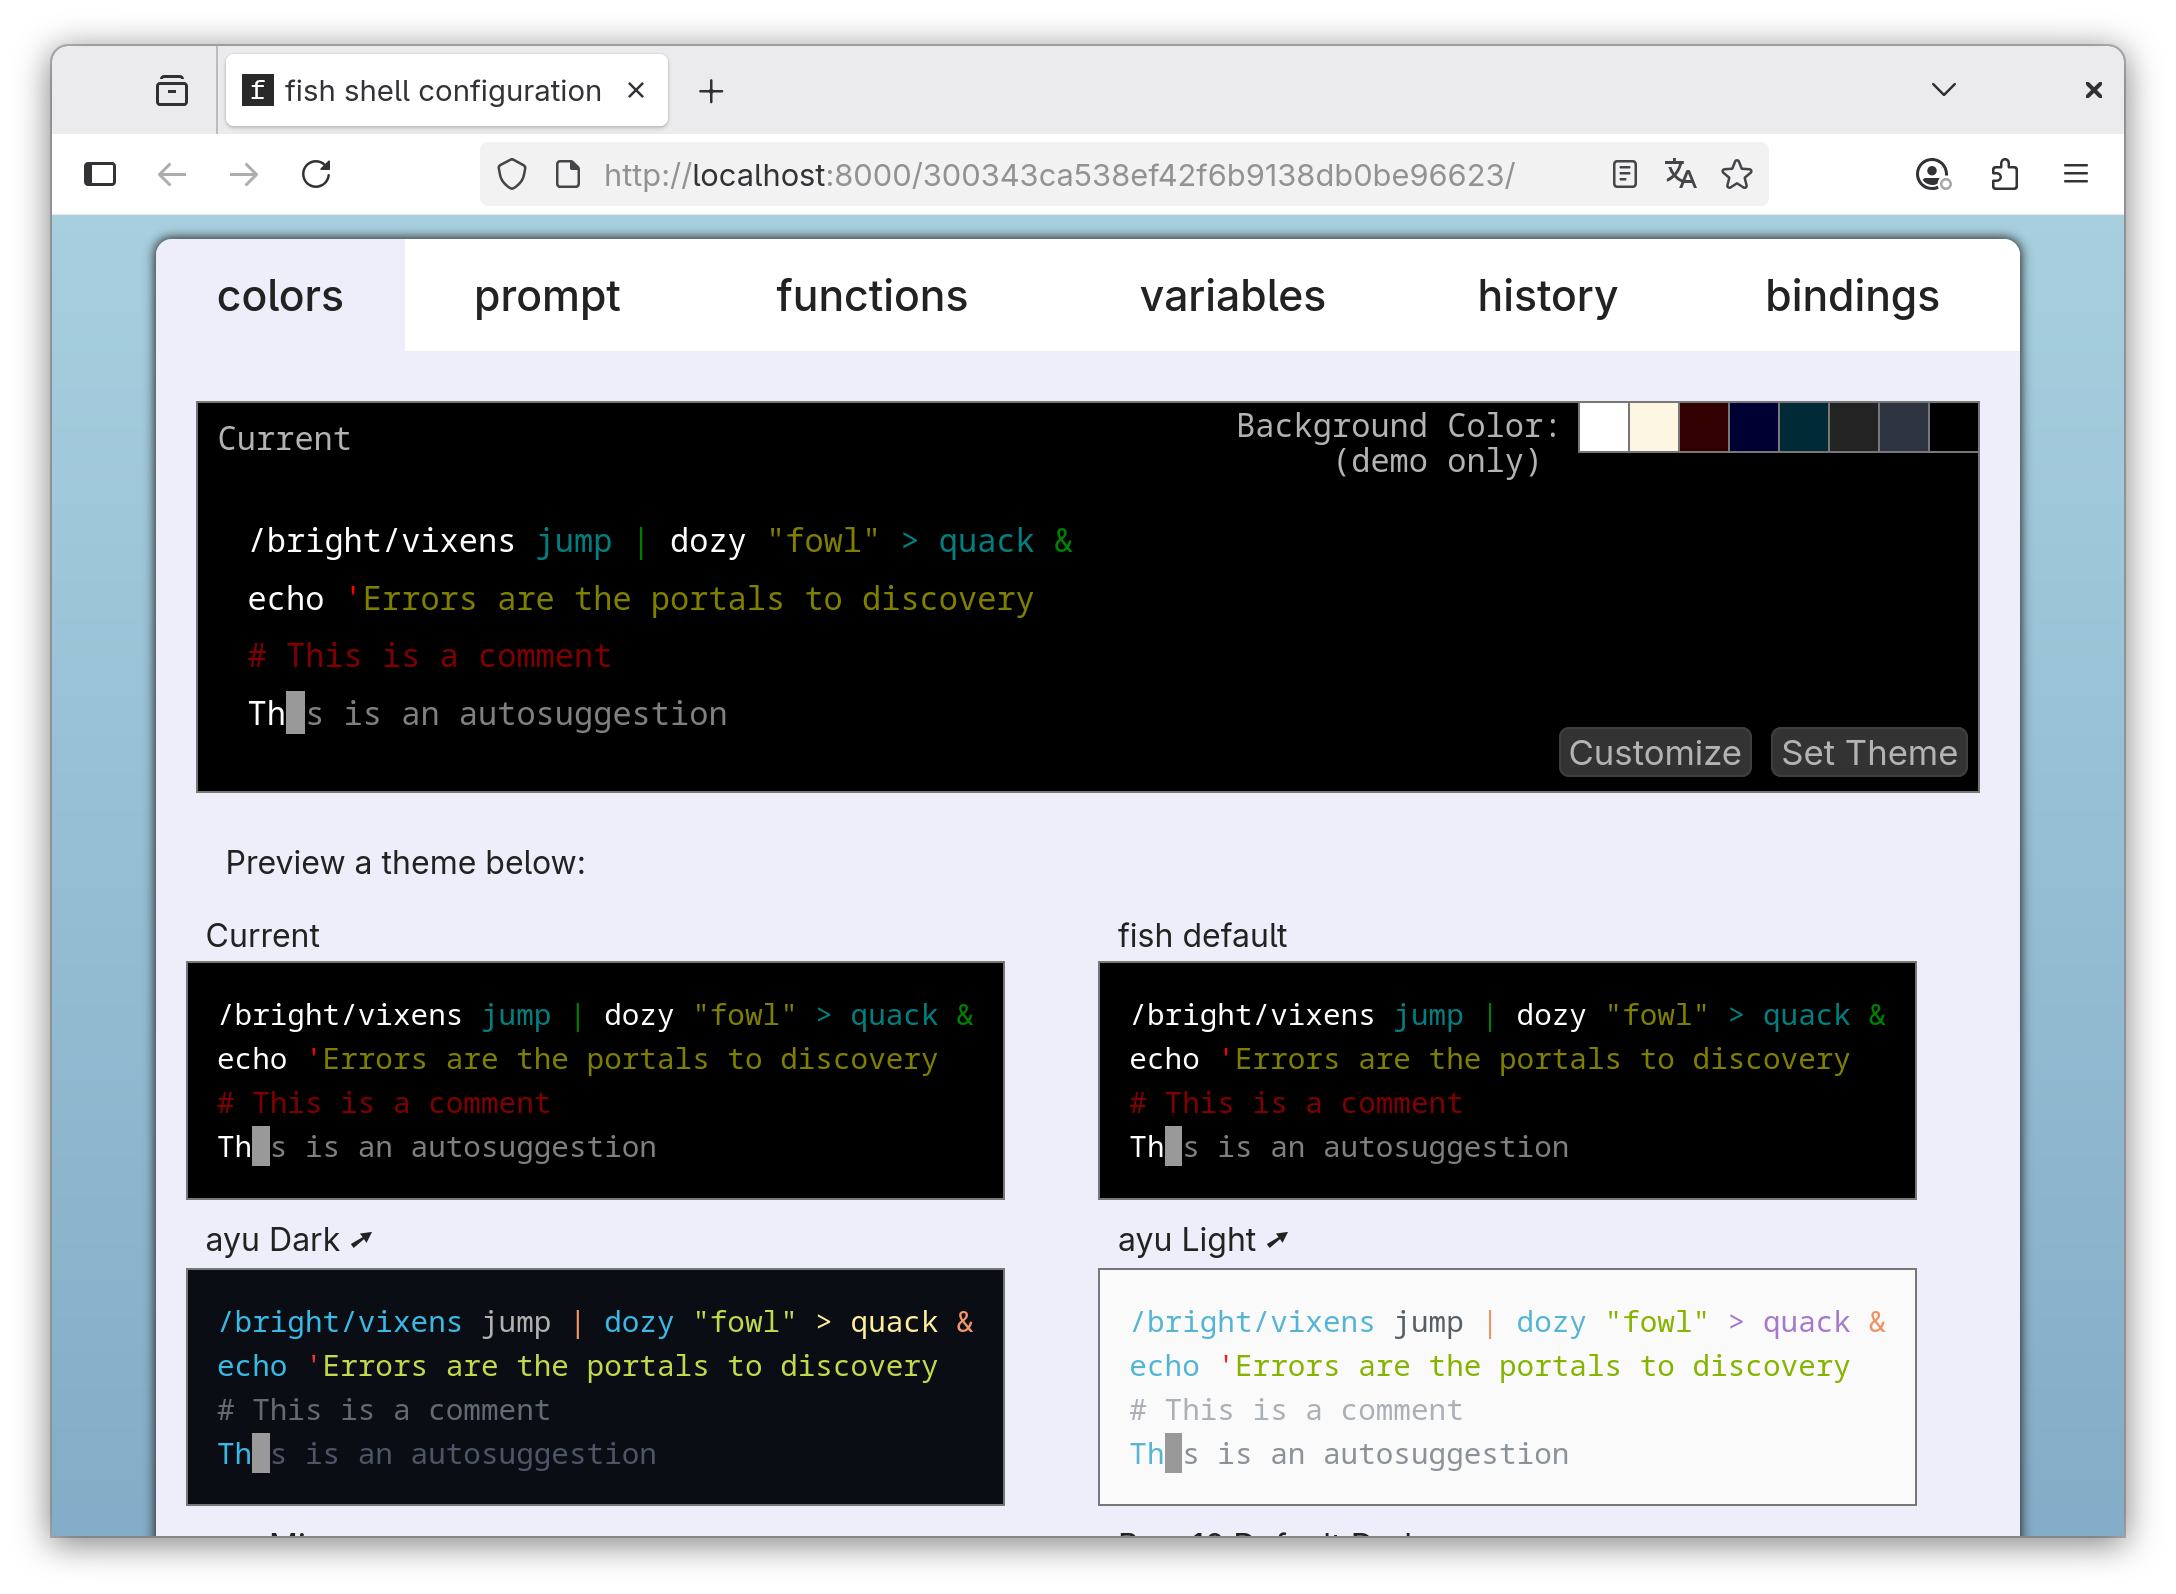
Seit ein paar Monaten habe ich die Default-Shell meiner wichtigsten Linux-Installationen neuerlich gewechselt. Ich gehöre jetzt zum rasch wachsenden Lager der fish-Fans. fish steht für Friendly Interactive Shell, und die Shell wird diesem Anspruch wirklich gerecht. fish bietet von Grund auf eine Menge Features, die zsh plus diverse Plugins inklusive Oh my zsh erst nach einer relativ mühsamen Konfiguration beherrschen. Die Inbetriebnahme der fish dauert bei den meisten Distributionen weniger als eine Minute — und die Defaultkonfiguration ist so gut, dass weitere Anpassungen oft gar nicht notwendig sind. Und sollte das doch der Fall sein, öffnet fish_config einen komfortablen Konfigurationsdialog im Webbrowser (außer Sie arbeiten in einer SSH-Session).
Die Stärken der fish im Vergleich zu bash und zsh haben aus meiner Sicht wenig mit der Funktionalität zu tun; einige Features der fish lassen sich auch mit bash-Hacks erreichen, fast alle mit zsh-Plugins. Der entscheidende Vorteil ist vielmehr, dass die fish out of the box zufriedenstellend funktioniert. Für mich ist das deswegen entscheidend, weil ich viele Linux-Installationen verwende und keine Zeit dafür habe, mich jedesmal mit dem Shell-Setup zu ärgern. Deswegen hatte ich in der Vergangenheit auf meinen wichtigsten Installationen zsh samt einer maßgeschneiderten Konfiguration, auf allen anderen aber der Einfachheit halber die bash oder eine unkonfigurierte zsh-Installation.
Auf den ersten Blick sieht die »fish« aus wie jede andere Shell
Installation
Die Installation ist schnell erledigt. Alle gängigen Distributionen stellen fish als Paket zur Verfügung. Also apt/dnf install fish, danach:
chsh -s $(which fish)
Aus- und neu einloggen, fertig.
Falls Ihnen die fish doch nicht zusagt, ist die bisherige Shell ebenso schnell mit chsh -s $(which bash) oder chsh -s $(which zsh) reaktiviert.
Features
Im Prinzip verhält sich die fish wie jede andere Shell. Insbesondere gelten die üblichen Mechanismen zum Start von Kommandos, zur Ein- und Ausgabeumleitung mit < und >, zur Bildung von Pipes mit | sowie zur Verarbeitung von Kommandoergebnissen mit $(cmd). Was ist also neu?
Während der Eingabe verwendet die fish Farben, um verschiedene Bestandteile Ihres Kommandos (z.B. Zeichenketten) zu kennzeichnen. Das sieht nett aus, der entscheidende Vorteil ist aber, dass Sie oft Tippfehler erkennen, bevor Sie Return drücken: Kommandos, die es gar nicht gibt, werden rot hervorgehoben, ebenso nicht geschlossene Zeichenketten. (Die Farben sind vom aktiven Farbschema abhängig.)
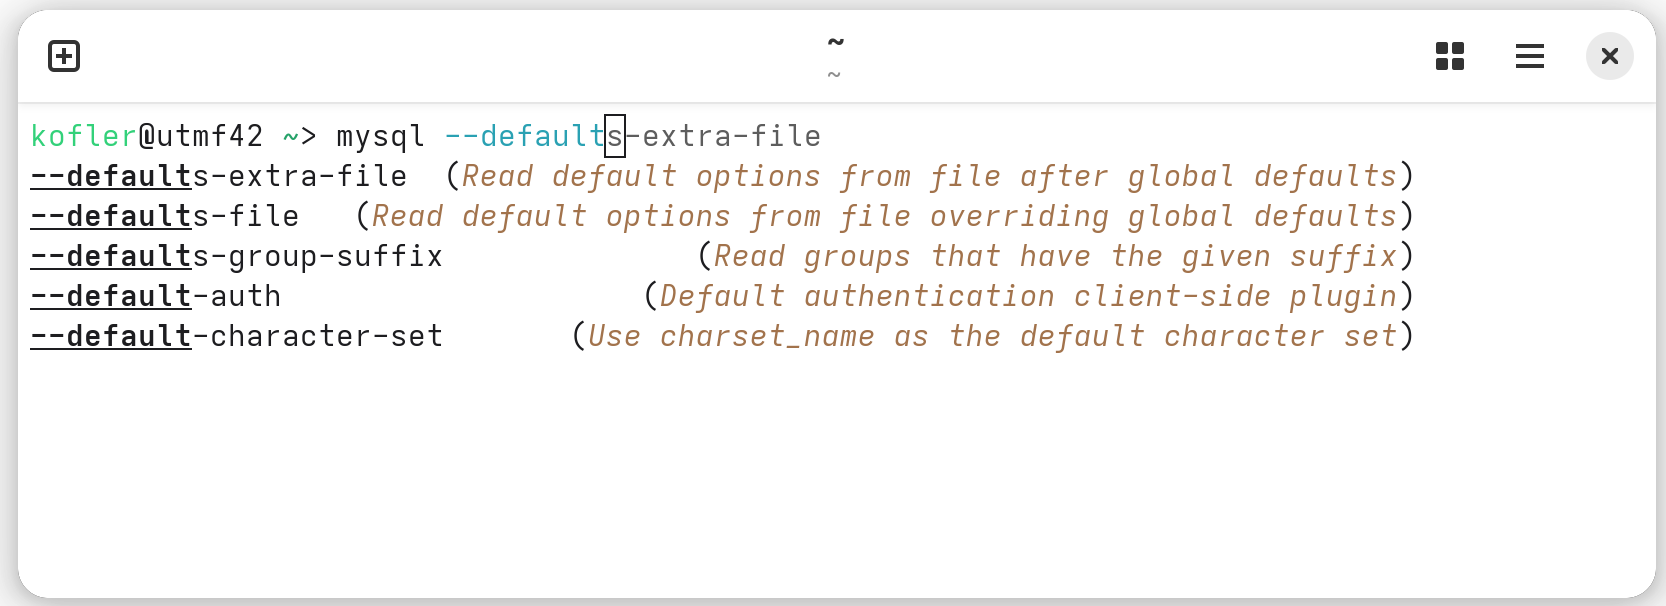
Die Vervollständigung von Kommandos, Optionen, Datei- und Variablennamen mit der Tabulator-Taste ist noch »intelligenter« als bei bash und zsh. fish greift dazu auf über 1000 *.fish-Dateien im Verzeichnis /usr/share/fish/completions zurück, die Regeln für alle erdenklichen Fälle enthalten und mit jeder fish-Version erweitert werden. Die fish zeigt sogar kurze Hilfetexte an (siehe die folgende Abbildung). Wenn es viele mögliche Vervollständigungen gibt, zeigt fish diese in mehreren Spalten an. Sie können mit den Cursortasten das gewünschte Element auswählen.
Bei der Eingabe von Kommandos durchsucht die fish die History, also eine Datei, in der alle zuletzt ausgeführten Kommandos gespeichert wurden. In etwas blasserer Schrift schlägt es das passendste Kommando vor. Die fish berücksichtigt dabei auch den Kontext (welches Verzeichnis ist aktiv, welche Kommandos wurden vorher ausgeführt) und schlägt oft — fast schon ein wenig unheimlich — das richtige Kommando vor. Wenn Sie dieses Kommando ausführen möchten, vervollständigen Sie die Eingabe mit Cursor rechts (nicht Tabulator!) und drücken dann Return. Durch ähnliche Kommandos können Sie mit den Cursortasten blättern.
Alternativ können Sie auch mit Strg+R suchmuster nach früher ausgeführten Kommandos suchen. Die fish sucht nach dem Muster nicht nur in den Anfangsbuchstaben, sondern in den gesamten Zeichenketten der History.
Wenn das aktuelle Verzeichnis Teil eines Git-Repositories ist, zeigt fish den Namen des aktuellen Zweigs in Klammern an. (Wenn Sie mehr Git-Infos sehen wollen, ändern Sie die Prompt-Konfiguration.)
Die »fish« zeigt Hilfetexte zu allen »mysql«-Optionen an, die mit »–default« beginnen.
Globbing-Eigenheiten
In Shells wird die Umwandlung von *.txt in die Liste passender Dateinamen als »Globbing« bezeichnet. Die fish verhält sich dabei fast gleich wie die bash — aber mit einem kleinen Unterschied: Wenn es keine passenden Dateien gibt (z.B. keine einzige Datei mit der Endung .txt), löst die fish einen Fehler aus. Die bash übergibt dagegen das Muster — also *.txt — an das Kommando und überlässt diesem die Auswertung. In der Regel tritt der Fehler dann dort auf. Also kein großer Unterschied?
Es gibt Sonderfälle, in denen das Verhalten der bash günstiger ist. Stellen Sie sich vor, Sie wollen mit scp alle *.png-Dateien von einem externen Rechner auf Ihren lokalen Rechner übertragen:
scp externalhost:*.png .
In der bash funktioniert das wie gewünscht. Die fish kann aber mit externalhost:*.png nichts anfangen und löst einen Fehler aus. Abhilfe: Sie müssen das Globbing-Muster in Anführungszeichen stellen, also:
scp "externalhost:*.png" .
Analoge Probleme können auch beim Aufruf von Paketkommandos auftreten. apt install php8-* funktioniert nicht, wohl aber apt install "php8-*". Hintergründe zum Globbing-Verhalten können Sie hier nachlesen:
Tastenkürzel
Grundsätzlich gelten in der fish dieselben Tastenkürzel wie in der bash. In der fish gibt es darüberhinaus weitere Kürzel, von denen ich die wichtigsten hier zusammengestellt habe. bind oder fish_config (Dialogblatt bindings) liefert eine wesentlich längerer Liste aller Tastenkürzel. Beachten Sie, dass es vom Desktopsystem und vom Terminal abhängt, ob die Alt-Tastenkürzel wirklich funktionieren. Wenn die Kürzel vom Terminal oder dem Desktopsystem verarbeitet werden, erreichen Sie die fish nicht.
Kürzel              Bedeutung
------------------  -------------------------------------------------------
Alt+Cursor links    führt zurück ins vorige Verzeichnis (prevd)
Alt+Cursor rechts   macht die obige Aktion rückgängig (nextd)
Alt+E               öffnet den Dateinamen mit $EDITOR
Alt+H oder F1       zeigt die man-Seite zum eingegebenen Kommando an (Help)
Alt+L               führt ls aus
Alt+P               fügt der Eingabe &| less hinzu (Pager)
Alt+S               fügt sudo am Beginn der Eingabe ein
Alt+W               zeigt Aliasse und eine Beschreibung des Kommandos (What is?)
Noch eine Anmerkung zu Alt+S: In meiner Praxis kommt es ständig vor, dass ich sudo vergesse. Ich führen also dnf install xy aus und erhalte die Fehlermeldung, dass meine Rechte nicht ausreichen. Jetzt drücke ich einfach Alt+S und Return. Die fish stellt sudo dem vorigen, fehlgeschlagenen Kommando voran und führt es aus.
Konfiguration
Das Kommando fish_config öffnet einen Konfigurationsdialog im Webbrowser. Falls Ihr Webbrowser gerade minimiert ist, müssen Sie das Fenster selbst in den Vordergrund bringen. Im Browser können Sie nun ein Farbenschema auswählen, noch mehr Informationen in den Prompt integrieren, die Tastenkürzel nachlesen etc.
In SSH-Sessions scheitert der Start eines Webbrowsers. In diesem Fall können Sie mit fish_config prompt bzw. fish_config theme das Promptaussehen und das Farbschema direkt im Textmodus verändern.
fish-Konfiguration im Webbrowser
Wenn Sie Änderungen durchführen, werden diese im Terminal mit set -U fish_xxx newvalue ausgeführt und in Konfigurationsdateien in .config/fish gespeichert, insbesondere in:
Das Gegenstück zu .bashrc oder .zshrc ist die Datei .config/fish/config.fish. Das ist der richtige Ort, um eigene Abkürzungen zu definieren, den PATH zu erweitern etc. config.fish enthält einen vordefinierten if-Block für Einstellungen, die nur für interaktive fish-Sessions relevant sind. Alle anderen Einstellungen, die z.B. in Scripts gelten sollen, führen Sie außerhalb durch. Das folgende Listing zeigt ein paar typische Einstellungen:
# Datei .config/fish/config.fish
...

# PATH ändern
fish_add_path ~/bin
fish_add_path ~/.local/bin

# keine fish-Welcome-Nachricht
set -U fish_greeting ""

# Einstellungen nur für die interaktive Nutzung
if status is-interactive
    # abr statt alias
    abbr -a ls eza
    abbr -a ll 'eza -la'
    abbr -a gc 'git commit'

    # Lieblingseditor
    set -gx EDITOR /usr/bin/jmacs
end
Das obige Listing zeigt schon, das die fish gängige Einstellungen anders handhabt als bash und zsh:
Abkürzungen: Anstelle von alias sieht die fish das Kommando abbr vor. alias steht auch zur Verfügung, von seinem Einsatz wird aber abgeraten. abbr unterscheidet sich durch ein paar Details von alias: Die Expansion in das Kommando erfolgt bereits, wenn Sie Return drücken. Sie sehen daher, welches Kommando wirklich ausgeführt wird, und dieses Kommando (nicht die Abkürzung) wird in der History gespeichert.
PATH-Änderungen: Sie müssen die PATH-Variable nicht direkt verändern, sondern können stattdessen fish_add_path aufrufen. Ihr Pfad wird am Ende hinzugefügt, wobei die Funktion sicherstellt, dass es keine Doppelgänger gibt.
Variablen (set): Die Optionen des set-Kommandos zur Einstellung von Variablen funktionieren anders als in der bash:
-g: Die Variable ist in der gesamten fish-Session zugänglich (Global Scope), nicht nur in einer Funktion oder einem Block.
-x: Die Variable wird an Subprozesse weitergegeben (Export).
-U: Die Variable wird dauerhaft in .config/fish/fish_variables gespeichert und gilt daher auch für künftige fish-Sessions (Universal). Sie wird aber nicht exportiert, es sei denn, Sie verwenden -Ux.
-l: Definiert eine lokale Variable, z.B. innerhalb einer Funktion.
Zusätzliche eingebaute Kommandos
Jede Shell hat eine Menge integrierter Kommandos wie cd, if oder set. In der fish können Sie mit builtin -n alle derartigen Kommandos auflisten. Die meisten Kommandos entsprechen exakt den bash- und zsh-Vorgaben. In der fish gibt es aber einige originelle Erweiterungen: math führt einfache Berechnungen aus, random produziert ganzzahlige Zufallszahlen, string manupuliert Zeichenketten ohne die umständliche Parametersubstitution, path extrahiert Komponenten aus einem zusammengesetzten Dateinamen, count zählt Objekte (vergleichbar mit wc -l etc. Das folgende Listing zeigt die Anwendung dieser Kommandos:
math "2.5 * 3.8"

  9.5

string split " "  "lorem ipsum dolor est"

  lorem
  ipsum
  dolor
  est

string replace ".png" ".jpg" file1.png file2.png file3.png

  file1.jpg
  file2.jpg
  file3.jpg

string sub -s 4 -e 8 "abcdefghijkl"   # Start und Ende inklusive

  defgh

path basename /home/kofler/images/img_234.png

  img_234.png

path dirname /home/kofler/images/img_234.png

  /home/kofler/images

path extension /home/kofler/images/img_234.png

  .png

random 1 100

  13

random choice a b c

  c

count *          # das aktuelle Verzeichnis hat
                 # 32 Dateien/Verzeichnisse
  32

ps ax | count    # gerade laufen 264 Prozesse

  264
Programmierung
Die Bezeichnung Friendly Interactive Shell weist schon darauf hin: Die fish ist für die interaktive Nutzung optimiert, nicht für die Programmierung. Die fish unterstützt aber sehr wohl auch die Script-Programmierung. Diese ist insofern attraktiv, weil die fish-Entwickler auf maximale Kompatibilität verzichtet haben und die schlimmsten Syntaxungereimtheiten der bash behoben haben. fish-Scripts sind daher ungleich leichter zu verstehen als bash-Scripts. Umgekehrt heißt das leider: fish-Scripts sind inkompatibel zu bash und zsh und können nur ausgeführt werden, wo die fish zur Verfügung steht. Für mich ist das zumeist ein Ausschlusskriterium.
Anstelle einer systematischen Einführung will ich Ihnen hier anhand eines Beispiels die Vorteile der fish beim Programmieren nahebringen. Das Script ermittelt die Anzahl der Zeilen für alle *.txt-Dateien im aktuellen Verzeichnis. (Ich weiß, wc -l *.txt wäre einfacher; es geht hier nur darum, diverse Syntaxeigenheiten in wenig Zeilen Code zu verpacken.) Die bash-Variante könnte so aussehen:
#!/bin/bash
files=(*.txt)
if [ ${#files[@]} -eq 0 ]; then
    echo "No .txt files found"
    exit 1
fi
for file in "${files[@]}"; do
    if [ -f "$file" ]; then
        lines=$(wc -l < "$file")
        echo "$file: $lines lines"
    fi
done
Das äquivalente fish-Script ist deutlich besser lesbar:
#!/usr/bin/env fish
set files *.txt
if not count $files > /dev/null
    echo "No .txt files found"
    exit 1
end
for file in $files
    if test -f $file
        echo "$file: "(count < $file)" lines"
    end
end
Auf ein paar Details möchte ich hinweisen:
Kontrollstrukturen werden generell mit end abgeschlossen, nicht mit fi für if oder mit esac für case.
Bedingungen für if, for etc. müssen weder in eckige Klammern gestellt noch mit einem Strichpunkt abgeschlossen werden.
Die fish verarbeitet Variablen korrekt selbst wenn sie Dateinamen mit Leerzeichen enthalten. Es ist nicht notwendig, sie in Anführungszeichen zu stellen (wie bei "$file" im bash-Script).
Wenn Sie in eigenen Scripts Optionen und andere Parameter verarbeiten möchten, hilft Ihnen dabei das Builtin-Kommando argparse. Eine gute Zusammenstellung aller Syntaxunterschiede zwischen bash und fish gibt die fish-Dokumentation.
Paketmanager fisher
Das Versprechen von fish ist ja, dass fast alles out-of-the-box funktioniert, dass die Installation von Zusatzfunktionen und deren Konfiguration ein Thema der Vergangenheit ist. Aber in der Praxis tauchen trotzdem immer Zusatzwünsche auf. Mit dem Paketmanager fisher können Zusatzmodule installiert werden. Eine Sammlung geeigneter Plugins finden Sie hier.
Die Geschichte von fish
Die fish ist erst in den letzten Jahren so richtig populär geworden. Das zeigt, dass es auch in der Linux-Welt Modetrends gibt. fish ist nämlich alles andere als neu. Die erste Version erschien bereits 2005.
fish wurde ursprünglich in C entwickelt, dann nach C++ und schließlich nach Rust portiert. Erst seit Version 4.0 (erschienen im Februar 2025) besteht fish ausschließlich aus Rust-Code sowie in fish selbst geschriebenen Erweiterungen.
Fazit
Die fish punktet durch die gut durchdachte Grundkonfiguration und die leichte Zugänglichkeit (Konfiguration und Hilfe im Webbrowser). Es gibt nicht das eine Feature, mit dem sich die fish von anderen Shells abhebt, es ist vielmehr die Summe vieler, gut durchdachter Kleinigkeiten und Detailverbesserungen. Das Arbeiten in der fish ist intuitiver als bei anderen Shells und macht mehr Spaß. Probieren Sie es aus!
Bei der Programmierung ist die fish inkompatibel zu anderen Shells und insofern kein Ersatz (auch wenn die fish-eigenen Features durchaus spannend sind). Zur Ausführung traditioneller Shell-Scripts brauchen Sie weiterhin eine traditionelle Shell, am besten die bash.
Als ich vor 40 Jahren zu schreiben begann, war klar, was ein IT-Fachbuch liefern musste: Korrekte Information zu einem Thema, zu einer Programmiersprache, zu Linux etc. … Je mehr Information, desto besser. Ein dickes Buch war also im Regelfall wertvoller als ein dünnes.
Das IT-Buch war damals nahezu konkurrenzlos: Zu kommerziellen Software-Produkten gab es im Idealfall ein gedrucktes Handbuch (oft lieblos gestaltet und von dürftiger Qualität), dazu eventuell noch ein paar Readme-Dateien; ansonsten waren Administratorinnen und Programmierer weitgehend auf sich selbst gestellt. Mit etwas Glück veröffentlichte eine der damals noch viel zahlreicheren Zeitschriften einen Artikel mit Lösungsideen für ein spezifisches Problem. Aber ansonsten galt: Learning by doing.
Mit dem Siegeszug des Internets änderte sich der IT-Buchmarkt zum ersten Mal radikal: Der Vorteil des Buchs lag nun darin, dass die dort zusammengestellten Informationen (hoffentlich!) besser recherchiert und besser strukturiert waren als die über das Internet und in Videos verstreuten Informationsschnipsel, Tipps und Tricks. Ein gutes Buch konnte ganz einfach Zeit sparen.
Das IT-Buch stand plötzlich in Konkurrenz zur Informationsfülle des Internets. Es liegt in der Natur der Sache, dass ein Buch nie so aktuell sein kann wie das Internet, nie so allumfassend bei der Themenauswahl. Im Internet finden sich selbst für exotische Funktionen Anleitungen, selbst zu selten auftretenden Fehlern Tipps oder zumindest Leidensberichte anderer Personen. Es hilft ja schon zu wissen, dass ein Problem nicht nur auf dem eigenen Rechner oder Server auftritt.
Natürlich habe auch ich als Autor von der einfachen Zugänglichkeit der Informationen profitiert. Während früher Ausprobieren der einzige Weg war, um bestimmte Techniken verlässlich zu dokumentieren, konnte ich jetzt auf den Erfahrungsschatz der riesigen Internet-Community zurückgreifen. Gleichzeitig sank aber der Bedarf nach IT-Büchern — und zwar in einem dramatischen Ausmaß. Viele Verlage, für die ich im Laufe der letzten Jahrzehnte geschrieben habe, existieren heute nicht mehr.
Mit der freien Verfügbarkeit von KI-Tools wie ChatGPT stehen wir heute vor einem weiteren Umbruch: Wozu noch nach einem Buch, einem StackOverflow-Artikel oder einem Blog-Beitrag suchen, wenn KI-Werkzeuge in Sekunden den Code für scheinbar jedes Problem, eine strukturierte Anleitung für jede Aufgabe liefern?
Möglichkeiten und Grenzen von KI-Tools
Seit die erste Version von ChatGPT online war, habe ich mich intensiv mit diesem und vielen anderen KI-Tools auseinandergesetzt. Natürlich habe ich darüber auch geschrieben, sowohl in diesem Blog als auch in Buchform: In Coding mit KI fassen Bernd Öggl, Sebastian Springer und ich zusammen, wie weit KI-Tools heute beim Coding und bei Administrationsaufgaben helfen — und wo ihre Grenzen liegen. Kurz gefasst: Claude, Copilot, Ollama etc. bieten bereits heute eine großartige Unterstüzung bei vielen Aufgaben. Sie machen Coding und Administration effizienter, schneller.
Ja, die Tools machen Fehler, aber sie sind dennoch nützlich, und sie werden jedes Monat besser. Ja, es gibt Datenschutzbedenken, aber die lassen sich lösen (am einfachsten, indem Sprachmodelle lokal ausgeführt werden). Ja, KI-Tools stellen mit ihrem exorbitaten Stromverbrauch vor allem in der Trainings-Phase eine massive ökologische Belastung dar; aber ich glaube/hoffe, dass sich KI-Tools mit bessere Hard- und Software in naher Zukunft ohne ein allzugroßes schlechtes Öko-Gewissen nutzen lassen.
Es ist für mich offensichtlich, dass viele IT-Arbeiten in Zukunft ohne KI-Unterstützung undenkbar sein werden. KI-Tools können bei der Lösung vieler Probleme die Effizienz steigern. Keine Firma, kein Admin, keine Entwicklerin wird es sich auf Dauer leisten können, darauf zu verzichten.
Die Zukunft des IT-Buchs
Ist »Coding mit KI« also das letzte IT-Buch, das Sie lesen müssen/sollen? Vermutlich nicht. (Aus meiner Sicht als Autor: Hoffentlich nicht!)
Auf jeden Fall ändern KI-Tools die Erwartungshaltung an IT-Bücher. Aktuell arbeite ich an einer Neuauflage meines Swift-Buchs. Weil sich inhaltlich viel ändert und ich bei vielen Teilen sowieso quasi bei Null anfangen muss, ist es das erste Buch, das ich von Grund auf im Hinblick auf das KI-Zeitalter neu konzipiere. In der vorigen Auflage habe ich über 1300 Seiten geschrieben und versucht, Swift und die App-Programmierung so allumfassend wie möglich darzustellen.
Dieses Mal bemühe ich mich im Gegenteil, die Seitenanzahl grob auf die Hälfte zu reduzieren. Warum? Weil ich glaube, dass sich das IT-Buch der Zukunft auf die Vermittlung der Grundlagen konzentriert. Es richtet den Blick auf das Wesentliche. Es erklärt die Konzepte. Es gibt Beispiele (durchaus auch komplexe). Aber es verzichtet darauf, endlose Details aufzulisten.
Was sind Ihre Erwartungen?
Ich weiß schon, immer mehr angehende und tatsächliche IT-Profis kommen ohne Bücher aus. Eigenes Ausprobieren in Kombination mit Videos, Blog-Artikeln und KI-Hilfe reichen aus, um neue Konzepte zu erlernen oder ganz pragmatisch ein Problem zu lösen (oft ohne es wirklich zu verstehen). Bleibt nur die Frage, warum Sie überhaupt auf meiner Website gelandet sind :-)
Persönlich lese ich mich in ein neues Thema aber weiterhin gerne ein, lasse mich von einem Autor oder einer Autorin von neuen Denkweisen überzeugen (zuletzt: Prometheus: Up & Running von Julien Pivotto und Brian Brazil). Bevorzugt mache ich das weit weg vom Computer. Wenn ich später ein Detail nochmals nachsehen will, ist mir ein E-Book willkommen. Aber beim ersten Lesen bevorzuge ich den analogen Zugang, ungestört und werbefrei.
Falls also auch Sie noch gelegentlich ein Buch zur Hand nehmen, dann interessiert mich Ihrer Meinung: Was erwarten Sie heute von einem IT-Buch? Was sind Ihre Wünsche an mich als Autor? Was ist aus Ihrer Sicht ein gutes IT-Buch, was ist ein schlechtes? Ich sage es sicherheitshalber gleich: Alle Wünsche kann ich nie erfüllen … Aber ich freue mich auf jeden Fall über Ihr Feedback!
Heute kann angeblich jeder programmieren. Sagen zumindest Forscher und CEOs aus der KI-Industrie. »Vibe Coding« ist das Wort des Jahres 2025. Sinngemäß meint das müheloses Programmieren dank KI-Unterstützung. Und tatsächlich ist jede der folgenden Aussagen grundsätzlich richtig, auf jeden Fall nicht ganz falsch:
2023, Andrej Karpathy (KI-Forscher, u.a. bei Tesla und OpenAI): The hottest new programming language is English.
2024, Jensen Huang (NVIDIA): It is our job to create computing technology such that nobody has to program. (…) Everybody in the world is now a programmer.
2025, Mark Zuckerberg (Meta): Probably in 2025, we (…) are going to have an AI that can effectively be a sort of mid-level engineer that you have at your company that can write code.
2026, Boris Cherny (Claude-Code-Erfinder): Coding is largely solved
Aber wie in jedem guten Krimi ist nichts so einfach, wie es scheint.
Traum …
Coding is largely solved ist ein wenig optimistisch. Tatsächlich können Coding-Tools, also IDEs wie Antigravity, Cursor oder VS Code sowie CLI-Tools wie Claude Code oder Codex in Kombination mit einem guten, kommerziellen Sprachmodell von z.B. Anthropic, Google oder OpenAI richtig gut programmieren. Der folgende Prompt führt bei den meisten Systemen innerhalb von Sekunden zum Ziel:
Prompt: Please provide a minimal implementation of ‚brick out‘ for the web browser. Use node. Keep the features to a minimum and the code concise.
Für Nicht-Programmierer besteht die größte Hürde darin, Node.js zu installieren, das Programm auszuführen und das Browserfenster richtig zu öffnen (also z.B. http://localhost:3000).
Agentic Tools funktionieren aber auch dann großartig, wenn es darum geht, sich in eine komplexe, existierende Code-Basis einzuarbeiten.
Prompt: Get me an overview about this project.
In der Folge ist es empfehlenswert, im Projektverzeichnis in AGENTS.md oder CLAUDE.md eine Zusammenfassung der wichtigsten Projektdaten zu speichern. Claude Code erstellt sich diese Datei mit /init gleich selbst, etwas Nacharbeit ist aber zweckmäßig. Der Sinn dieser Datei: Das KI-Tool beginnt nicht jede Session bei Null. Vielmehr weiß es, welche Regeln für Ihr Projekt gelten: Build-Tools, Unit-Tests, Datenbank- und Netzwerkzugriff, Bibliotheken, Schreibweisen usw.
Unter diesen Voraussetzungen können Sie dem KI-Tool Ihrer Wahl jetzt Aufträge geben, welche neuen Features es programmieren soll. Wird der Code anschließend funktionieren? Die Chancen stehen mittlerweile nicht schlecht. Eventuell müssen Sie bei Problemen mit ein paar weiteren Prompts nachhelfen. Idealerweise geben Sie dem Agentic-Coding-Tool die Erlaubnis, den Code selbst zu testen. Dann kann das Tool auftretenden Fehler oft selbst lösen.
… und Wirklichkeit
Jedes Projekt ist anders. KI-Tools brillieren, wenn populäre Programmiersprachen für alltägliche Probleme zur Anwendung kommen: also beim Python-Script zur Auswertung von CSV-Dateien, bei der Node.js-Anwendung für eine Web-UI oder beim Datenbank-Backend samt REST-API.
Bei richtig großen Projekten mit Hunderten, ja Tausenden von Dateien, bei ganz neuen Compiler-Versionen oder Bibliotheken, bei exotischen Programmiersprachen mit wenig Trainingsmaterial im Internet sinkt die Erfolgsquote deutlich. KI-Tools sind weiterhin eine Hilfe, aber nicht im gleichen Ausmaß. Hinweise im Prompt auf zusätzliche Dokumentation, auf interne Projektabhängigkeiten oder sonstige Besonderheiten machen plötzlich einen riesigen Unterschied.
Wer kann die Tools bedienen?
Mit dieser Frage kommen wir zum Kern des Problems: Die Eingangszitate stammen von Personen, die entweder ein kommerzielles Interesse daran haben, dass Coding mit KI funktioniert, oder von IT-Profis, die ein riesiges IT-Grundwissen und eine Menge praktischer Erfahrung mit KI-Tools haben. Das sind genau die Leute, bei denen Coding mit KI tatsächlich richtig gut funktioniert. Die wissen, wie der Prompt richtig formuliert wird, erkennen offensichtlich fehlgeleitete Antworten und greifen korrigierend ein, bevor sich das KI-Tool in eine Sackgasse manövriert.
Wenn Sie regelmäßig den Blog von Simon Willison oder Texte von vergleichbaren Entwicklern lesen, also von Leuten, die täglich programmieren und ständig die neuesten KI-Tools ausprobieren, dann gewinnen Sie den Eindruck: Coding mit KI ist kinderleicht. Drei, vier längere Prompts, schon ist ein neues Feature fertig. Jeder moderne Software Developer arbeitet so.
Tatsächlich ist es aber gerade umgekehrt! Wenn ich in meinem privaten und beruflichen Umfeld über KI spreche, stoße ich auf viel Zurückhaltung. Jeder hat schon KI-Tools ausprobiert, allerdings hat auch jeder schon negative Erfahrungen gemacht. Nur wenige kennen die gerade aktuellen Tools oder Sprachmodelle. Nur wenigen ist klar, wie gut diese Tools mittlerweile sind. (Das ist verständlich: Professionelle Entwickler stehen unter Zeitdruck, sollen Features liefern, Bugs beheben, Sicherheitslücken stopfen. Da bleibt wenig Zeit, um ständig neue KI-Tools auszuprobieren.)
Was heißt programmieren?
Jeder kann programmieren! Vielleicht, aber welche Programme? Für ein kleines Tool oder Spiel, das nur lokal/privat genutzt werden soll, gelten ganz andere Regeln als für professionelle Software. Ja, Vibe Coding macht Spaß. Aber wollen Sie in einem Auto sitzen (oder diesem Auto begegnen), dessen Software so erstellt wurde?
Prompt: Entwickle die Steuerungs-Software für die Lenkung und Bremse eines Autos. Wenn das Lenkrad nach links bzw. rechts gedreht wird, ändere den Einstellwinkel der Räder entsprechend. Wenn das Bremspedal gedrückt wird, aktiviere die Bremsen der vier Räder. Je mehr das Pedal gedrückt wird, desto stärker soll das Auto abgebremst werden. Falls die Räder blockieren, während sich das Fahrzeug noch bewegt, aktiviere das Antiblockiersystem.
Was kann schon schief gehen?
Erfahrungen aus vier Jahren »Scripting«-Unterricht
Die vergangenen vier Jahre habe ich auf der FH JOANNEUM in Kapfenberg das Fach »Scripting« unterrichtet. Die StudentInnen mussten in Zweier- oder Dreiergruppen eine Projektarbeit durchführen. In allen vier Jahren durften sie dabei — ganz offiziell! — KI-Tools zu Hilfe nehmen.
Im Verlauf des ersten Durchlaufs im Wintersemester 2022/23 gab OpenAI die erste Version von ChatGPT frei. Alle waren beeindruckt (auch ich), dass reguläre Ausdrücke jetzt mit KI-Hilfe zusammengestellt werden konnten. Manchmal funktionierten sie sogar. KI-Tools waren bei der Projektarbeit eine gewisse Hilfe, aber keine große.
Bis zum vierten Durchlauf (WS 2025/26) machten KI-Tools gleich mehrere Quantensprünge. Agentic Coding wurde zur Selbstverständlichkeit, zumindest für einen Teil der Teilnehmer. Einige Teams lieferten großartige Projektarbeiten, die 2022/23 aufgrund des Zeitaufwands vollkommen undenkbar gewesen wären. Umgekehrt gilt: Den Code etlicher Arbeiten aus dem Jahr 2022/23 würden heutige KI-Tools mit zwei, drei Prompts direkt liefern. Fertig ist das Projekt! Der Quantensprung in der Qualität von KI-Tools führte also — nicht ganz überraschend — zu einem Quantensprung auch bei den Projektarbeiten. Jeder, jede kann jetzt Programmieren, oder?
Ich will hier aber auf einen anderen Punkt hinaus. Das Vorwissen meiner StudentInnen variiert stark. Manche programmieren seit Jahren, hatten bereits eine solide IT-Ausbildung. Andere sind praktisch neu in der IT. (Die Lehrveranstaltung findet im 3. Semester statt.)
Obwohl alle Teams KI-Tools verwenden dürfen, spiegelt sich das Vorwissen dramatisch in den Projektarbeiten wider. Auch wenn das Niveau der heurigen Projektarbeiten im Durchschnitt viel höher war als drei Jahre zuvor, blieb die Spannbreite unverändert, wurde womöglich noch größer. Teams mit viel IT-Vorwissen bedienten die KI-Tools intelligenter, zielgerichteter und lieferten viel bessere Ergebnisse. Teams, deren Teilnehmer weniger IT-Erfahrung hatten, halfen auch die KI-Tools nur in begrenztem Ausmaß. Obwohl die Ausgangslage für alle gleich war, bleibt es dabei: Besseres Vorwissen, bessere Ergebnisse. Die KI ändert daran nichts, verstärkt eher die Unterschiede.
Fazit
KI macht Software-Entwicklung schneller, effizienter und, wie ich finde, angenehmer. KI nimmt das lästige Formulieren von Schleifen, Methoden und Klassen ab. Es ist nicht mehr so wichtig, ob Sie alle Syntax-Details auswendig kennen — die KI kümmert sich schon darum.
Davon abgesehen ändert sich aber überraschend wenig: Die vernünftige Anwendung von KI-Tools setzt weiterhin ein großes IT-Wissen voraus. Wer mehr Erfahrung hat, mehr Grundlagen kennt, eine solide IT-Ausbildung hat, der/die wird bessere Ergebnisse erzielen, qualitativ guten, sicheren, wartbaren Code produzieren. Das gilt mit oder ohne KI-Tools. Aber mit KI sind Sie in den meisten Fällen schneller fertig.
KI-Tools ändern nichts daran, dass Sie intelligente Prompts formulieren und den resultierenden Code verstehen müssen. Auch in Zukunft müssen Sie im professionellen Segment die Verantwortung für Ihren Code übernehmen. Sie können sich nicht drauf ausreden, dass die KI eben einen Fehler gemacht hat. Es bleibt Ihr Fehler!
Kurz und gut: Professionelle Software-Entwicklung kann eben doch nicht jeder! Vibe Coding ist in diesem Segment nicht zielführend.
PS: Zuletzt die obligatorische Werbeeinschaltung (obwohl diese Website ja eigentlich werbefrei ist, auf jeden Fall frei von externer Werbung): Die vergangenen vier Monate haben Bernd Öggl, Sebastian Springer und ich unser Buch »Coding mit KI« komplett überarbeitet. In meiner fast 40-jährigen Autorenkarriere ist es noch nie vorgekommen, dass ich ein Buch nach nur 18 Monaten so umfassend ändern musste! Wenn Sie sich für KI-assistierte Software-Entwicklung interessieren, werfen Sie einen Blick in das Buch. Es erscheint Anfang Mai.
Aktuell schreibe ich hier mehr zu Docker als mir lieb ist. Es ist eigentlich absurd: Ich verwende Docker seit Jahren täglich und in der Regel ohne irgendwelche Probleme. Aber in den letzten Wochen prasseln Firewall-Inkompatibilitäten und anderer Ärger förmlich über Docker-Anwender herein.
Konkret geht es in diesem Beitrag um zwei Dinge:
Mit dem Update auf containerd 1.7.28 hat Docker eine Sicherheitslücke durch eine zusätzliche AppArmor-Regel behoben. Das ist eigentlich gut, allerdings führt diese Sicherheitsmaßnahme zu Ärger im Zusammenspiel mit gewissen Containern (z.B. immich) unter Host-Systemen mit AppArmor (Ubuntu, Proxmox etc.)
Docker Engine 29 verlangt die API-Version 1.44 oder neuer. Programme, die eine ältere API-Version verwenden, produzieren dann den Fehler Client Version 1.nnn is too old. Betroffen ist/war unter anderem das im Docker-Umfeld weit verbreitete Programm Traefik.
Im Anfang war der Bug, in diesem Fall CVE-2025-52881. Ein Angreifer kann runc (das wiederum Teil von containerd.io ist) mit Shared Mounts dazu bringen, /proc-Schreibvorgänge auf andere procfs-Dateien umzuleiten. Das ist wiederum sicherheitstechnisch ziemlich ungünstig (Severity ist High). Docker hat das Problem mit containerd 1.7.28-2 behoben — aber jetzt spießt es sich mit AppArmor, das nicht mehr den kompletten Pfad sieht und deswegen eingreift. Der Docker-Security-Fix kann auf Hosts mit AppArmor also dazu führen, dass auch korrekte Zugriffe blockiert werden. Die beste Beschreibung gibt dieser Blog-Beitrag.
Ich kann aus eigener Erfahrung nicht viel zu diesem Problem sagen. Ich betreibe aktuell kein System, das betroffen ist. Besonders oft tritt der Bug in Kombination mit Proxmox oder LXC auf (siehe dieses containerd Issue). Aber auch die weit verbreitete immich.app zum Foto-Management ist betroffen (siehe diese Diskussion).
Die in den verlinkten Beiträgen präsentierten Lösungsvorschläge sind leider allesamt wenig überzeugend: Das Docker-Update nicht durchführen/blockieren, eine alte Docker-Version re-installieren, AppArmor-Regeln ändern etc.
Client Version too old
Vollkommen unabhängig vom ersten Probem, aber fast zeitgleich aufgetreten ist der Fehler Client Version 1.nnn too old. Er resultiert daraus, dass die Docker Engine ab Version 29 für die API-Steuerung zumindest die API-Version 1.44 voraussetzt. (Bis zur Docker Enginge 28 reichte die API-Version 1.24.)
docker version

  ...
  Server: Docker Desktop 4.51.0 (210443)
   Engine:
     Version:          29.0.0
     API version:      1.52 (minimum version 1.44)    <------
  ...
Wenn nun ein Programm eine ältere API-Version nutzt, kommt es zum in der Überschrift genannten Fehler. Betroffen ist davon Traefik. (Das ist ein HTTP-Reverse-Proxy für Microservices und Container-Umgebungen.) Dort ist das Problem bekannt und wurde vorgestern mit Traefik Version 3.6.1 behoben.
Wenn Sie also ein Update auf die neueste Docker-Version durchführen, müssen Sie in compose.yaml für die Traefik-Version 3.6.1 oder einfach 3 oder latest angeben. Denken Sie daran, vor einem Neustart der Container ein Update des Traefek-Images mit docker pull traefik zu erledigen!
sudo apt full-upgrade -y
cd /mein/projekt/verzeichnis
docker pull traefik
docker compose down
docker compose up -d
Wenn Sie meinen vorigen Blogbeitrag über Hetzner-Cloud-Benchmarks gelesen haben, ist Ihnen vielleicht aufgefallen, dass ich Alma Linux 10 in einer Hetzner-Cloud-Instanz ausgeführt habe, um dort Geekbench-Tests auszuführen. Das war nicht so einfach: Hetzner bietet Alma Linux 10 noch nicht als Installations-Image an. (Update 3.7.2025: mittlerweile schon, sowohl AlmaLinux 10 als auch Rocky Linux 10)
Also habe ich eine neue Instanz zuerst mit Alma Linux 9 eingerichtet und danach mit Elevate ein Update auf Version 10 durchgeführt. Das ist erstaunlich unkompliziert gelungen, obwohl Version-10-Updates eigentlich noch im Beta-Test sind.
Update 10.7.2025: Version-10-Updates werden jetzt offiziell unterstützt (Quelle)
Was ist LEAPP, was ist Elevate?
RHEL und alle Klone durchlaufen über reguläre Updates alle Minor-Releases. Wenn Sie also Alma Linux 9.0 installiert haben, erhalten Sie durch die regelmäßige Installation von Updates nach und nach die Versionen 9.1, 9.2 usw. Ein Update auf die nächste Major-Version ist aber nicht vorgesehen.
Mit LEAPP hat Red Hat ein Framework geschaffen, um Major-Version-Updates für RHEL durchzuführen. LEAPP wurde sehr allgemeingültig konzipiert und kümmert sich um Pre-Upgrade-Kontrollen, Paketabhängigkeiten, den Workflow zwischen verschiedenen Stadien des Upgrades usw.
Elevate ist eine Community-Erweiterung zu LEAPP, die über das eigentliche Upgrade hinaus in manchen Fällen auch einen Wechsel der Paketquellen zwischen Alma Linux, CentOS, Oracle Linux und RockyLinux durchführen kann. Sie können mit Elevate beispielsweise zuerst von CentOS 7 zu RockyLinux 8 migrieren und dann weiter zu Rocky Linux 9 upgraden.
Mögliche Migrationspfade für »Elevate« (Stand: Juni 2026, Bildquelle: https://wiki.almalinux.org/elevate/ELevate-quickstart-guide.html)
Vorbereitungsarbeiten
Bevor Sie Elevate anwenden, müssen Sie ein vollständiges Backup durchführen und Ihren Rechner bzw. Ihre virtuelle Maschine neu starten:
dnf update
reboot
Danach richten Sie eine Paketquelle für Elevate ein und installieren das für Sie relevante Upgrade-Modul (für das Beispiel in diesem Artikel mit der Zieldistribution Alma Linux also leapp-data-almalinux).
dnf install -y http://repo.almalinux.org/elevate/elevate-release-latest-el$(rpm --eval %rhel).noarch.rpm

# für AlmaLinux
dnf install leapp-upgrade leapp-data-almalinux

# alternativ für Rocky Linux (etc.)
dnf install leapp-upgrade leapp-data-rocky
Als nächstes folgt ein Test, ob das gewünschte Upgrade (plus gegebenenfalls eine Migration zu einer anderen Distribution, hier nicht relevant) überhaupt möglich ist:
leapp preupgrade
leapp preupgrade erzeugt zwei Dateien: Einen umfassenden Bericht, der alle möglichen Probleme aufzählt, und eine answer-Datei, in die Sie gegebenenfalls Optionen eintragen müssen (z.B. mit leapp answer --section check_vdo.confirm=True). In meinem Fall — Upgrade einer Minimalinstallation von Alma Linux 9 auf 10, hat leapp preupgrade auf die folgenden Probleme hingewiesen, aber keine answer-Einträge verlangt.
High: veraltete Netzwerkkonfiguration in /etc/sysconfig/network-scripts
High: unbekannte Systemdateien (»Aktoren«)
High: unbekannte Pakete (hc-utils)
Medium: Berkeley DB (libdb) ist installiert, wird in RHEL 10 nicht mehr unterstützt
Low: unbekannten Paket-Repositories
cat /var/log/leapp/leapp-report.txt

  Risk Factor: high (inhibitor)
  Title: Legacy network configuration found
  Summary: Network configuration files in legacy "ifcfg" format are present ...
      - /etc/sysconfig/network-scripts/ifcfg-eth0
  Related links:
      - How to migrate the connection from ifcfg to NetworkManager keyfile plugin?:
        https://access.redhat.com/solutions/7083803
      - nmcli(1) manual, describes "connection migrate" sub-command.:
        https://networkmanager.dev/docs/api/latest/nmcli.html
      ...
  Remediation: [hint] Convert the configuration into NetworkManager native "keyfile" format.

  ----------------------------------------
  Risk Factor: high
  Title: Detected custom leapp actors or files.
  Summary: We have detected installed custom actors or files on the system.
    These can be provided e.g. by third party vendors ... This is allowed
    and appreciated. However Red Hat is not responsible for any issues caused
    by these custom leapp actors ...
  The list of custom leapp actors and files:
    - /usr/share/leapp-repository/repositories/system_upgrade/\
       common/files/distro/almalinux/rpm-gpg/10/RPM-GPG-KEY-AlmaLinux-10
    - /usr/share/leapp-repository/repositories/system_upgrade/\
      common/files/rpm-gpg/10/RPM-GPG-KEY-AlmaLinux-10

  ...
Den vollständigen Report können Sie sich hier durchlesen.
Migration der Netzwerkkonfiguration
Wirklich kritisch war aus meiner Sicht nur die Netzwerkkonfiguration; die restlichen Hinweise und Empfehlungen habe ich ignoriert. Das Paket hc-utils (Hetzner Cloud Utilities) ist nur für Funktionen relevant, die in meinem Fall ohnedies nicht genutzt werden (siehe hier).
Auch die veraltete Netzwerkkonfiguration stammt vom Hetzner-Image für Alma Linux 9. Eine Umstellung auf eine *.nmconnection-Datei für den NetworkManager gelingt erstaunlich unkompliziert mit einem einzigen Kommando:
Mit einem weiteren Reboot habe ich sichergestellt, dass die Umstellung auch funktioniert.
Das Upgrade
leapp upgrade initiiert nun das Upgrade auf Alma Linux 10. Dabei werden seitenweise Logging-Ausgaben produziert (siehe den kompletten Output mit ca. 3150 Zeilen):
leapp upgrade

  ==> Processing phase `configuration_phase` ...
  ==> Processing phase `FactsCollection` ...
  ...
  ==> Processing phase `TargetTransactionFactsCollection`
      Create custom repofile containing information about
      repositories found in target OS installation ISO, if used.
      Initializes a directory to be populated as a minimal environment
      to run binaries from the target system.

      AlmaLinux 10.0 - BaseOS                         5.9 MB/s | 2.8 MB     00:00
      AlmaLinux 10.0 - AppStream                       11 MB/s | 5.6 MB     00:00
      AlmaLinux 10.0 - CRB                            5.0 MB/s | 2.2 MB     00:00
      AlmaLinux 10.0 - HighAvailability               161 kB/s |  69 kB     00:00
      AlmaLinux 10.0 - Extras                          28 kB/s |  12 kB     00:00
      AlmaLinux 10.0 - SAP                            8.3 kB/s | 3.5 kB     00:00
      AlmaLinux 10.0 - SAPHANA                         35 kB/s |  15 kB     00:00
      AlmaLinux 10.0 - RT                             2.8 MB/s | 1.1 MB     00:00
      AlmaLinux 10.0 - NFV                            2.8 MB/s | 1.1 MB     00:00
      Dependencies resolved.

      ...
      Transaction Summary: Install  153 Packages
      ...
      Complete!

  ==> Processing phase `TargetTransactionCheck`
  ...
  Transaction Summary
  Install     63 Packages
  Upgrade    389 Packages
  Remove      18 Packages
  Downgrade    3 Packages
  Transaction test succeeded.
  Complete!

  ====> add_upgrade_boot_entry
        Add new boot entry for Leapp provided initramfs.

  A reboot is required to continue. Please reboot your system.

  Debug output written to /var/log/leapp/leapp-upgrade.log

  ============================================================
                        REPORT OVERVIEW
  ============================================================

  HIGH and MEDIUM severity reports:
      1. Packages not signed by Red Hat found on the system
      2. Detected custom leapp actors or files.
      3. Berkeley DB (libdb) has been detected on your system

  Reports summary:
      Errors:                      0
      Inhibitors:                  0
      HIGH severity reports:       2
      MEDIUM severity reports:     1
      LOW severity reports:        2
      INFO severity reports:       1

  Before continuing, review the full report below for details about discovered
  problems and possible remediation instructions:

      A report has been generated at /var/log/leapp/leapp-report.txt
      A report has been generated at /var/log/leapp/leapp-report.json

  ============================================================
                     END OF REPORT OVERVIEW
  ============================================================

  Answerfile has been generated at /var/log/leapp/answerfile
  Reboot the system to continue with the upgrade. This might take a while
  depending on the system configuration.
  Make sure you have console access to view the actual upgrade process.
Jetzt wird es unheimlich: Mit reboot starten Sie die nächste Phase des Upgrade-Prozesses, der im Blindflug erfolgt. Der Rechner bzw. die virtuelle Maschine wird während dieser Phase noch einmal neu gestartet. Wenn Sie nicht vor dem Rechner sitzen, sehen Sie weder, was passiert, noch haben Sie über eine SSH-Verbindung die Möglichkeit, einzugreifen.
reboot
Wenn alles gut geht, können Sie sich nach ein paar Minuten wieder einloggen. Bei mir hat es funktioniert:
Ich habe mit diesem Experiment erreicht, was ich haben wollte: eine funktionierende, minimale Alma-Linux-10-Installation in einer im Internet erreichbaren virtuellen Maschine. Ich kann damit experimentieren. Vermutlich wird Hetzner in ein paar Wochen Alma Linux 10 als reguläres Cloud-Installations-Image anbieten. Dann werde ich diese Installation vermutlich wieder abschalten.
In der Vergangenheit habe ich Elevate auch schon auf lokale virtuelle Maschinen mit (nicht besonders wichtigen) Testumgebungen angewendet, ebenfalls zu meiner Zufriedenheit.
Aber ich würde mich niemals trauen, für ein produktiv wichtiges System auf diese Weise ein Upgrade oder womöglich eine Migration auf eine andere Distribution durchzuführen — und schon gar nicht, wenn ich keinen physischen Zugriff auf die Installation habe. Es kann dabei so viel schief gehen! Es ist unklar, ob danach überhaupt eine Reparatur möglich ist, und wenn ja, wie lange diese dauern würde.
Vergessen Sie zuletzt nicht, dass das Upgrade von Alma Linux 9 auf Version 10 aktuell noch im Beta-Test ist. Bei meinem Minimalsystem hat es funktioniert, aber das ist keine Garantie, dass das bei Ihnen auch klappt!
Kurz und gut: Die Kombination aus LEAPP und Elevate bietet eine großartige Möglichkeit, Major Upgrades für RHEL und seine Klone durchzuführen. Das ist ideal für Entwicklungs- und Testsysteme. Aber wie bei jedem Linux-Distributions-Upgrade kann dabei viel schief gehen. Der sichere Weg für produktiv wichtige Installationen ist immer eine Neuinstallation! Sie können dann in aller Ruhe sämtliche Funktionen testen, zum Schluss die Daten migrieren und mit minimaler Downtime eine Umstellung durchführen.

 Anmelden